EOBデータをExcelに一括抽出
医療請求チーム向けノーコードガイド
ちょうど8日前のr/HealthInsuranceで、医療請求の専門家なら誰もが一度は抱いたことのある質問が投稿されました。「保険請求と医師からの請求書を照合しようとしているのに、数字がいつも合わない気がする」。そのスレッドの回答は、多くの小規模診療所がすでに行っていることを説明しています。請求番号、CPTコード、請求額、保険支払額を各EOBから1フィールドずつ手入力する手作業のスプレッドシートです。機能はします。しかし、収益サイクルの中で最も時間のかかるステップでもあります。BCBS、Aetna、UnitedHealthcare、Medicareから毎日20〜30件のEOBを処理する小規模診療所では、それぞれ形式が異なるため、同じ8つのフィールドを照合用スプレッドシートに再入力する作業に毎日2〜3時間かかります。データはすでにページに明確に印刷されています。ボトルネックは、それをページからスプレッドシートに移すことです。
重要ポイント
- 毎日2〜3時間 — 請求担当者がEOBから請求番号、CPTコード(医療処置の標準的な数字識別子)、金額を読み取り、スプレッドシートに再入力します。この作業には判断力は一切不要で、5つの異なる保険者レイアウトにわたって168回繰り返されます。
- BCBSが予告なくEOBレイアウトを変更すると — 実際に起こります — すべてのテンプレートベース抽出ツールが静かに誤ったデータを生成し、請求担当者は照合スプレッドシートのバランスが取れなくなって初めてエラーに気づきます。
- 意味抽出 — 位置ではなくラベルの意味を読むこと — により、ImageToTable.aiは5つの保険者からの12件のEOBを1つのExcelファイルに処理し、その2〜3時間を値の再入力から拒否パターンや過少支払いの分析に振り向けることができます。
EOBに記載されている内容 — 照合に必要なフィールドはどれか
EOB(保険金支払明細書)は請求書ではありません。これは保険会社が特定の請求をどのように処理したかを説明する明細書です。医療機関が請求した金額、保険会社の契約レートで認められた金額、保険会社が支払った金額、そして患者が負担すべき金額(ある場合)が記載されています。どの保険者のEOBでも、同じ取引を説明しているため、論理構造は同じです。標準的なEOBに記載されている内容と、照合に実際に必要なフィールドは以下のとおりです。
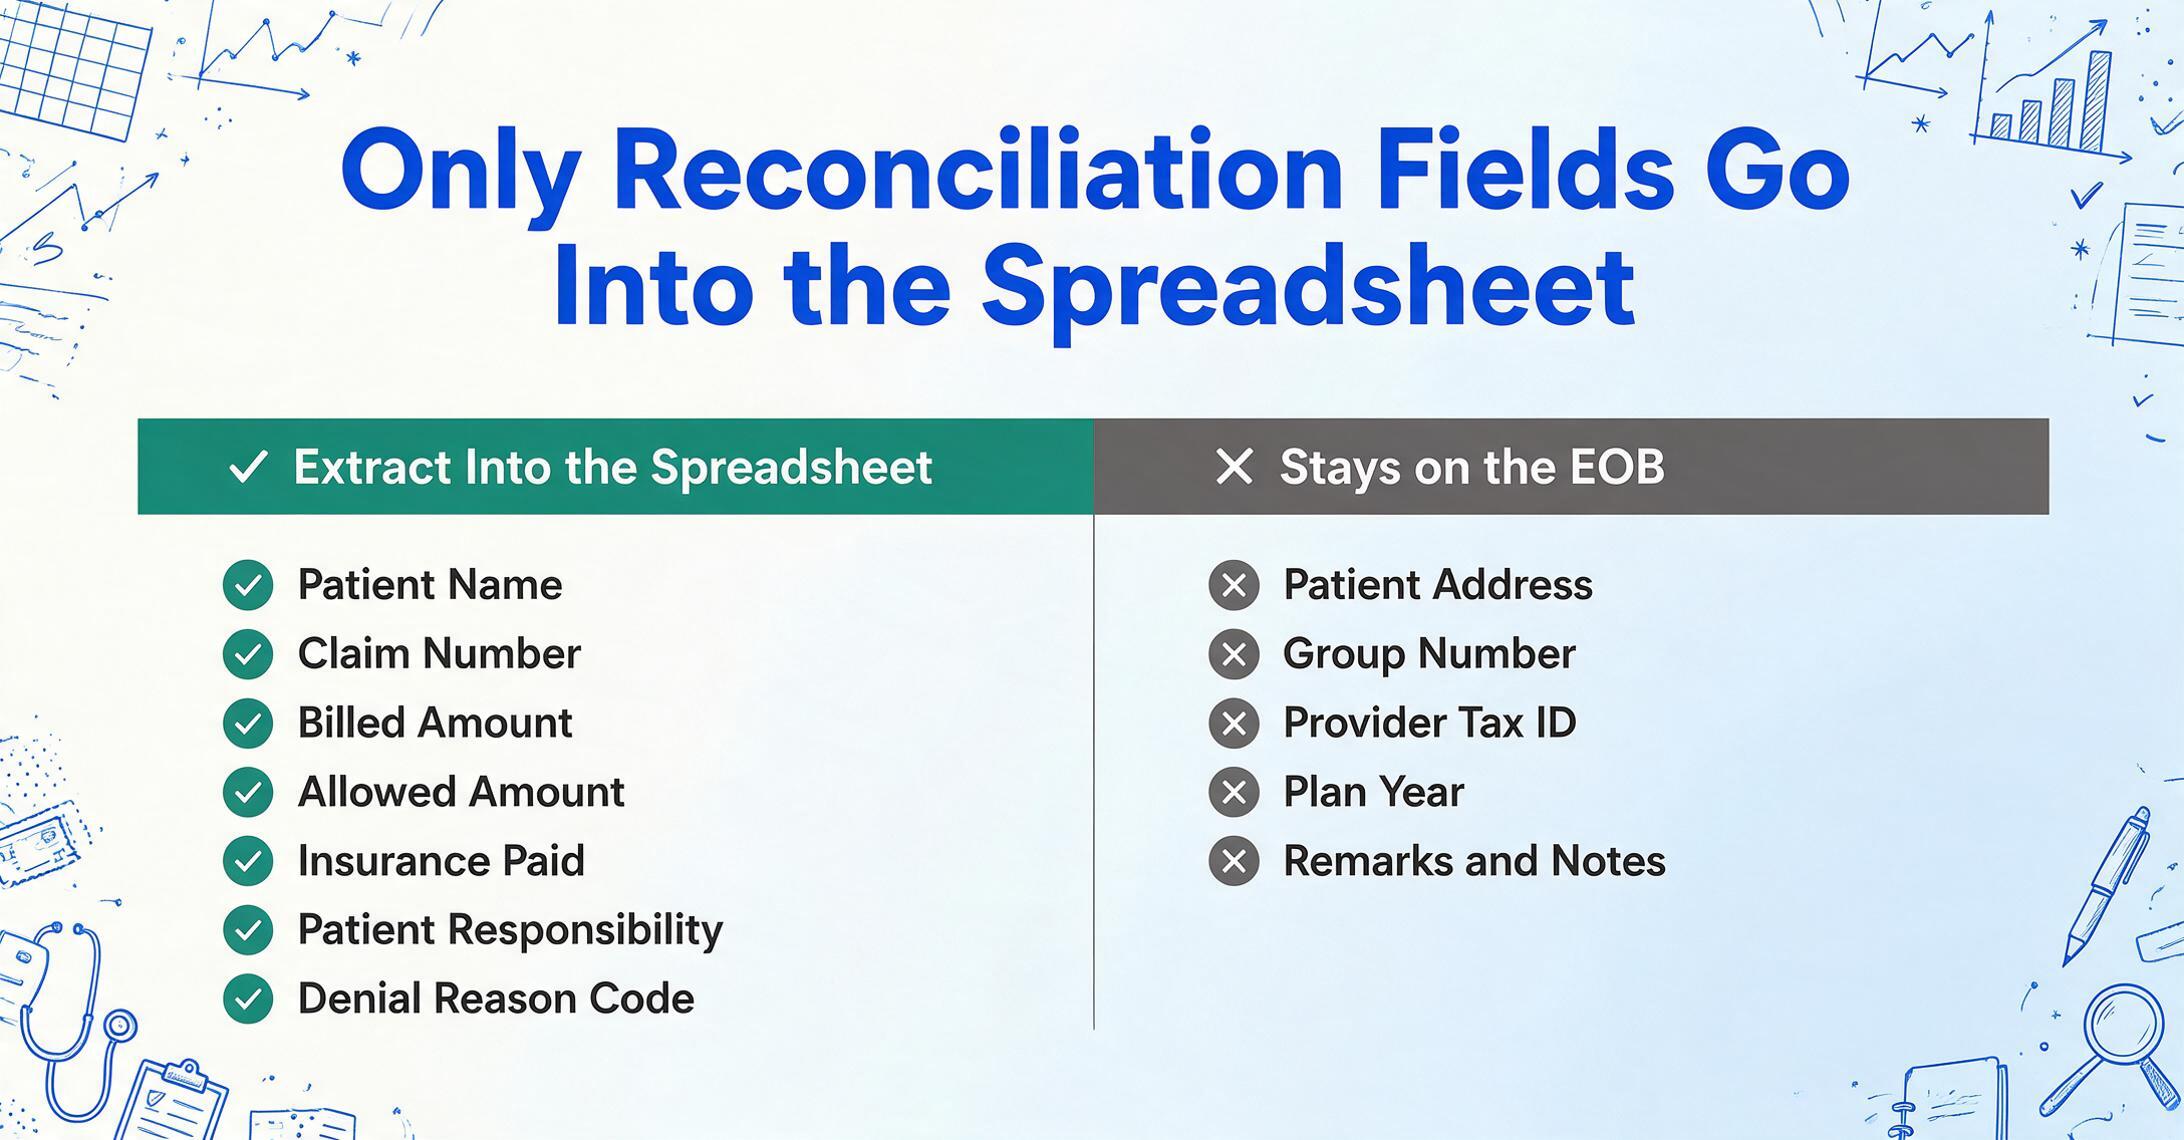
コア照合フィールド(すべてのEOBから抽出する項目):
患者名  |  加入者ID  |  請求番号
診療日  |  医療機関名  |  CPTコード
請求額  |  保険適用額  |  保険支払額
免責額適用  |  自己負担額  |  患者負担額
拒否・調整理由コード  |  請求ステータス(支払済み/拒否/調整済み)
参照専用フィールド(EOBには記載されているが、抽出しない参考情報):
患者住所  |  グループ番号  |  医療機関税ID
備考  |  プラン年度  |  請求受領日
参照専用フィールドはEOBに残ります。コア照合フィールドはスプレッドシートに入力する項目で、どの保険者でも同じフィールドです。BCBSは「Claim #」と呼び、Aetnaは「Claim ID」と呼び、Medicareは「ICN(内部管理番号)」を使用します。3つのラベル、1つの概念、スプレッドシートの1つの列。ラベルの違い — データの違いではなく — が、EOB抽出を見た目よりも難しくしているのです。
EOBとERA(電子送金通知)の違いに注目する価値があります。ERAは、同じデータを機械可読形式で含む電子ANSI 835ファイルです。クリアリングハウスを通じてERAを受け取っている診療機関では、データはすでに構造化されており、抽出は不要です。しかし、多くの中小保険者 — および一部の大手保険者も特定のプランタイプでは — 依然として紙またはPDFのEOBを送付しています。また、ERAを電子的に受け取っている診療機関でも、二次請求、労災保険、自動車保険については紙のEOBを受け取っています。紙からスプレッドシートへのギャップは以前より縮まっていますが、まだ解消されていません。
EOBの構造は概念上は予測可能です。患者、請求、コード、金額です。しかしレイアウトは予測不能です。BCBSが右上に印刷する請求番号を、Aetnaは左側のヘッダーブロックに印刷します。UHCがテーブルの列に記載するCPTコードを、Medicareは同じ行に他の6つのデータポイントと一緒に「サービス詳細」セクションに埋め込みます。フィールドは同じです。位置が違うだけです。それが問題のすべてです。
なぜ保険者ごとにEOBの見た目が異なるのか — そしてそれがテンプレートベース抽出を機能不全にする理由
3年前のr/HealthInsuranceのRedditスレッドは、そのフラストレーションを正確に捉えています。あるカップル — そのうちの1人はプロとして医療ソフトウェアを開発していた — がEOBを追跡するためのスプレッドシートを作ろうとして断念しました。彼らが述べた問題はこうです。「使えるもので、実際に記入する気になれるものと、すべてを追跡できるが50列もあって誰も記入したがらないもののバランスを取ろうとして行き詰まった」。彼らの結論はこうです。「一般的なコンセンサスは、追跡と照合の責任をすべて消費者に押し付けることのようです」。医療業界向けソフトウェアを構築した人でさえ、スプレッドシートでEOB追跡問題を解決できませんでした。スプレッドシートが間違っていたからではなく、データを入力するにはタイピングが必要で、そのタイピング自体が問題だったからです。
根本原因は手続き上の問題ではなく構造上の問題です。テンプレートベース抽出ツール — 「請求番号は1ページ目の座標(x, y)にある」とマークする必要がある種類のツール — は、EOBを扱う際に組み合わせ爆発的な問題に直面します。BCBS、Aetna、UHC、Cigna、Medicareに請求する小規模な診療所は、少なくとも5つの異なるレイアウトを扱うことになります。各保険者に2〜3種類のEOBバリアント(異なるプランタイプ、異なる州、異なる保険タイプ)がある場合、構築・維持すべきテンプレートの数は急速に増えていきます。BCBSがEOB形式を変更すると — それは通常予告なく発生します — BCBS用に設定されたすべてのテンプレートが静かにエラーを生成し始めます。請求担当者が気付くのは、照合の数字が合わなくなったときです。
このメンテナンス負担を回避する代替アプローチは意味抽出です。ツールに各フィールドがページのどこにあるかを指示する代わりに、必要な情報を指示すると、ラベルの意味を理解することで一致するデータを見つけ出します。「請求番号」という列名は、AIに請求に関連する識別子を文書内で検索するよう指示します。それが「Claim #」「Claim ID」「ICN」「Reference Number」のいずれのラベルであってもです。AIは位置ではなく意味を読み取るため、同じ列定義でBCBSのEOBとMedicareの送金通知の両方を処理できます。
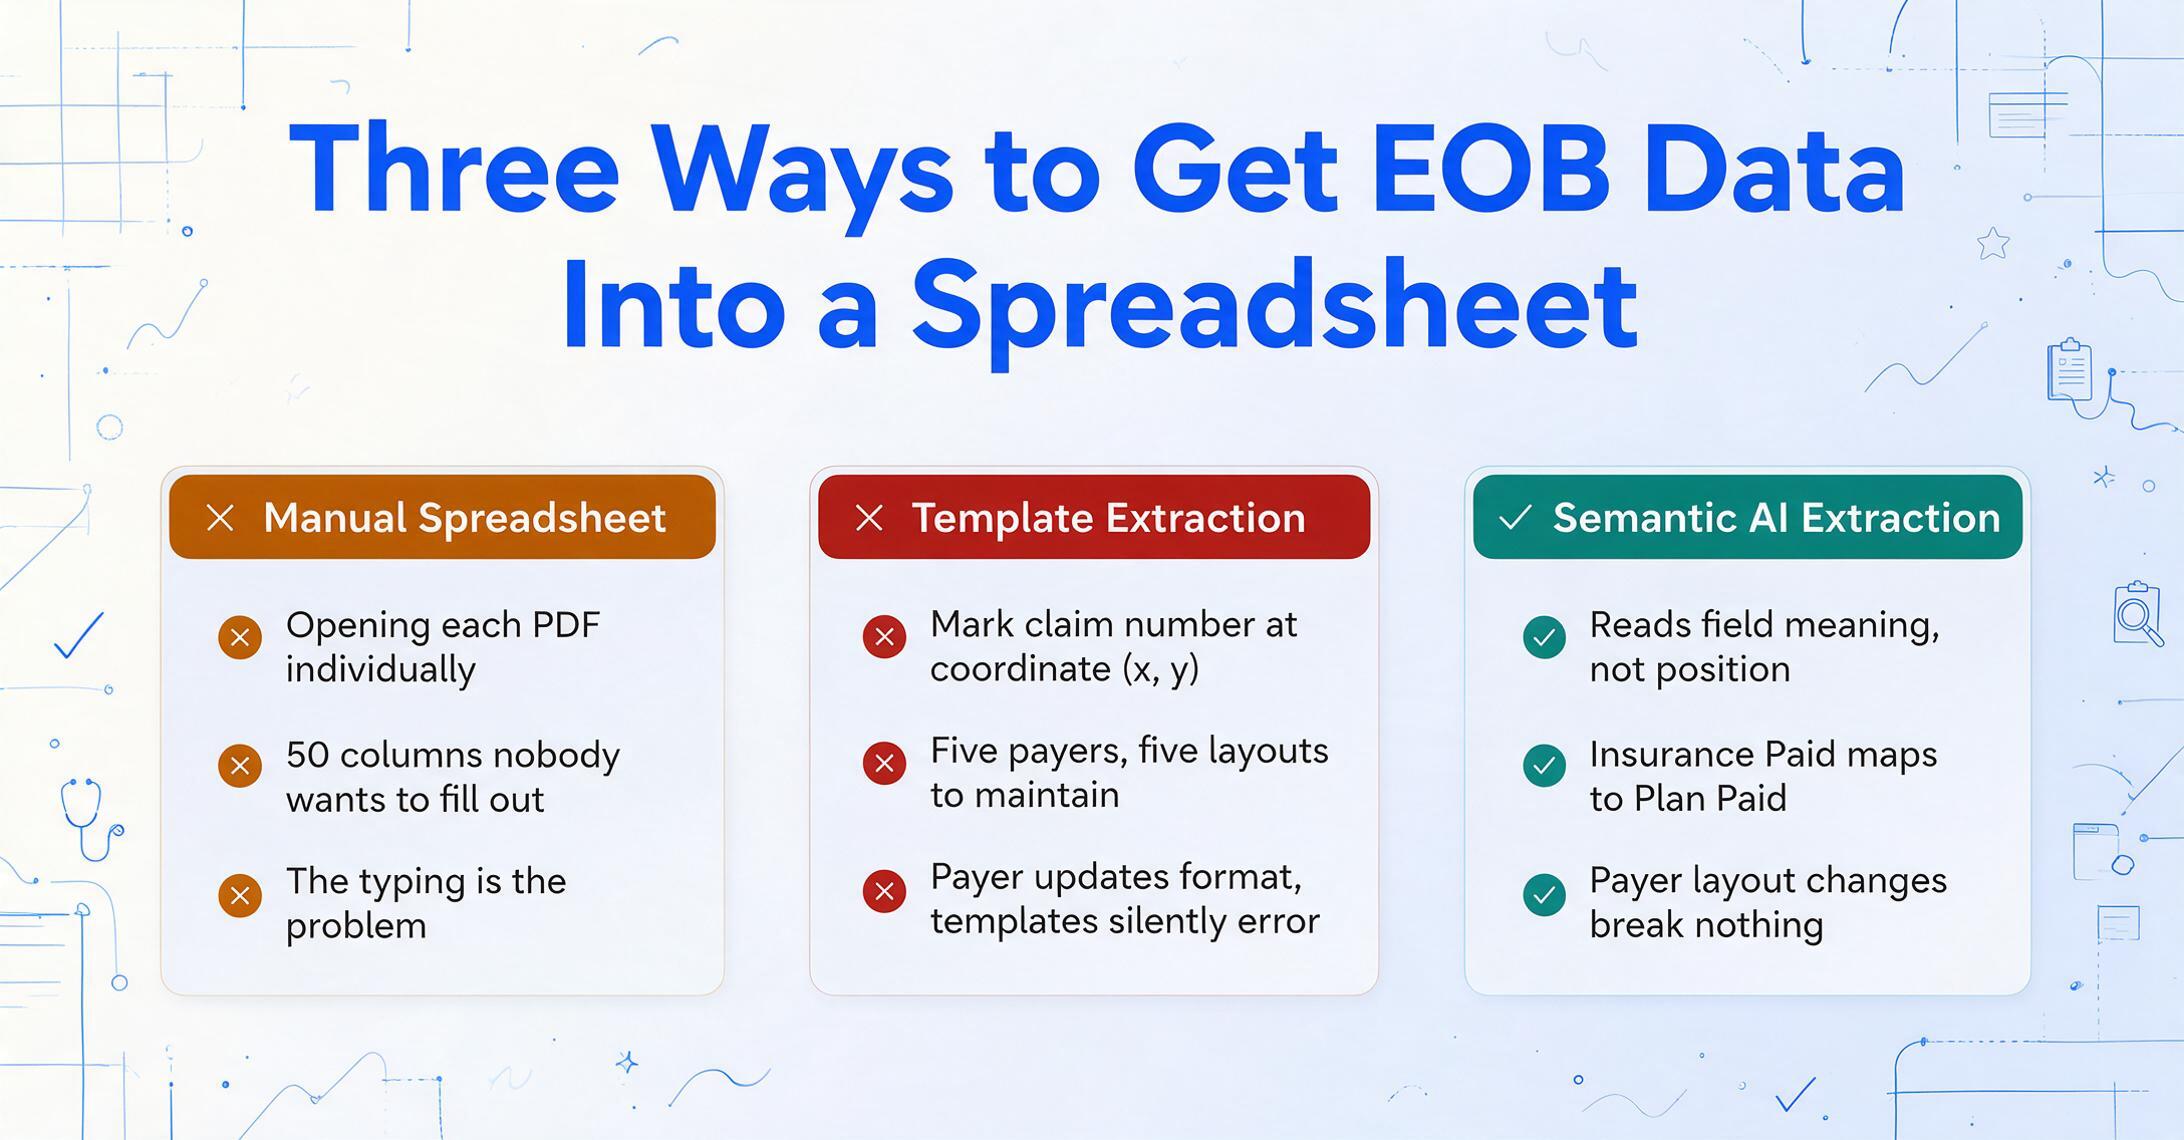
抽出列を一度定義するだけで、あらゆる保険者のEOBに適用
ワークフローは、出力列の定義から始まります。これらはスプレッドシートで使う列名であり、抽出されたExcelファイルの列ヘッダーになります。一度定義してテンプレートとして保存すれば、すべてのバッチで再利用できます:
患者名  |  加入者ID  |  保険者名
請求番号  |  診療日  |  医療機関名
CPTコード  |  修飾語  |  診断コード(ICD-10)
請求額  |  保険適用額  |  保険支払額
免責額適用  |  自己負担額(Coinsurance)  |  自己負担額(Copay)
患者負担額  |  拒否理由コード  |  拒否内容
請求ステータス  |  支払日
列名が具体的であれば、AIは各フィールドを曖昧さなく特定できます。「請求額」と「保険適用額」は、「金額1」や「金額2」とは異なり明確に区別されます。一方で、保険者の用語の違いを超えて対応できるほど汎用的でもあります。「保険支払額」は「プラン支払額」「保険者支払額」「キャリア支払額」など、あらゆる表記に対応します。AIが意味的な等価性を理解しているからです。
時間の節約が実感できるのは、バッチアップロードのときです。請求担当者が朝の郵便を開けると、EOBが12通あります:BCBSが4通、Aetnaが3通、UHCが2通、Cignaが2通、Medicareが1通です。各PDFを個別に開いてスプレッドシートに値を入力する代わりに、12通すべてを1回のアップロードにドロップします。AIは各文書を個別に読み取り、すべての請求データを同じ列構造にマッピングします。出力は、請求ごとに1行、合計12行の1つのExcelファイルとして届き、列は定義したとおりに正確に入力されます。この正確なワークフロー(アップロード、列定義、1つの統合スプレッドシート)は、EOBからExcelへのデモページで実際にご覧いただけます。
手動での検証ステップは、手入力よりも速くなります。12 × 14 = 168個の値をゼロから入力する代わりに、請求担当者は元のEOBとスプレッドシートを見比べて、抽出された値が一致しているか確認します。正しい値には何もする必要がありません。不確かな値や確認フラグが付いた値は、元の文書とすぐに照合します。標準的なEOBレイアウトに明確に印刷されている患者名、日付、コード文字列、金額など、ほとんどのフィールドでは、抽出の信頼性が高いため、検証は再入力ではなくスキャンで済みます。
拒否コードと調整理由 — 次のアクションを左右する詳細情報の取得
EOB(保険金支払明細書)の請求額・保険適用額・保険支払額といった財務項目を見れば、請求が全額支払われたかどうかはわかります。しかし、拒否コードと調整理由コードは、その理由、つまり不服申し立てをするのか、修正するのか、患者に請求するのかを判断する材料になります。これらのコードはEOB上で最も実用的な情報でありながら、手入力の際に見落とされやすい項目でもあります。
保険会社は請求調整に標準化されたコードセットを使用します。金銭的調整にはCARC(請求調整理由コード)、追加の説明にはRARC(送金通知備考コード)、さらに一部の保険者が独自に使う拒否コードもあります。一般的なEOBでは、これらのコードが最終ページの「請求調整詳細」や「備考コード」というセクションに8ポイントの小さな文字で印刷されています。午後に20件のEOBを照合する請求担当者は、すべてのEOBのすべてのコードを読むわけではありません。スピード重視で処理しているため、コードは見落とされがちです。しかし、そのコードによって「拒否 — 修正請求が必要」なのか「拒否 — 患者負担、患者に請求」なのかが決まり、次のアクションが大きく異なります。
AI抽出はこれらのコードを体系的に取得します。「拒否理由コード」と「拒否内容」の列を定義することで、手動レビューで人間が見落としたかもしれないコードも含め、すべてのEOBのすべてのコードがスプレッドシートに取り込まれます。請求担当者が取るべきアクションを判断するのは変わりませんが、抽出によってコードがスキップされることはなくなります。時間が経つにつれ、バッチ全体でこれらのコードを集計するとパターンが見えてきます。特定のCPTコードが特定の保険者から頻繁に拒否されている場合、コーディングの問題か、診療所が知らなかった保険者の方針が示唆されます。EOB抽出ワークフロー全体の詳細(6,000レイアウトの問題とAIの読み取り方法を含む)については、EOBデータ抽出の完全ガイドをご覧ください。また、抽出ツールを並べて比較する準備ができたら、医療文書抽出ツールの総合比較で、実際の複数保険者EOBを使った7つのツールのテスト結果をご確認いただけます。
抽出から照合へ — スプレッドシートが次のステップをどう動かすか
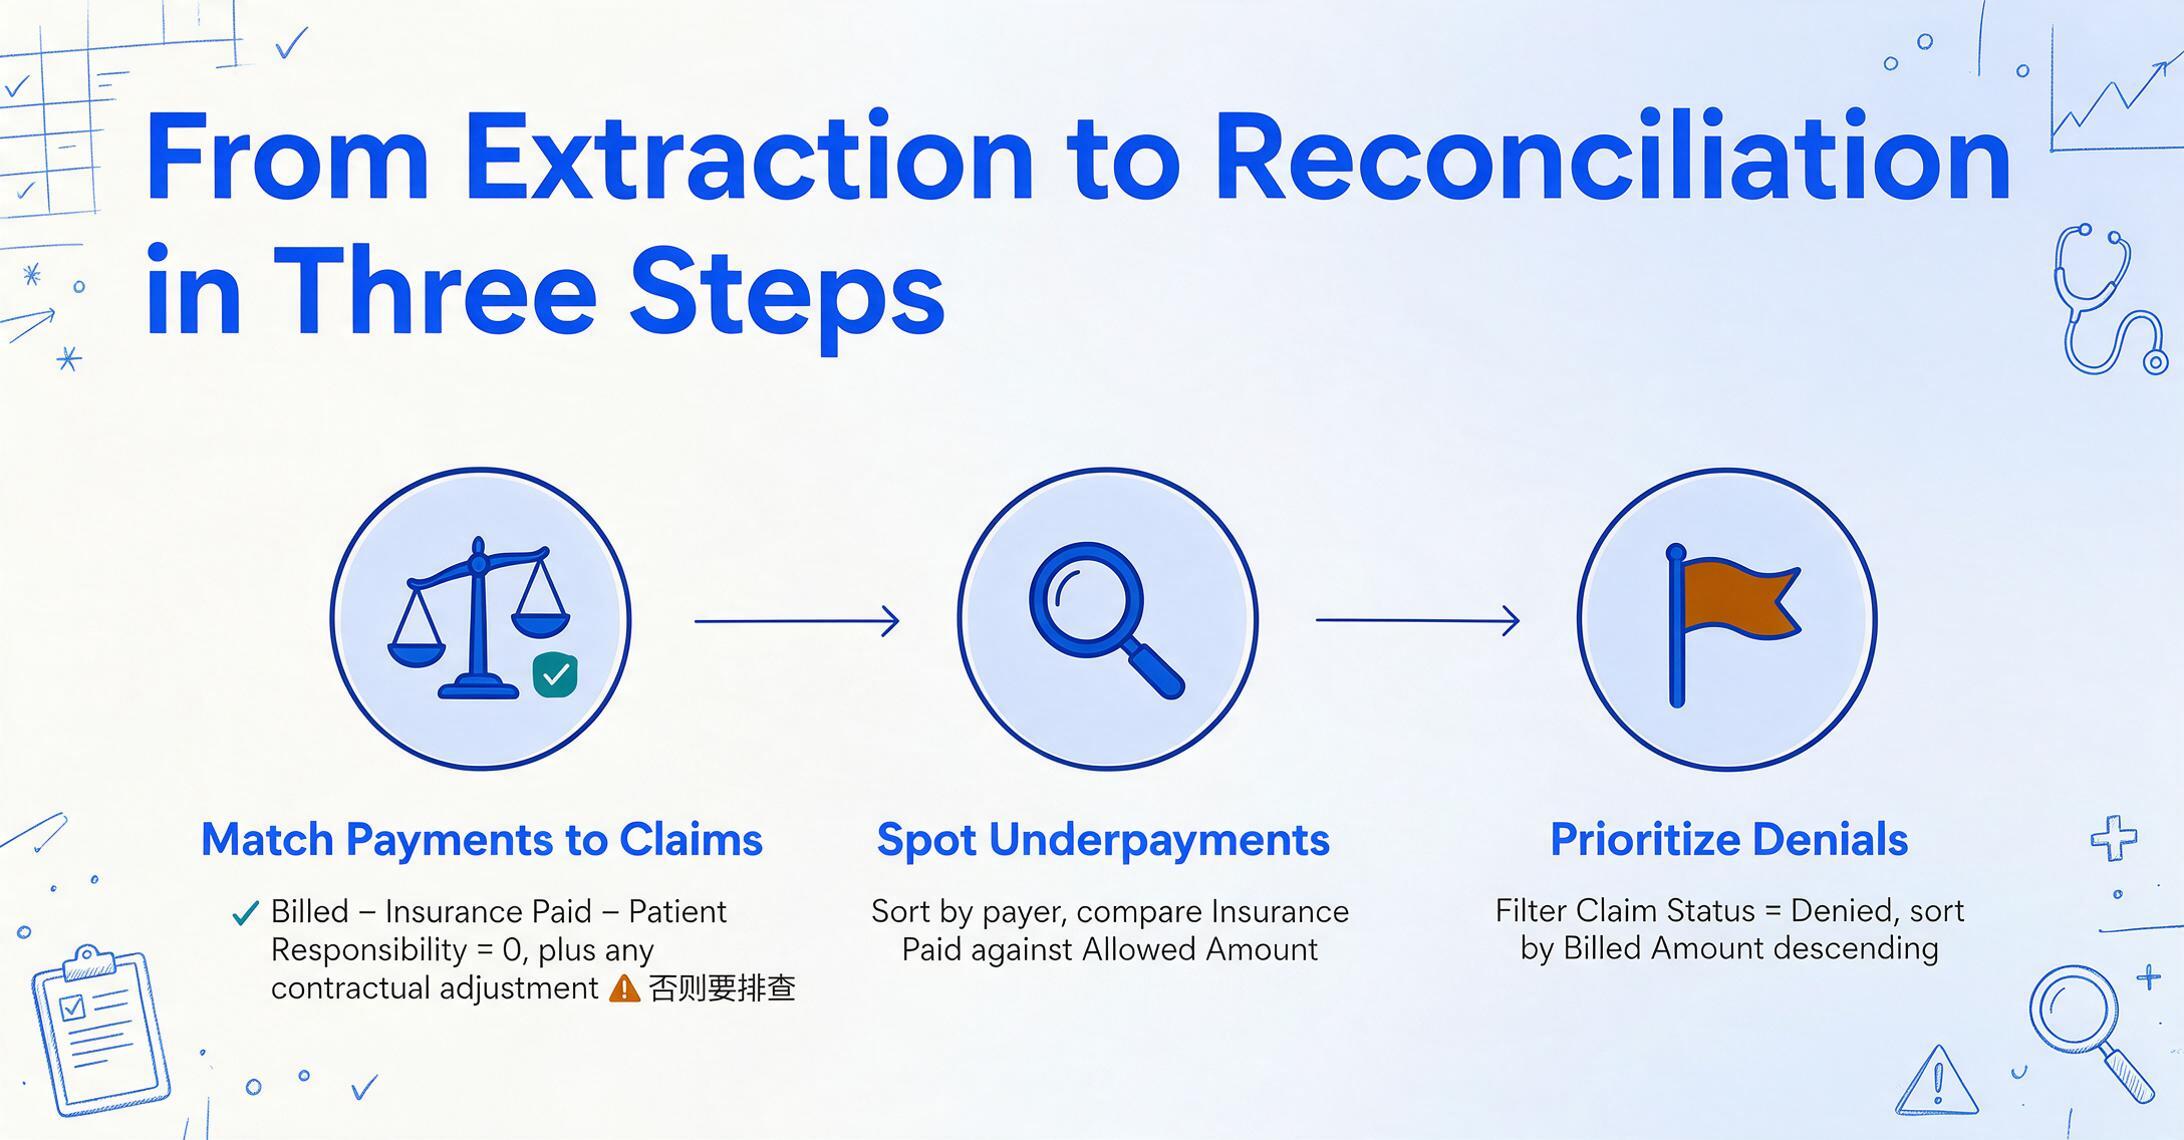
EOBデータの抽出は、照合ワークフローへの入力です。ここでは、請求担当者が保険支払額と期待額を照合します。抽出されたデータを手にした場合の流れは次のとおりです。
支払いと請求の照合。 抽出されたスプレッドシートには、請求ごとに1行のデータがあり、請求額、保険適用額、保険支払額、患者負担額の列があります。簡単な計算式 — 請求額から保険支払額と患者負担額を引いたもの — が、契約調整額を加えてゼロになれば問題ありません。ゼロにならない場合は、その請求の調査が必要です。請求担当者が従来、2つの書類(EOBと元の請求書)を頭の中で行っていた計算が、1つのシートの1行で確認できるようになります。
過少支払いパターンの特定。 スプレッドシートを保険者別に並べ替え、「保険支払額 vs. 保険適用額」の列を確認します。BCBSが特定のCPTコードに対して保険適用額の80%を一貫して支払っているのに、特定の日付以降は同じコードで60%しか支払っていない場合、それは通知されなかった診療報酬表の更新であり、フォローアップの機会です。手入力では、データが個々のEOB PDFに分散しているため、こうしたパターンは見えません。並べ替えやフィルタリングが可能な表には存在しないからです。
拒否フォローアップの優先順位付け。 スプレッドシートを請求ステータス = 「拒否」でフィルタリングし、請求額の降順で並べ替えます。高額な拒否請求がすぐに表示されます — EOBの山を探す必要はありません。各行には拒否理由コードが含まれているため、請求担当者は電話を取る前に、修正請求の提出、追加書類の提供、コーディング判断への異議申し立てのいずれが必要かを把握できます。フォローアップリストは自動的に作成されます。
患者残高の追跡。 患者負担額の列を請求全体で合計し、患者ごとにフィルタリングすると、診療管理システムからデータを取得することなく、最新の患者残高レポートが得られます。PMシステムに堅牢なレポート機能がない小規模な診療所にとって、これは数分で作成できる軽量な代替手段です。
1つ注目すべき点: r/HospitalBillsのアドバイスでは、EOBと支払いの追跡方法を尋ねる人に対して「はい、スプレッドシートが最適です」と答えています。その回答は手入力を前提としています — しかし、スプレッドシート自体は正しいツールです。このRedditの推奨とこのワークフローの違いは、データが事前に入力された状態で届き、請求担当者の時間が入力ではなく分析とフォローアップに使われることです。
スプレッドシートはボトルネックではありません。以前からそうでした。ボトルネックは、担当者がBCBSのEOBから「請求番号 2026BC0047291」を読み取り、セルB4に「2026BC0047291」と入力するステップです。そのステップをなくしても、請求担当者の判断力が不要になるわけではありません — 判断力が必要な作業に振り向けられるのです。
FAQ
主要な保険者すべてのEOBに対応していますか?
はい。AIはテンプレートのレイアウトを照合するのではなく、各フィールドの意味を理解してEOBを読み取るため、BCBS、Aetna、UnitedHealthcare(UHC)、Cigna、Humana、Medicare、Medicaid、Tricare、労災保険のEOBを保険者ごとの設定なしで処理できます。「保険支払額」という列名は、BCBSのEOBでは「Plan Paid」、AetnaのEOBでは「Amount Paid by Carrier」、Medicareの送金通知では「Medicare Paid」に自動的にマッピングされます。これらが同じ意味であることをAIが理解しているからです。新しい保険者を追加する際に設定は不要で、保険者がEOBのレイアウトを変更しても何も壊れません。
EOBの下部に小さく印刷された調整コードもAIは読み取れますか?
はい — これはAI抽出が手作業レビューと最も異なる点の一つです。調整理由コード(CARC、RARC)や保険者固有の拒否コードは、最終ページの下部に小さな文字で印刷されることが多く、請求担当者が20枚のEOBを処理する際に目を通すだけで詳細に確認しないことがあるセクションです。AIはこれらを標準のテキストフィールドとして読み取り、請求データとともに専用の列に抽出します。これは拒否への対応判断を自動化するものではありません — 請求担当者が各コードを評価し、適切な対応を決定します — しかし、人間のレビュー担当者が気づいたコードだけでなく、すべてのコードが確実に取得されます。
1つの請求が複数ページにまたがる複数ページのEOBはどうですか?
AIは文書全体を個別のページではなく、連続したストリームとして読み取ります。BCBSのEOBで1つの請求のサービス詳細が2ページ目と3ページ目にまたがる場合、AIはページ境界をまたいでデータを途切れることなく追跡します。1ページ目の請求番号は、同じ文書を共有しているため、2ページ目のCPTコードと3ページ目の支払金額に関連付けられます — AIはページ区切りでコンテキストを失いません。複数ページのEOBが5枚含まれるバッチアップロードでは、すべてのページのすべての請求が行ごとに整理された1つの出力ファイルが生成され、担当者がページを分離したり並べ替えたりする必要はありません。
これは、紙のEOBの代わりに電子ERAを使用する場合とどう違うのですか?
貴院がクリアリングハウスを通じてERA(ANSI 835電子送金通知ファイル)を受け取っている場合、それらはすでに構造化されたデータファイルであり、抽出は不要です。そのまま診療管理システムに転記できます。EOB抽出は、引き続き受け取るPDFや紙の明細書を対象としています。二次保険者のEOB、労災保険の説明書、自動車保険の請求、患者からの請求コピー、電子送金を送信しない保険者などです。多くの診療所では、電子ERAが請求の70〜80%をカバーし、残りの20〜30%はPDFで届きます。データ入力時間の不均衡な割合を消費するのは、この少数派です。抽出が対象とするのは、まさにこの部分です。
抽出中、患者データは安全に取り扱われますか?
EOBにはPHI(保護対象保健情報)が含まれており、それに応じて取り扱う必要があります。抽出用にアップロードされたファイルはメモリ内で処理され、転送中は暗号化され、処理完了後に削除されます。ただし、抽出ツールのデータ取り扱い方法はさまざまです。第三者サービスを通じてEOBを処理する前に、そのサービスの暗号化基準、データ保持ポリシー、および貴院がHIPAAコンプライアンス文書を必要とする場合にBAA(ビジネスアソシエイト契約)を提供しているかどうかを確認してください。厳格なデータ所在地要件がある診療所の場合は、ファイルをローカルで処理するツールや、HIPAA準拠の処理を提供するツールの使用を検討してください。
医療機関用コピーだけでなく、患者向けEOBも処理できますか?
はい。患者向けのEOBには、医療機関用コピーと同じフィールド(請求番号、診療日、CPTコード、費用明細)が含まれていますが、多くの場合、説明文を添えた簡略化されたレイアウトになっています。複数の医療機関や保険者にまたがって自分のEOBを追跡している患者は、同じ列名抽出アプローチを使用して、「医療機関名」「診療日」「請求額」「保険支払額」「患者負担額」の列を定義できます。出力により、患者は照合機能を利用できます。これは、Redditの議論からも明らかなように、保険会社が患者に期待しているものの、実行するためのツールを提供していない機能です。