EOB-Daten im Batch nach Excel extrahieren
No-Code-Leitfaden für Abrechnungsteams
Auf r/HealthInsurance erst vor acht Tagen stellte jemand eine Frage, die sich jeder Abrechnungsspezialist schon einmal gestellt hat: „Ich habe das Gefühl, ich versuche ständig, Versicherungsansprüche mit Arztrechnungen abzugleichen, und die Zahlen wollen einfach nie übereinstimmen.“ Die Antworten in diesem Thread beschreiben, was die meisten kleinen Praxen bereits tun – eine manuelle Tabellenkalkulation, in die jemand Claim-Nummern, CPT-Codes, berechnete Beträge und Versicherungszahlungen aus jeder EOB eintippt, Feld für Feld. Es funktioniert. Es ist aber auch der langsamste Schritt im Umsatzzyklus. Für eine kleine Praxis, die täglich 20 bis 30 EOBs von BCBS, Aetna, UnitedHealthcare und Medicare verarbeitet – jede anders formatiert –, verschlingt das erneute Abtippen derselben acht Felder in eine Abgleich-Tabelle zwei bis drei Stunden pro Tag. Die Daten stehen bereits klar gedruckt auf der Seite. Der Engpass ist die Übertragung von der Seite in die Tabellenkalkulation.
Die wichtigsten Erkenntnisse
- Zwei bis drei Stunden täglich – ein Abrechnungsspezialist liest Claim-Nummern, CPT-Codes (die standardisierten numerischen Kennungen für medizinische Verfahren) und Dollar-Beträge von EOBs ab und tippt sie in eine Tabellenkalkulation, ein Schritt, der keinerlei Urteilsvermögen erfordert und sich 168-mal über fünf verschiedene Kostenträger-Layouts wiederholt.
- Wenn BCBS sein EOB-Layout ohne Vorankündigung ändert – was vorkommt –, produzieren alle vorlagenbasierten Extraktionstools stillschweigend falsche Daten, und der Abrechnungsspezialist entdeckt die Fehler erst, wenn die Abgleich-Tabelle nicht mehr aufgeht.
- Semantische Extraktion – das Lesen von Beschriftungen nach Bedeutung statt nach Position – ermöglicht es ImageToTable.ai, 12 EOBs von fünf Kostenträgern in eine Excel-Datei zu verarbeiten und diese zwei bis drei Stunden vom Abtippen von Werten auf die Analyse von Ablehnungsmustern und Unterzahlungen umzulenken.
Was auf einer EOB steht – und welche Felder für den Abgleich wichtig sind
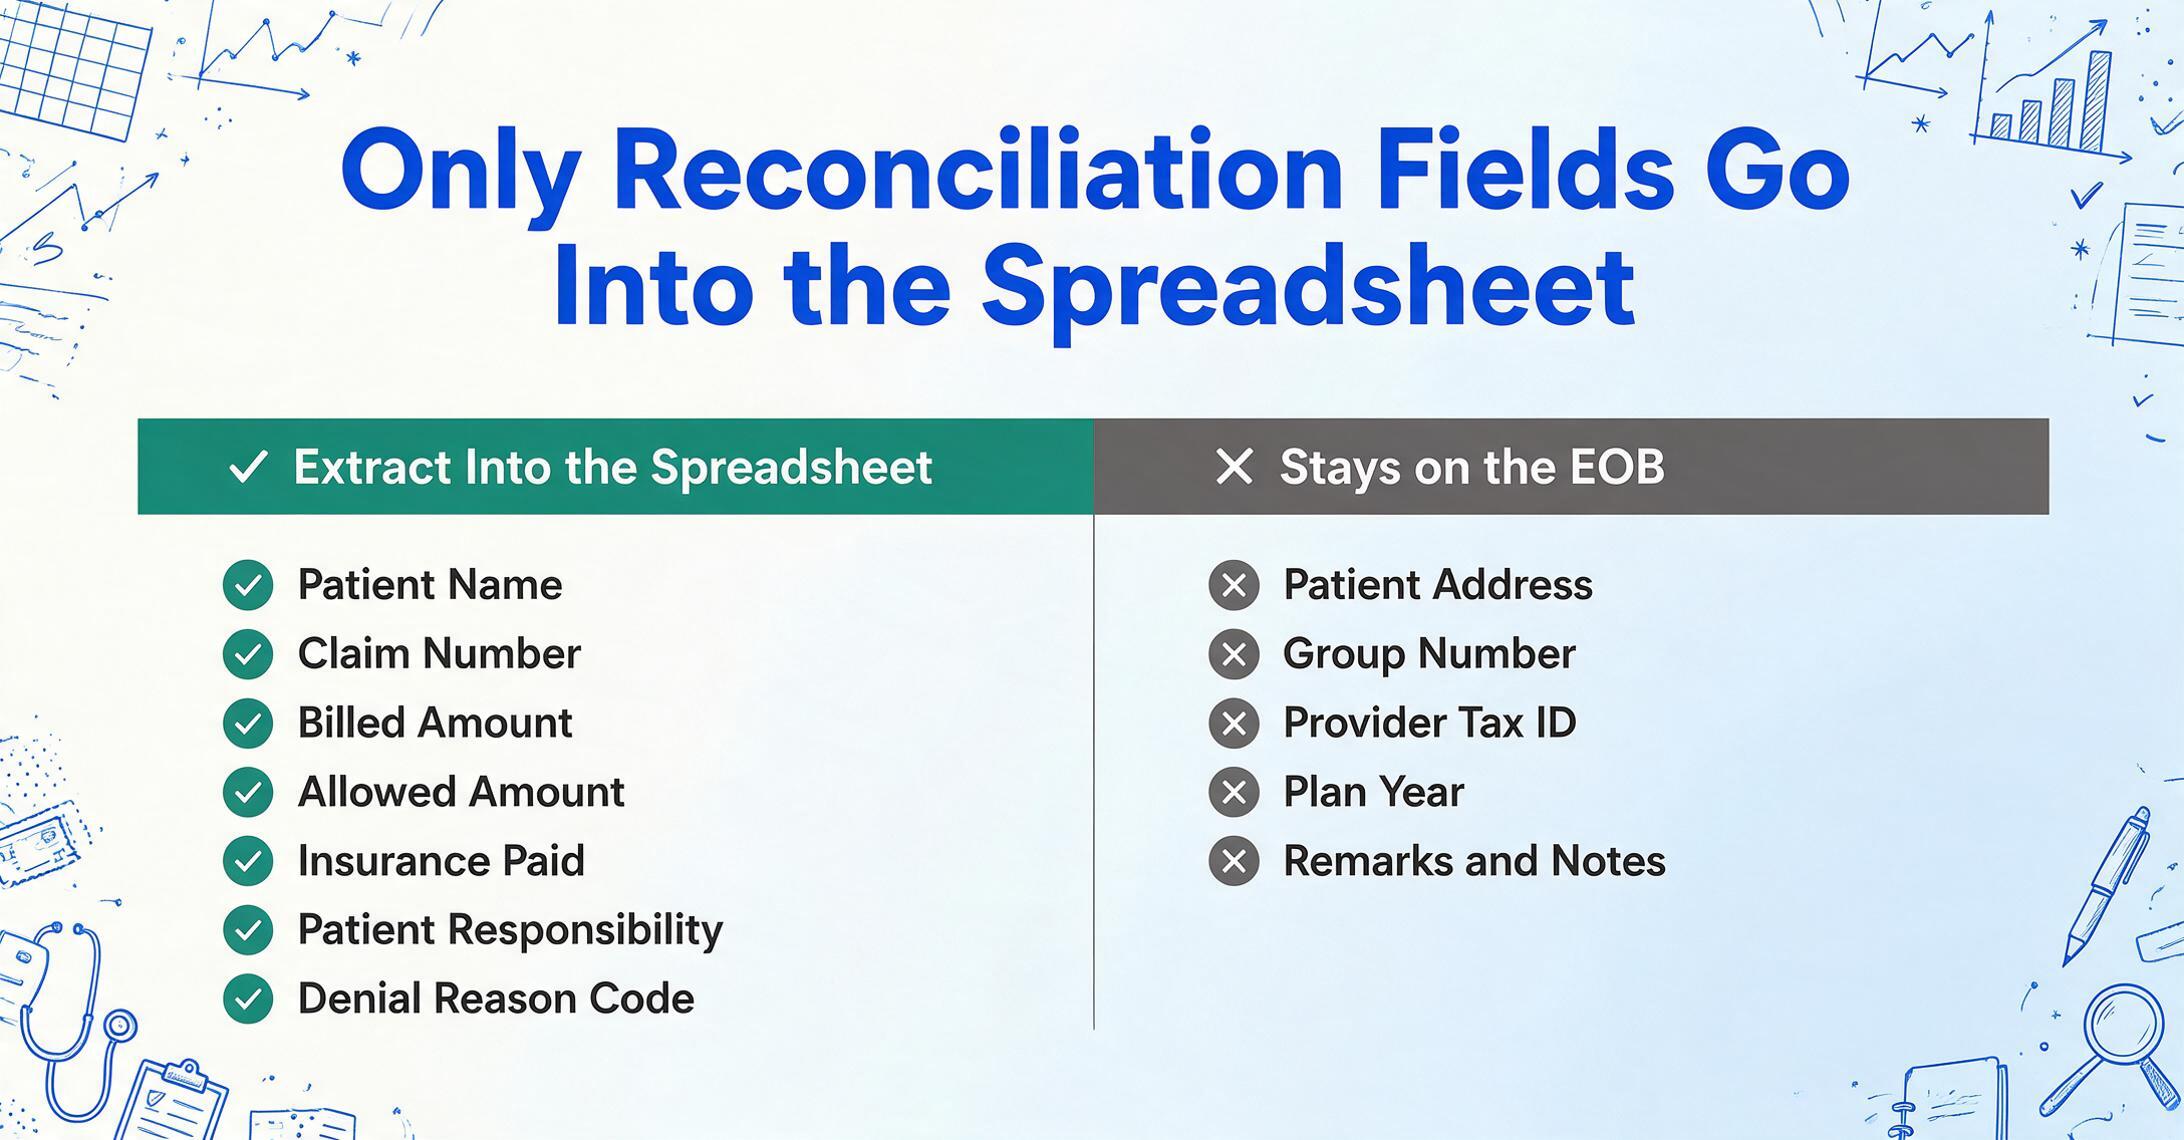
Eine EOB (Leistungserklärung) ist keine Rechnung. Es ist eine Aufstellung der Versicherungsgesellschaft, die erklärt, wie ein bestimmter Claim verarbeitet wurde: was der Leistungserbringer berechnet hat, was der vertraglich vereinbarte Satz des Versicherers zulässt, was die Versicherung gezahlt hat und was – falls überhaupt – der Patient schuldet. Jede EOB, unabhängig vom Kostenträger, enthält dieselbe logische Struktur, da sie dieselbe Transaktion beschreibt. Hier finden Sie, was auf einer Standard-EOB steht und welche Felder Sie tatsächlich für den Abgleich benötigen:
Kernfelder für den Abgleich (aus jeder EOB extrahieren):
Patientenname  |  Versicherten-ID  |  Claim-Nummer
Leistungsdatum  |  Leistungserbringer  |  CPT-Code
Berechneter Betrag  |  Erstattungsfähiger Betrag  |  Versicherungszahlung
Angewandte Selbstbeteiligung  |  Zuzahlung  |  Patientenanteil
Ablehnungs-/Anpassungsgrundcode  |  Claim-Status (Bezahlt / Abgelehnt / Angepasst)
Nur-Referenz-Felder (auf der EOB vorhanden, nützlicher Kontext, aber nicht extrahiert):
Patientenadresse  |  Gruppennummer  |  Steuer-ID des Leistungserbringers
Bemerkungen  |  Planjahr  |  Eingangsdatum des Claims
Die Nur-Referenz-Felder bleiben auf der EOB. Die Kernfelder für den Abgleich sind das, was Sie in die Tabelle eintippen – und sie sind bei jedem Kostenträger dieselben. BCBS nennt es „Claim-Nr.“ Aetna nennt es „Claim-ID“. Medicare verwendet „ICN“ (Interne Kontrollnummer). Drei Bezeichnungen, ein Konzept, eine Spalte in Ihrer Tabelle. Die Variation der Bezeichnungen – nicht die Variation der Daten – macht die EOB-Extraktion schwieriger, als sie aussieht.
Es ist erwähnenswert, den Unterschied zwischen einer EOB und einer ERA (Elektronische Zahlungsavise) zu beachten. Eine ERA ist die elektronische ANSI-835-Datei, die dieselben Daten in einem maschinenlesbaren Format enthält. Wenn Ihre Praxis ERAs über eine Clearingstelle erhält, sind die Daten bereits strukturiert und müssen nicht extrahiert werden. Aber viele kleinere Kostenträger – und einige größere für bestimmte Plantypen – senden weiterhin Papier- oder PDF-EOBs. Und selbst Praxen, die ERAs elektronisch erhalten, bekommen weiterhin Papier-EOBs für Sekundäransprüche, Berufsgenossenschaft und Kfz-Versicherung. Die Lücke zwischen Papier und Tabelle ist kleiner geworden, aber sie hat sich nicht geschlossen.
Die Struktur einer EOB (Leistungserklärung) ist vom Konzept her vorhersehbar – Patient, Claim, Codes, Beträge –, aber im Layout unvorhersehbar. Die Claim-Nummer, die BCBS oben rechts druckt, druckt Aetna in einem Kopfblock links. Den CPT-Code, den UHC in einer Tabellenspalte auflistet, vergräbt Medicare in einem Abschnitt „Service Details“ mit sechs anderen Datenpunkten in derselben Zeile. Die Felder sind dieselben. Die Positionen sind unterschiedlich. Das ist das ganze Problem.
Warum jede EOB jedes Kostenträgers anders aussieht – und warum das die vorlagenbasierte Extraktion zerbricht
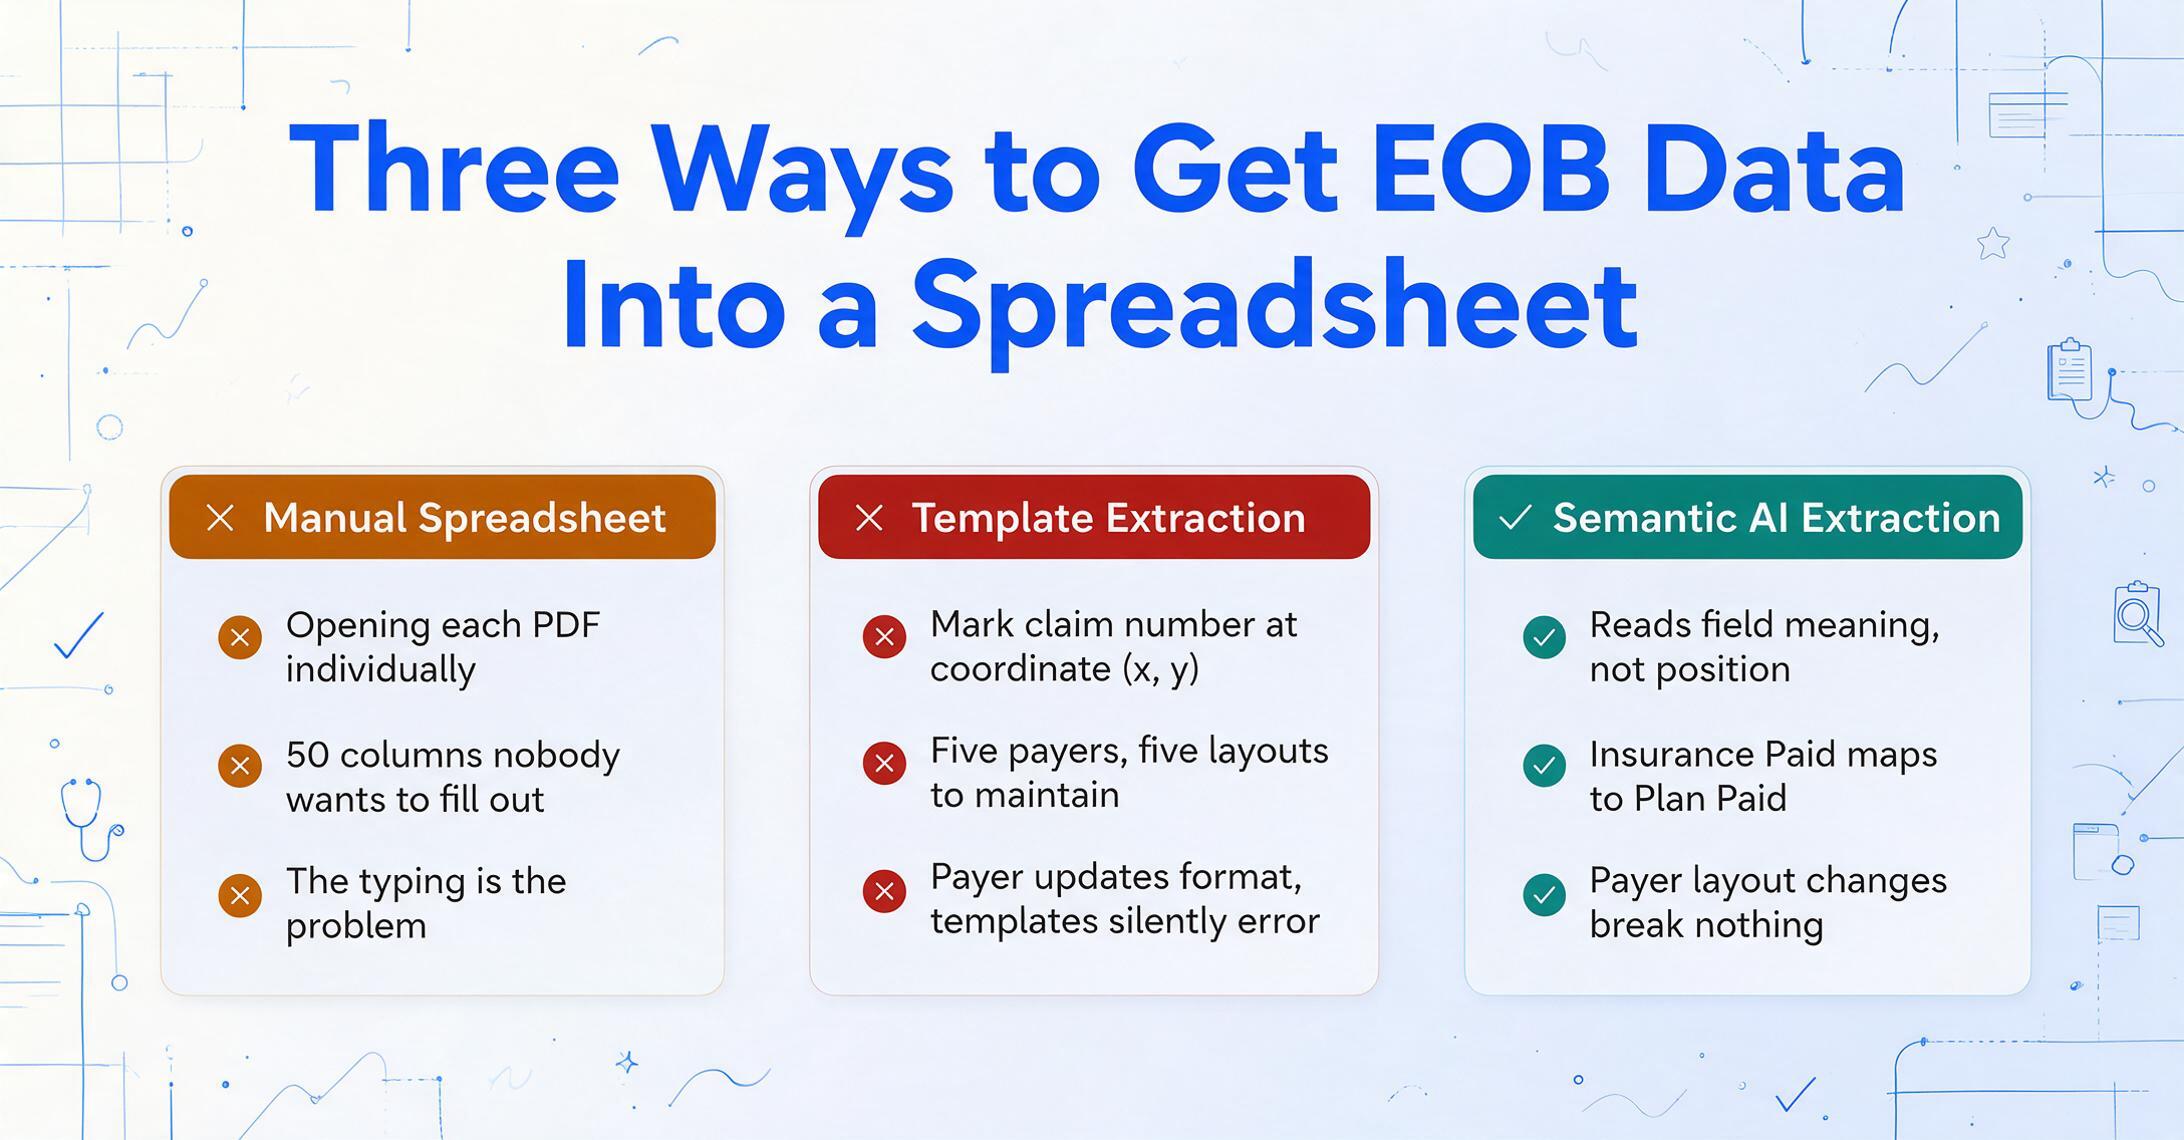
Ein Reddit-Thread von vor drei Jahren auf r/HealthInsurance fasst die Frustration präzise zusammen. Ein Paar – einer von ihnen hatte beruflich Gesundheitssoftware entwickelt – versuchte, eine Tabellenkalkulation zur Verfolgung ihrer EOBs aufzubauen, und gab auf. Das Problem, wie sie es beschrieben: „Wir stecken fest beim Versuch, etwas auszubalancieren, das nutzbar ist und das wir tatsächlich ausfüllen wollen, gegenüber etwas, das wirklich alles verfolgen kann, aber 50 Spalten hat und niemand ausfüllen will.“ Ihr Fazit: „Der allgemeine Konsens scheint zu sein, die gesamte Verantwortung für Verfolgung und Abgleich auf den Verbraucher abzuwälzen.“ Selbst jemand, der Software für die Gesundheitsbranche gebaut hatte, konnte das EOB-Tracking-Problem mit einer Tabellenkalkulation nicht lösen – nicht weil die Tabellenkalkulation falsch war, sondern weil das Eingeben von Daten Tipparbeit erforderte, und genau das Tippen war das Problem.
Die Ursache ist strukturell, nicht verfahrenstechnisch. Vorlagenbasierte Extraktionstools – die Art, die verlangt, dass Sie „Claim-Nummer ist bei Koordinate (x, y) auf Seite 1“ markieren – stehen bei EOBs vor einem kombinatorisch teuren Problem. Eine kleine Praxis, die mit BCBS, Aetna, UHC, Cigna und Medicare abrechnet, hat es mit mindestens fünf verschiedenen Layouts zu tun. Wenn jeder Kostenträger zwei oder drei EOB-Varianten hat (verschiedene Plantypen, verschiedene Bundesstaaten, verschiedene Versicherungsarten), multipliziert sich die Anzahl der zu erstellenden und zu pflegenden Vorlagen schnell. Wenn BCBS sein EOB-Format ändert – was vorkommt, typischerweise ohne Vorankündigung –, beginnt jede für BCBS konfigurierte Vorlage stillschweigend Fehler zu produzieren. Die Abrechnungsspezialistin merkt es erst, wenn die Abgleichzahlen nicht mehr aufgehen.
Der alternative Ansatz, der diese Wartungslast vermeidet, ist die semantische Extraktion: Statt dem Tool zu sagen, wo jedes Feld auf der Seite sitzt, sagen Sie ihm, welche Informationen Sie möchten, und es findet die passenden Daten, indem es versteht, was die Beschriftungen bedeuten. Der Spaltenname „Claim-Nummer“ sagt der KI, im Dokument nach einer beliebigen Kennung zu suchen, die mit einem Claim verbunden ist – ob sie nun „Claim #“, „Claim-ID“, „ICN“ oder „Referenznummer“ heißt. Die KI liest nach Bedeutung, nicht nach Position, weshalb sie eine BCBS-EOB und eine Medicare-Zahlungsavise mit derselben Spaltendefinition verarbeitet.
Definieren Sie Ihre Extraktionsspalten einmal – und wenden Sie sie auf die EOB jedes Kostenträgers an
Der Workflow beginnt mit der Definition der Ausgabespalten. Dies sind die Spaltennamen, die Sie in einer Tabellenkalkulation verwenden würden – und sie werden zu den Spaltenüberschriften in der extrahierten Excel-Datei. Definieren Sie sie einmal, speichern Sie sie als Vorlage und verwenden Sie sie für jeden Batch erneut:
Patientenname  |  Versicherten-ID  |  Kostenträger
Claim-Nummer  |  Leistungsdatum  |  Leistungserbringer
CPT-Code  |  Modifikator  |  Diagnosecode (ICD-10)
Berechneter Betrag  |  Erstattungsfähiger Betrag  |  Versicherungszahlung
Angewandte Selbstbeteiligung  |  Zuzahlung  |  Zuzahlung
Patientenanteil  |  Ablehnungsgrundcode  |  Ablehnungsbeschreibung
Claim-Status  |  Zahlungsdatum
Die Spaltennamen sind spezifisch genug, damit die KI jedes Feld eindeutig lokalisieren kann – „Berechneter Betrag" unterscheidet sich von „Erstattungsfähiger Betrag" auf eine Weise, wie es „Betrag 1" und „Betrag 2" nicht wären – aber allgemein genug, um sie auf die Terminologie der Kostenträger abzubilden. „Versicherungszahlung" passt zu „Plan Paid", „Amount Paid by Insurer", „Carrier Paid" und jeder anderen Variante, weil die KI die semantische Äquivalenz versteht.
Der Batch-Upload ist der Punkt, an dem sich die Zeitersparnis materialisiert. Ein Abrechnungsspezialist öffnet die Morgenpost – 12 EOBs: vier BCBS, drei Aetna, zwei UHC, zwei Cigna, eine Medicare. Anstatt jede PDF-Datei einzeln zu öffnen und Werte in eine Tabellenkalkulation zu tippen, lädt er alle 12 in einen einzigen Upload. Die KI liest jedes Dokument unabhängig und ordnet die Daten jedes Claims derselben Spaltenstruktur zu. Die Ausgabe erfolgt als eine Excel-Datei mit 12 Zeilen – eine pro Claim – und die Spalten sind genau wie definiert ausgefüllt. Sie können diesen genauen Workflow in Aktion sehen – Upload, Spalten, eine konsolidierte Tabellenkalkulation – auf unserer EOB-zu-Excel-Demoseite.
Der manuelle Verifizierungsschritt ist schneller als die manuelle Eingabe. Anstatt 12 × 14 = 168 Werte von Grund auf einzutippen, scannt der Abrechnungsspezialist die Tabellenkalkulation gegen die ursprünglichen EOBs und überprüft, ob die extrahierten Werte übereinstimmen. Ein korrekter Wert erfordert keine Aktion. Ein Wert, der unsicher ist oder zur Überprüfung markiert wurde, wird schnell gegen das Quelldokument geprüft. Bei der Mehrheit der Felder – Patientennamen, Daten, Codestrings, Dollar-Beträge, die in Standard-EOB-Layouts klar gedruckt sind – ist die Extraktion zuverlässig genug, dass die Verifizierung ein Scan und kein erneutes Abtippen ist.
Ablehnungs- und Anpassungsgründe — Die Details erfassen, die über das weitere Vorgehen entscheiden
Die finanziellen Felder auf einer EOB (Leistungserklärung) — berechneter Betrag, erstattungsfähiger Betrag, Versicherungszahlung — zeigen dem Abrechnungsspezialisten, ob der Claim vollständig bezahlt wurde oder nicht. Die Ablehnungs- und Anpassungscodes zeigen ihnen warum — und ob Einspruch eingelegt, angepasst oder der Patient in Rechnung gestellt werden sollte. Diese Codes sind die umsetzbarsten Informationen auf der EOB und werden bei der manuellen Eingabe am leichtesten übersehen.
Versicherungsunternehmen verwenden standardisierte Codesätze für Claim-Anpassungen: CARC (Claim-Anpassungsgrundcodes) für finanzielle Anpassungen, RARC (Zahlungsavise-Bemerkungscodes) für zusätzliche Erläuterungen und proprietäre Ablehnungscodes, die einige Kostenträger selbst erfinden. Eine typische EOB listet diese möglicherweise auf der letzten Seite, in einem Abschnitt mit der Bezeichnung „Claim-Anpassungsdetails“ oder „Bemerkungscodes“, in 8-Punkt-Schrift gedruckt. Ein Abrechnungsspezialist, der an einem Nachmittag 20 EOBs abgleicht, liest möglicherweise nicht jeden Code auf jeder EOB — sie verarbeiten schnell, und die Codes sind leicht zu überspringen. Aber der Code ist der Unterschied zwischen „abgelehnt — korrigierter Claim erforderlich“ und „abgelehnt — Patientenanteil, Patient in Rechnung stellen“ — zwei sehr unterschiedliche nächste Schritte.
KI-Extraktion erfasst diese Codes systematisch. Durch die Definition von Spalten für „Ablehnungsgrundcode“ und „Ablehnungsbeschreibung“ stellt die Extraktion sicher, dass jeder Code auf jeder EOB in die Tabelle übernommen wird, unabhängig davon, ob eine Person ihn bei der manuellen Prüfung bemerkt hätte. Der Abrechnungsspezialist entscheidet weiterhin, welche Maßnahme ergriffen wird — aber die Extraktion garantiert, dass kein Code übersprungen wird. Im Laufe der Zeit zeigt die Aggregation dieser Codes über Stapel hinweg Muster auf: Ein bestimmter CPT-Code wird von einem bestimmten Kostenträger häufiger abgelehnt, was auf ein Kodierungsproblem hindeutet — oder auf eine Kostenträgerrichtlinie, die der Praxis nicht bekannt war. Für eine ausführlichere Anleitung zum vollständigen EOB-Extraktionsworkflow — einschließlich des Problems mit 6.000 Layouts und wie KI diese liest — siehe unseren vollständigen Leitfaden zur EOB-Datenextraktion. Und wenn Sie bereit sind, Extraktionstools nebeneinander zu vergleichen, testet unser Überblick über Tools zur Extraktion von Gesundheitsdokumenten sieben Tools an echten EOBs von mehreren Kostenträgern.
Von der Extraktion zum Abgleich – So steuert die Tabelle den nächsten Schritt
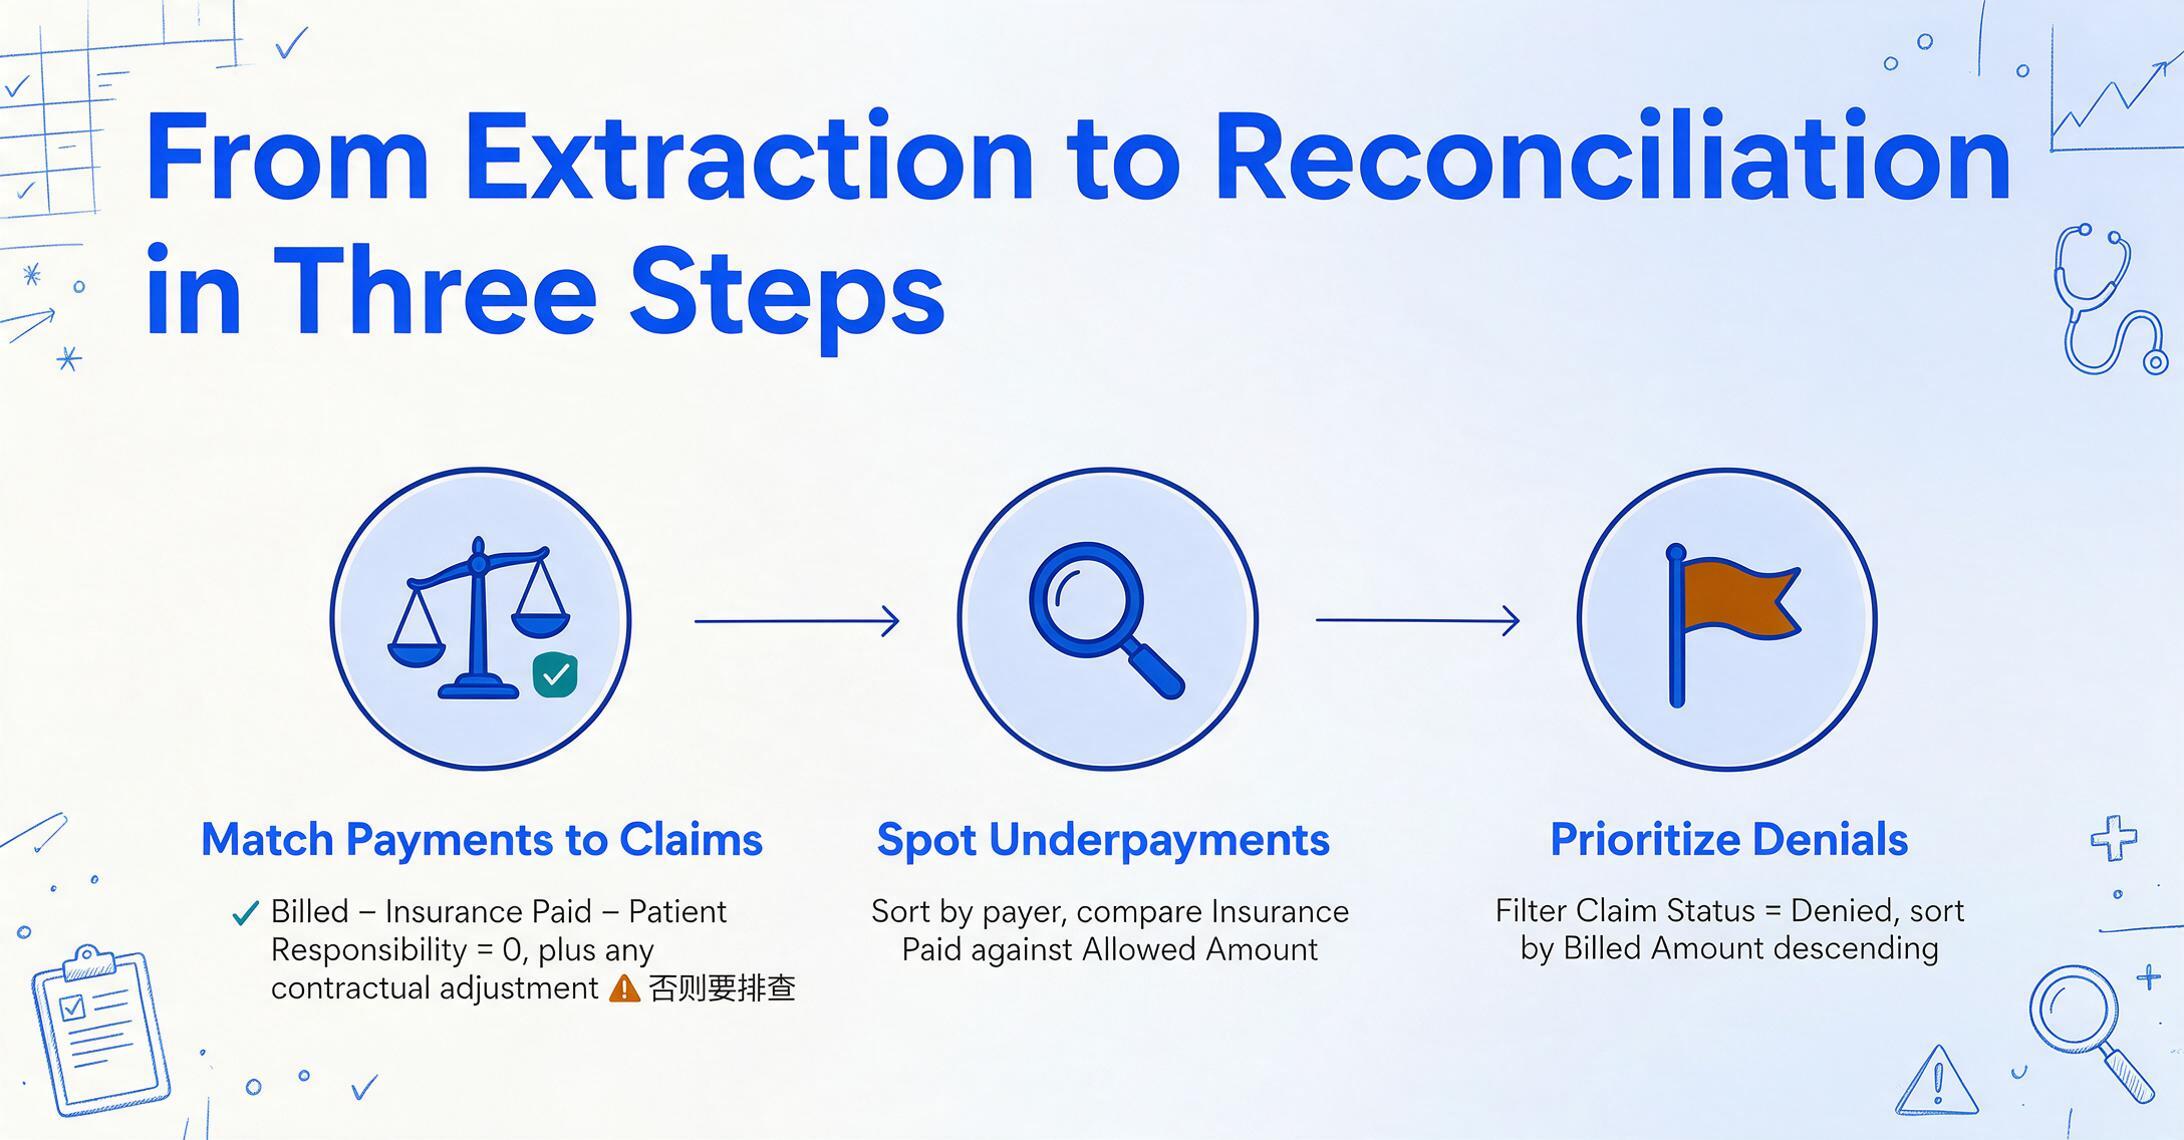
Die Extraktion der EOB-Daten ist der Input für den Abgleich-Workflow – der Schritt, in dem der Abrechnungsspezialist die Versicherungszahlungen mit den erwarteten Beträgen abgleicht. So sieht das mit den extrahierten Daten aus.
Zahlungen mit Claims abgleichen. Die extrahierte Tabelle enthält eine Zeile pro Claim mit Spalten für Berechneter Betrag, Erstattungsfähiger Betrag, Versicherungszahlung und Patientenanteil. Eine einfache Formel – Berechneter Betrag minus Versicherungszahlung minus Patientenanteil – sollte null ergeben, zuzüglich etwaiger vertraglicher Anpassungen. Ist das nicht der Fall, muss der Claim untersucht werden. Die Rechenarbeit, die ein Abrechnungsspezialist sonst im Kopf über zwei Dokumente (EOB und ursprünglichen Claim) hinweg leisten müsste, ist nun in einer einzigen Zeile auf einem einzigen Blatt sichtbar.
Unterzahlungsmuster erkennen. Sortieren Sie die Tabelle nach Kostenträger und prüfen Sie die Spalten „Versicherungszahlung vs. Erstattungsfähiger Betrag“. Wenn BCBS für einen bestimmten CPT-Code durchgängig 80 % des erstattungsfähigen Betrags zahlt, nach einem bestimmten Datum für denselben Code jedoch nur 60 %, handelt es sich um eine nicht kommunizierte Aktualisierung der Gebührenordnung – und eine Gelegenheit, nachzuhaken. Bei manueller Erfassung bleiben diese Muster unsichtbar, da die Daten in einzelnen EOB-PDFs liegen und nicht in einer sortier- und filterbaren Tabelle.
Ablehnungs-Nachfassungen priorisieren. Filtern Sie die Tabelle nach Claim-Status = „Abgelehnt“ und sortieren Sie absteigend nach Berechnetem Betrag. Die abgelehnten Claims mit dem höchsten Betrag erscheinen sofort – kein Durchwühlen von EOB-Stapeln. Jede Zeile enthält den Ablehnungsgrundcode, sodass der Abrechnungsspezialist bereits vor dem Telefonat weiß, ob ein korrigierter Claim eingereicht, zusätzliche Dokumentation bereitgestellt oder eine Kodierungsentscheidung angefochten werden muss. Die Nachfassliste schreibt sich von selbst.
Patientensalden verfolgen. Die Spalte Patientenanteil, über Claims summiert und nach Patient gefiltert, ergibt einen aktuellen Patientensaldo-Bericht, ohne Daten aus dem Praxisverwaltungssystem ziehen zu müssen. Für kleine Praxen, deren PM-System keine robuste Berichterstattung bietet, ist dies eine leichte Workaround-Lösung, die in wenigen Minuten erstellt ist.
Ein erwähnenswerter Punkt: Die Empfehlung auf r/HospitalBills, wenn jemand fragt, wie man EOBs und Zahlungen verfolgt, lautet schlicht: „Ja, eine Tabelle ist der richtige Weg.“ Diese Antwort setzt manuelle Erfassung voraus – aber die Tabelle selbst ist das richtige Werkzeug. Der Unterschied zwischen dieser Reddit-Empfehlung und diesem Workflow besteht darin, dass die Daten bereits vorausgefüllt ankommen und die Zeit des Abrechnungsspezialisten in Analyse und Nachfassung fließt statt in Tipparbeit.
Die Tabelle ist nicht der Engpass. Das war sie nie. Der Engpass ist der Schritt, in dem eine Person „Claim-Nr. 2026BC0047291“ von einer BCBS-EOB abliest und „2026BC0047291“ in Zelle B4 eintippt. Diesen Schritt zu entfernen ersetzt nicht das Urteilsvermögen des Abrechnungsspezialisten – es lenkt es auf die Arbeit, die es erfordert.
FAQ
Funktioniert das mit EOBs aller großen Kostenträger?
Ja. Da die KI EOBs liest, indem sie die semantische Bedeutung jedes Feldes versteht, statt einer Vorlagenstruktur zu folgen, verarbeitet sie EOBs von BCBS, Aetna, UnitedHealthcare (UHC), Cigna, Humana, Medicare, Medicaid, Tricare und Berufsgenossenschaften ohne konfiguration pro Kostenträger. Die Spalte „Versicherungszahlung“ wird auf einer BCBS-EOB automatisch „Plan Paid“ zugeordnet, auf einer Aetna-EOB „Amount Paid by Carrier“ und auf einer Medicare-Zahlungsavise „Medicare Paid“ – alles automatisch, weil die KI versteht, dass diese Begriffe dasselbe beschreiben. Wenn Sie einen neuen Kostenträger integrieren, gibt es nichts einzurichten. Wenn ein Kostenträger sein EOB-Layout ändert, bricht nichts.
Kann die KI die Kleingedruckten Anpassungscodes am Ende einer EOB lesen?
Ja – und das ist einer der Bereiche, in denen sich KI-Extraktion am stärksten von der manuellen Prüfung unterscheidet. Anpassungsgrundcodes (CARC (Claim-Anpassungsgrundcodes), RARC (Zahlungsavise-Bemerkungscodes)) und kostenträgerspezifische Ablehnungscodes werden oft in kleiner Schrift am Ende der letzten Seite gedruckt, in einem Abschnitt, den ein Abrechnungsspezialist bei der Verarbeitung eines Stapels von 20 EOBs vielleicht überfliegt, aber nicht gründlich prüft. Die KI liest sie als Standardtextfelder und extrahiert sie in eigene Spalten neben den Claim-Daten. Das automatisiert nicht die Entscheidung, was mit einer Ablehnung zu tun ist – der Abrechnungsspezialist bewertet weiterhin jeden Code und entscheidet über die geeignete Maßnahme –, stellt aber sicher, dass jeder Code erfasst wird, nicht nur die, die ein menschlicher Prüfer bemerkt hat.
Was ist mit mehrseitigen EOBs, bei denen sich ein Claim über mehrere Seiten erstreckt?
Die KI liest das gesamte Dokument als kontinuierlichen Datenstrom, nicht als isolierte Seiten. Wenn sich die Leistungsdetails eines einzelnen Claims über die Seiten 2 und 3 einer BCBS-EOB erstrecken, folgt die KI den Daten ohne Unterbrechung über die Seitengrenze hinweg. Die Claim-Nummer auf Seite 1 wird mit den CPT-Codes auf Seite 2 und den Zahlungsbeträgen auf Seite 3 verknüpft, da sie dasselbe Dokument teilen – die KI verliert an Seitenumbrüchen keinen Kontext. Ein Batch-Upload mit fünf mehrseitigen EOBs erzeugt eine Ausgabedatei mit jedem Claim von jeder Seite, zeilenweise organisiert, ohne dass der Abrechnungsspezialist Seiten trennen oder neu anordnen muss.
Wie schneidet das im Vergleich zur Nutzung elektronischer ERAs anstelle von Papier-EOBs ab?
Wenn Ihre Praxis ERAs (Elektronische Zahlungsavise, ANSI-835-Dateien) über eine Clearingstelle erhält, handelt es sich dabei bereits um strukturierte Datendateien, die keine Extraktion benötigen – sie können direkt in Ihr Praxisverwaltungssystem übernommen werden. Die EOB-Extraktion ist für die PDFs und Papierabrechnungen gedacht, die Sie weiterhin erhalten: EOBs von Zweitversicherern, Erklärungen der Berufsgenossenschaft, Kfz-Versicherungsansprüche, vom Patienten angeforderte Kopien sowie alle Kostenträger, die keine elektronischen Zahlungsavise senden. In den meisten Praxen decken elektronische ERAs 70 bis 80 Prozent der Claims ab, die restlichen 20 bis 30 Prozent treffen als PDFs ein. Genau diese Minderheit verbraucht einen unverhältnismäßig großen Anteil der Dateneingabezeit – und genau darauf zielt die Extraktion ab.
Werden Patientendaten während der Extraktion sicher verarbeitet?
EOBs enthalten PHI (Geschützte Gesundheitsinformationen) und müssen entsprechend behandelt werden. Hochgeladene Dateien werden zur Extraktion im Arbeitsspeicher verarbeitet, während der Übertragung verschlüsselt und nach Abschluss der Verarbeitung gelöscht. Extraktionstools unterscheiden sich jedoch in ihren Datenverarbeitungspraktiken – bevor Sie EOBs über einen Drittanbieterdienst verarbeiten, prüfen Sie dessen Verschlüsselungsstandards, Datenaufbewahrungsrichtlinien und ob ein BAA (Business Associate Agreement) angeboten wird, falls Ihre Praxis eine HIPAA-Konformitätsdokumentation benötigt. Für Praxen mit strengen Anforderungen an den Datenstandort sollten Sie Extraktionstools in Betracht ziehen, die Dateien lokal verarbeiten oder eine HIPAA-konforme Verarbeitung anbieten.
Kann ich auch Patienten-EOBs verarbeiten – nicht nur Exemplare für Leistungserbringer?
Ja. Die patientenorientierte Version einer EOB enthält dieselben Felder wie das Exemplar für den Leistungserbringer – Claim-Nummer, Daten, CPT-Codes und finanzielle Aufschlüsselungen –, jedoch oft in einem vereinfachten Layout mit erklärendem Text. Ein Patient, der seine eigenen EOBs über mehrere Leistungserbringer und Kostenträger hinweg verfolgt, kann denselben Ansatz der Spaltennamensextraktion verwenden und Spalten für „Leistungserbringer“, „Leistungsdatum“, „Berechneter Betrag“, „Versicherungszahlung“ und „Patientenanteil“ definieren. Die Ausgabe gibt Patienten die Abgleichsfunktion, die – wie Reddit-Diskussionen deutlich machen – Versicherungsunternehmen von ihnen erwarten, für die sie jedoch keine Tools bereitstellen.