材料受領書の抽出方法
現場の在庫照合のために
建設資材の発注に関する書類は、紙とデータの2つの形で存在します。ただし、1つだけ例外があります。発注書は工事原価システムに保存されています。サプライヤーの請求書はPDFで届き、買掛金処理に回されます。船荷証券はスキャンまたはファイル保管されます。しかし、材料受領書 — 現場監督がゲートで署名し、実際に到着したものを記録する納品書 — は、紙の形でしか存在しません。これは現場全体で物理的な受領を記録する唯一の書類であり、在庫照合が依存する書類です。
重要なポイント
- 納品書のデータを照合シートに再入力するのに毎月90分かかっており、多くの現場では、それらの納品書の大半がそもそも入力されていません。
- 建設関連の書類にはすべてデジタルコピーがありますが、1つだけ例外があります。現場監督がゲートで署名する材料受領書は、実際に到着したものを記録する唯一の書類であり、紙の形でしか存在しません。
- 40社の異なるサプライヤーからの40枚の納品書を1つのバッチに投入すると、計算列の「差異」列がすべての不足を赤い数字でフラグします。サプライヤーの記録が古くなってしまう月末ではなく、納品書に署名された週に検出できます。
材料受領書は、実際に到着したものの唯一の記録です
材料受領書は、発注書でも請求書でも船荷証券でもありません。そして、この違いは照合において重要です。発注書は購入しようとしたものを記録します。船荷証券は運送業者が運んだものを記録します。請求書はサプライヤーが支払いを求めるものを記録します。材料受領書だけが、現場で物理的に受け入れられたものを記録します。その形式はいくつかあります。材木置場からの手書きのカーボンコピー納品書、配合設計とスランプが記載されたシステム印刷のコンクリートバッチ伝票、鉄筋加工業者からのメールPDF、MEP販売店のERPが生成した梱包明細などです。そのすべてが受入側の文書であり、そのすべてに署名が付いています。
その署名には法的な重みがあります。統一商事法典第2編第2-606条に基づき、買い手は合理的な検査の機会の後に「商品が適合していることを売り手に表明」した時点で商品を受け入れたことになります。また、同法第2-602条に基づき、不適合商品の拒絶は、納品後合理的な期間内に、売り手への通知をもって行わなければなりません。現場の門での現場監督にとって、「合理的な期間」とはトラックが去る前を意味します。クリーンに署名された納品書は、記載された数量を受け入れたというサプライヤー側の証拠となります。だからこそ、同じ文書が在庫記録の基盤となるのです。
このワークフローの受入側、つまりドライバーがまだいる間に伝票を発注書と照合する部分については、受入量における建設用船荷証券と発注書の照合に関するガイドで詳しく説明しています。この記事で扱うのは、署名の後に起こること、つまり受領データを紙から月末の在庫照合が実際に行われるスプレッドシートに移すことです。
現場の在庫照合が失敗する理由 — スプレッドシートが原因ではない
スプレッドシートはボトルネックではありません。データ入力がボトルネックなのです。中規模のゼネコンが4〜6件のプロジェクトを運営している場合、毎月30〜50社のサプライヤーから材料の納品を受け、現場監督はそのすべての伝票に署名します。伝票1枚につき約3分の丁寧な転記作業、つまり紙を開き、明細行を読み、数量と説明を照合用ワークブックに入力する作業を考えると、1枚の発注書と数量を比較する前に、毎月90〜150分の純粋なキー入力作業が発生します。
そして実際には、それらの伝票のほとんどはまったく入力されません。r/Constructionの「典型的な建設現場。誰も納品を受け取らない」というスレッドは、現場の現実を捉えています。納品の瞬間に、受け取り、数え、記録する担当者が誰も割り当てられていないのです。たまたま近くにいた人が伝票に署名し、トラックは去り、紙は現場事務所のフォルダに入れられます。そして「後で」照合することになります。つまり月末に、納品ではなく請求書と照合されることになります。紙の伝票は簡単に失くしたり、判読できないこともあり、誰かが門で書き留めない限り、損傷や不足を反映しません。
盗難統計は、照合されていない受入プロセスがどれほどのコストを生むかを示しています。NICB/NER年次建設機械盗難レポートは、2014年に10,000件以上の建設機械の盗難を記録し、回収率はわずか22.7%でした。また、両団体は建設現場での年間損失を3億ドルから10億ドルと推定していますが、この数字には工具や材料は含まれていません。しかし、盗難がなくても材料で損失は発生します。門で気づかれずに通過する納品不足、表面化しない数え間違い、備考なしで署名された傷んだ乾式壁のロット——それぞれが照合差異となり、数ヶ月後に工事原価の超過やサプライヤーとの請求書紛争として表面化します。
本当の失敗は怠慢ではありません——受入記録と照合シートが別々の世界に存在していることです。門では紙、事務所ではスプレッドシート。誰かが伝票を打ち直すまで、両者をつなぐものは何もありません。
照合シートに本当に必要な列
抽出を始める前に、出力を定義してください——選択する列セットによって、結果のスプレッドシートが発注書、設置数量、工事原価元帳と照合できるかどうかが決まるからです。以下の列は、あらゆる建設在庫照合で行われる三者照合をカバーしています:発注数量 vs. 受入数量 vs. 設置数量。
| 列 | 取得元 | 重要な理由 |
|---|---|---|
| 受領日 | 納品書ヘッダー | 受領の日時を記録します。「合理的な期間」の紛争や、未処理の納品の滞留期間を判断する基準となります。 |
| 伝票番号 / 納品番号 | 納品書 | サプライヤーが使用する固有IDです。納品不足を問い合わせる際に引用するフィールドです。 |
| サプライヤー名 | 納品書ヘッダー | 発注書との照合や、後述のサプライヤーから工事への推論のために、受領記録をベンダーごとにグループ化します。 |
| 発注書番号 | 伝票の参照フィールド(多くの場合空白) | 受領記録を実行予算に結び付けるキーです。空白の場合は、手入力または推論が必要です。 |
| 工事番号 | 推論 — 伝票には印刷されていません | ほとんどの伝票には社内の工事番号が記載されていません。サプライヤーから工事へのルールで自動的に補完されます。 |
| 原価コード | 品目説明から推論 | 工事原価計算のためのCSI MasterFormat区分です。2×6の枠組材は06 11 00、乾式壁は09 29 00にマッピングされます。 |
| 品目説明 | 伝票の明細行 | 「2×6 #2 SPF 16'」や「5000 psi レディーミクストコンクリート」など、原価コード推論が読み取るテキストです。 |
| 受入数量 | 伝票の明細行 | 実際に到着した数量です。在庫残高の基盤となる数値です。 |
| 単位 | 伝票の明細行 | 本、ボードフィート、立方ヤード、トンなど。サプライヤーによって不統一ですが、記載された通りに抽出されます。 |
| 発注数量 | 発注書シートから相互参照 | 基準値として一度入力するか、抽出後にマージします。差異検出の基準となります。 |
| 差異 | 計算列 | 受入数量 − 発注数量 — 負の値は不足、正の値は過剰を示し、抽出中に計算されます。 |
| 受領者 | 伝票の署名欄 | 商品を受け取った担当者です。後日、不足が問題となった場合の責任の所在を明確にします。 |
| 備考 | 伝票に手書きされたコメント | 破損、部分納品、「雨濡れ」、「5枚不足」など、差異を説明づける文脈 |
2つの列は、単純な転記ではできない処理を行うため、追加の説明が必要です。計算列は、ページから値を読み取るだけでなく、抽出中に算術演算を実行します——「差異」を受入数量 − 発注数量と定義すると、AIが全明細行の差を計算して列に入力するため、不足はエクスポート内で赤い数字として表示され、40行にわたって手計算する必要がなくなります。推論列は、文書に明記されていない値を補完します——サプライヤーを工事番号にマッピングするルール(「ABC Lumber → Job 24-005」)や、品目説明をCSI原価コードにマッピングするルールを定義すると、AIが各伝票を読み取りながらマッピングを適用します。どちらの仕組みもカスタム列抽出の一部です:列名を入力するだけで、AIが各フィールドの意味を理解して各文書の該当データを特定します——ページ上の位置ではなく。これにより、1つの列定義が40種類のサプライヤー伝票フォーマットで機能するのです。
材料受領書を照合シートに抽出する方法
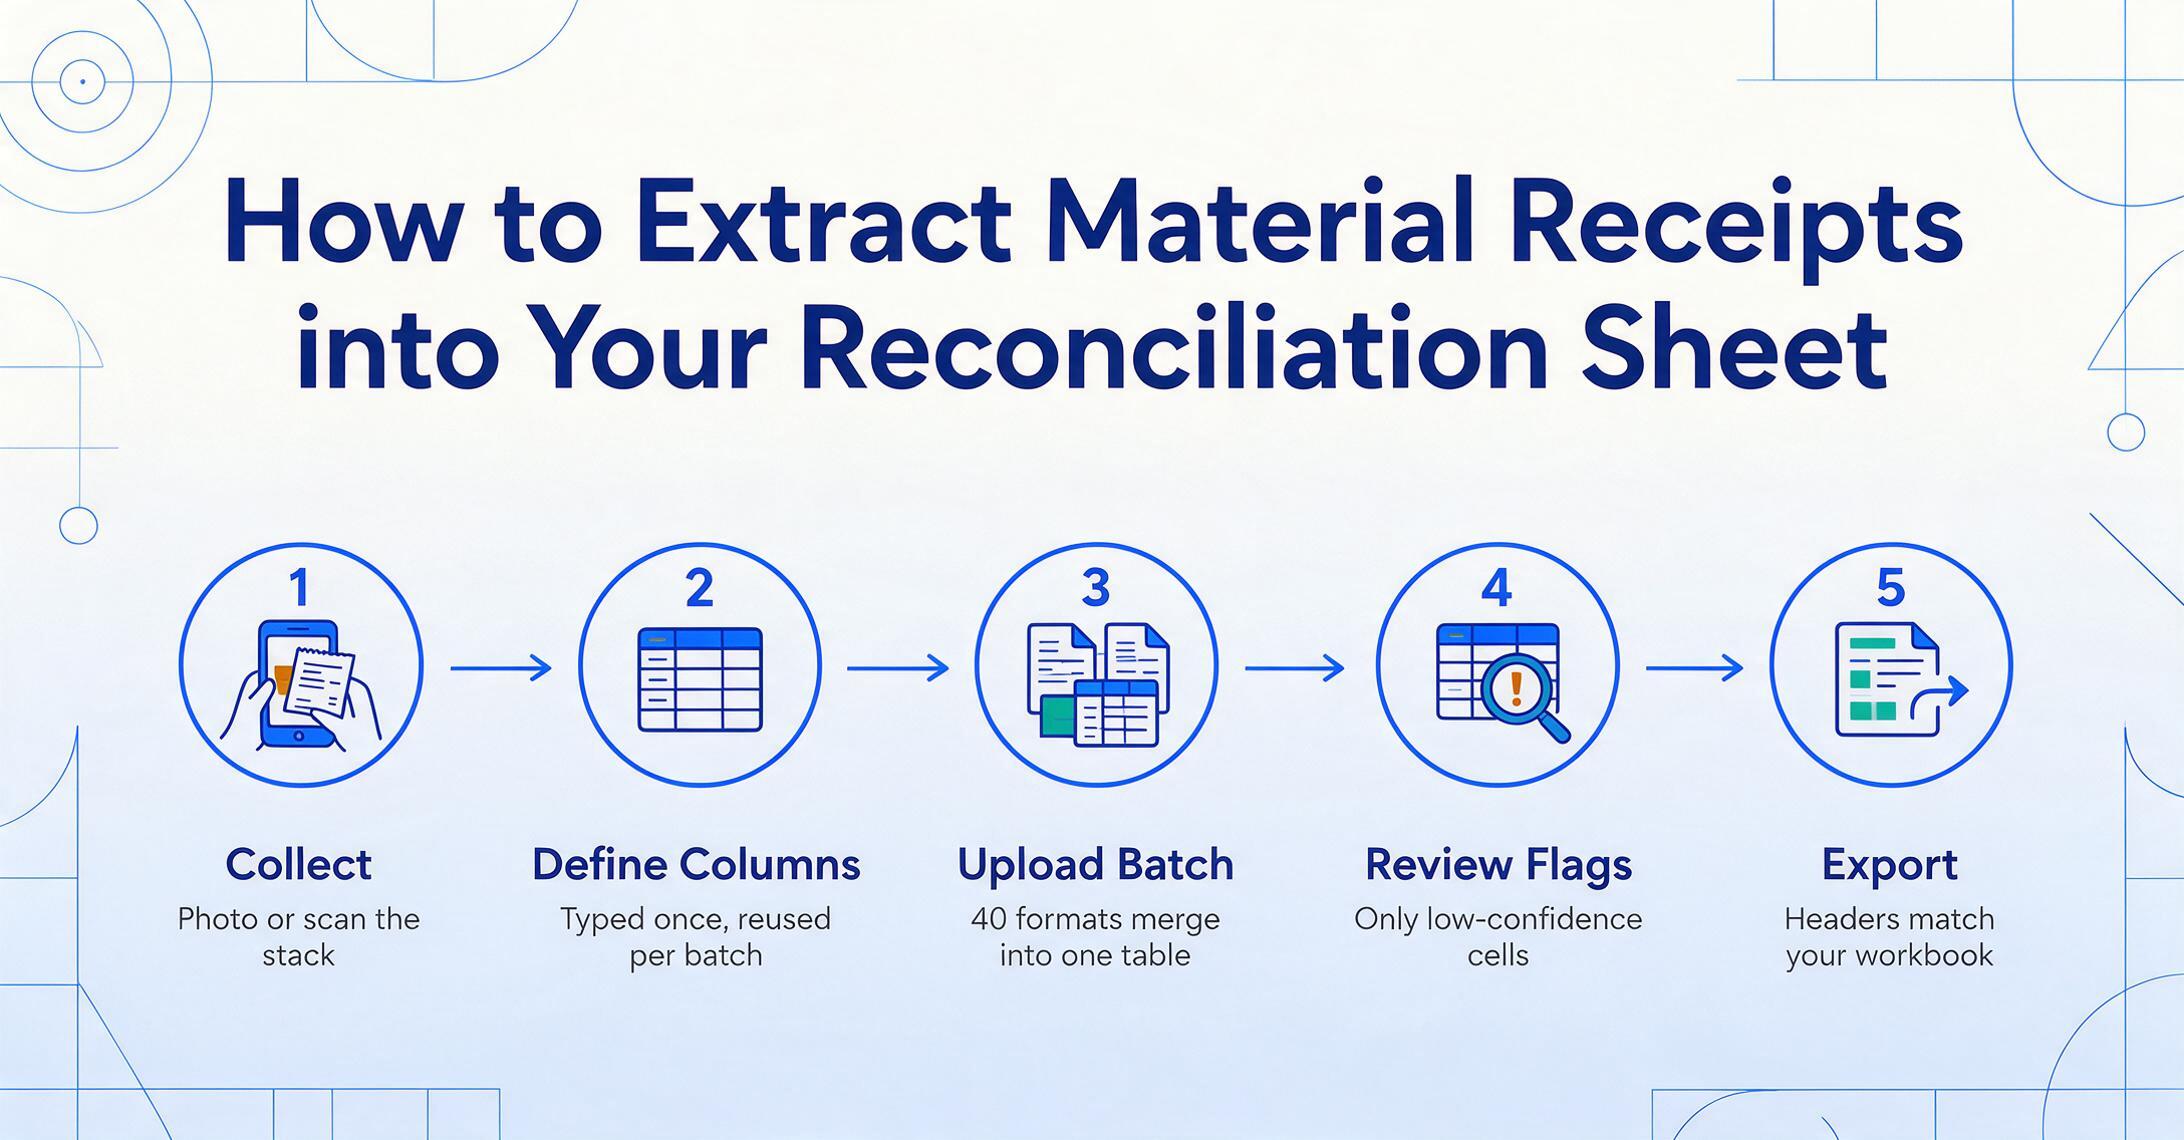
このワークフローは5つのステップで構成され、最初の2つは伝票ごとではなく一度だけ行うセットアップです。
領収書を集めます。ゲートでスマホを使って納品書を撮影するか、週に一度、現場事務所にある書類の束をスキャンします。手書きのカーボンコピーのスマホ写真でも大丈夫です。カメラのフラッシュが、薄紙に青く印刷されたカーボン形式を、明るい場所なら十分に読み取ってくれます。コンクリートのバッチチケット、材木屋の伝票、MEPの梱包明細、鉄筋のPDFなど、手元にあるものは何でも集めてください。すべて同じパイプラインで処理されます。
列を一度だけ定義します。上の表の列名(受領日、伝票番号、サプライヤー名、発注書番号、工事番号、原価コード、品目説明、受入数量、単位、発注数量、差異、受領者、備考)を入力します。入力した列名がそのまま出力スプレッドシートのヘッダーになるため、抽出シートと照合用ワークブックがマッピング作業なしで常に同期されます。同じ作業の中で、計算列の「差異」と、推論列の「工事番号」/「原価コード」のルールも追加します。
書類の束をバッチとしてアップロードします。すべての写真とPDFを一度にドロップします。システムはバッチを並行処理するため、40のサプライヤーから届いた40種類のフォーマットの伝票40枚でも、1枚の場合とほぼ同じ時間(通常1分未満)で処理が完了し、すべてが1つのテーブルにマージされます。これがバッチファースト処理です。マージは抽出時に行われるため、後から統合する手順は不要で、40個の個別エクスポートからマスターシートへ行をコピー&ペーストする必要もありません。
重要なフィールドを確認します。データが照合用ワークブックに反映される前に、検証してください。数量が重要なフィールドでは、抽出された任意のセルにホバーすると、その値が元の伝票のどこから来たのかを正確に確認できます。AIが読み取った写真の領域をハイライト表示します。文書全体を校正する代わりに、間違っている1つのセルだけを修正します。手書きのカーボンコピーでは、低信頼度のフィールドがいくつかフラグされ、確認を求められます。修正が必要なのはそれらのフィールドだけで、問題のない30個のフィールドではありません。
エクスポートして照合します。XLSXをダウンロードすると、在庫の受入側がスプレッドシートになります。工事番号でソート可能、サプライヤーでフィルター可能、差異の列は事前計算済みです。発注書シートとマージします(発注数量をまだ含めていない場合は、発注書番号のVLOOKUPで発注数量を取得します)。これで三者照合の準備が整います。1枚あたり3分かかっていた作業が数秒になり、確認パスで、スキャン時のノイズや走り書きで読み取れなかったフィールドも検出されます。
作業の中心は転記から検証へと移ります。月に40件の受領書を処理するプロジェクト会計担当者は、約2時間のタイピング作業から、数分のスポットチェックへと変わります。そして、以前は月末の差異報告で表面化していた納品不足が、伝票に署名された週にレビューされるスプレッドシート上の赤い「差異」セルとして即座に浮かび上がります。
ファイルは安全に処理され、保存されません。
手元にある納品書でお試しください。現場事務所でくしゃくしゃになったカーボンコピーでも構いません。列を定義し、写真をドロップするだけで、数量が自分のタイピング通りの結果になるかどうかを確認できます。
照合の計算:発注数量 vs 受入数量 vs 施工数量
抽出により、受入データがシートに入ります。照合自体は3つの比較で構成され、それぞれが資材の状況について異なる問いに答えます。
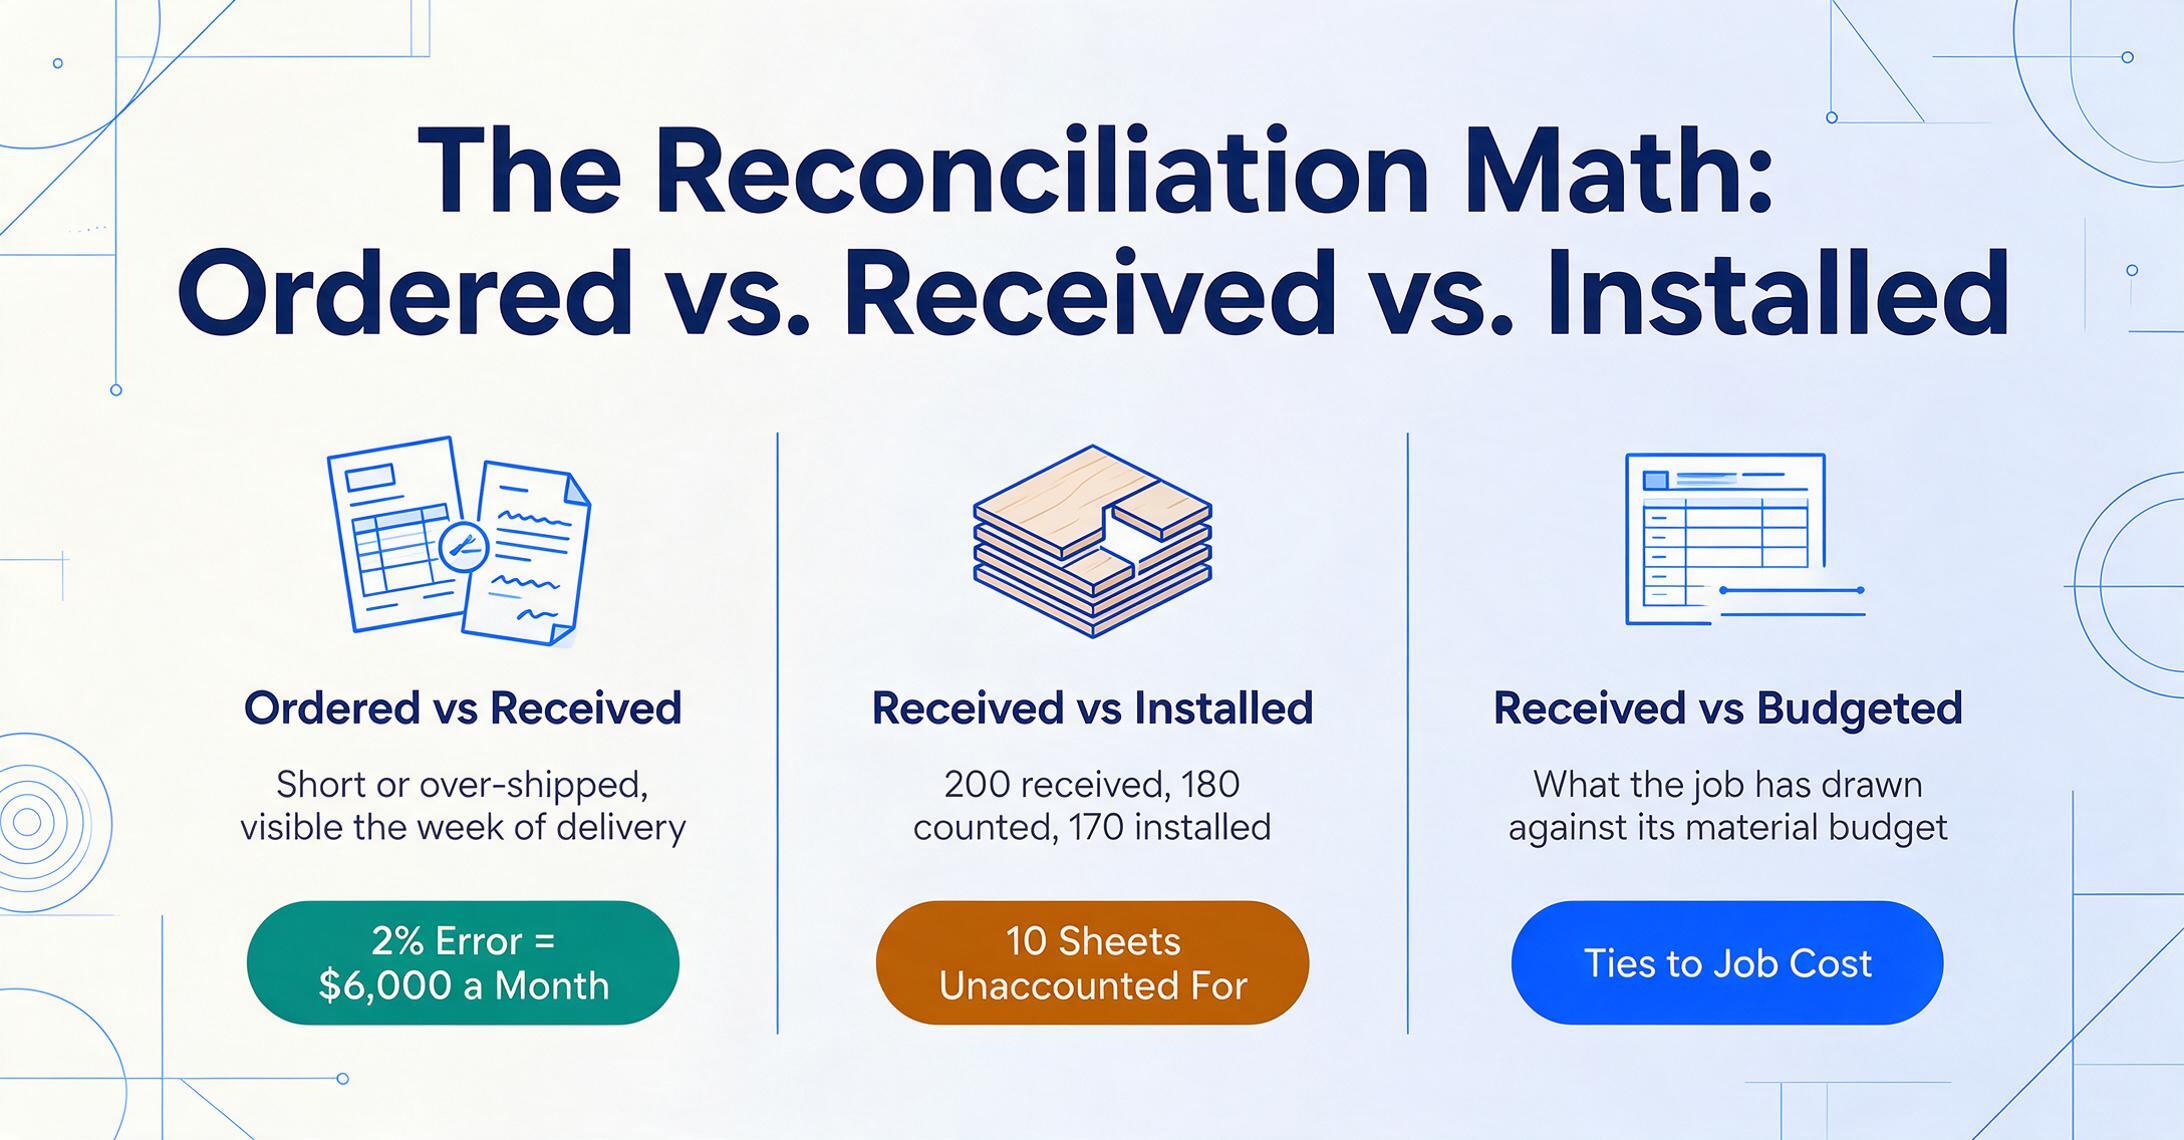
1. 発注数量 vs 受入数量。発注書の数量と納品書の数量を比較します。これが差異の列です。マイナスはサプライヤーが不足して納品したことを意味し、プラスは過剰納品を意味します。この比較により、「2,400ドルの枠組材パッケージが20枚不足」という問題が請求書の紛争になる前に発見できます。サプライヤーの明細書が届く週ではなく、納品の週に確認できるからです。月間30万ドル以上の資材を取り扱うゼネコンにとって、ここで2%の受入エラー率(手作業での受入における業界経験と一致する数値)を検出することは、サプライヤーの記録がまだ新しいうちに解決される、月間およそ6,000ドルの不足分と過払い金を意味します。
2. 受入数量 vs 施工数量。納品された数量から実際に施工された数量を引いたものが、現場にあるべき数量です。これは循環棚卸で検証する数値です。残高が実地棚卸と一致しない場合、その差異は盗難、損傷、ゲートでの数え間違い、またはシステムに入力されなかった伝票のいずれかです。そして、受入記録が最初に確認すべき場所です。記録に200枚の受入とあるのに、カウントが180枚、施工記録が170枚であれば、10枚が不明です。これは完工時ではなく、今すぐ調査する価値のある数値です。
3. 受入数量 vs 工事予算。受入数量を原価コード別に合計し、工事原価システムのプロジェクト予算と比較します。これにより、受入記録はコスト超過の早期警告信号となります。第06区分(木、プラスチック、複合材)は、木材価格の高騰により実行予算を15%超過していますが、第09区分(仕上げ)は予算内で推移しています。抽出中に原価コードが推論されるため、この比較は誰も手作業でコードを割り当てることなく、すべての受入伝票で機能します。資材コストを工事原価の数値に変換する完全なワークフロー(サプライヤーフォーマット間のCSIコードマッピングを含む)については、建設資材の発注書を工事原価にバッチ処理するガイドをご覧ください。また、課税品目と非課税品目が混在する受入伝票については、建設受入伝票のコスト配分ウォークスルーで税ステータスのエッジケースを解説しています。
照合シートの価値は、その基盤となる受入データの質に依存します。抽出は計算を変えるのではなく、計算を実行するためのデータがあるかどうかを変えるのです。
手書きカーボンコピー、コンクリートバッチチケット、その他テンプレートツールを壊すフォーマット
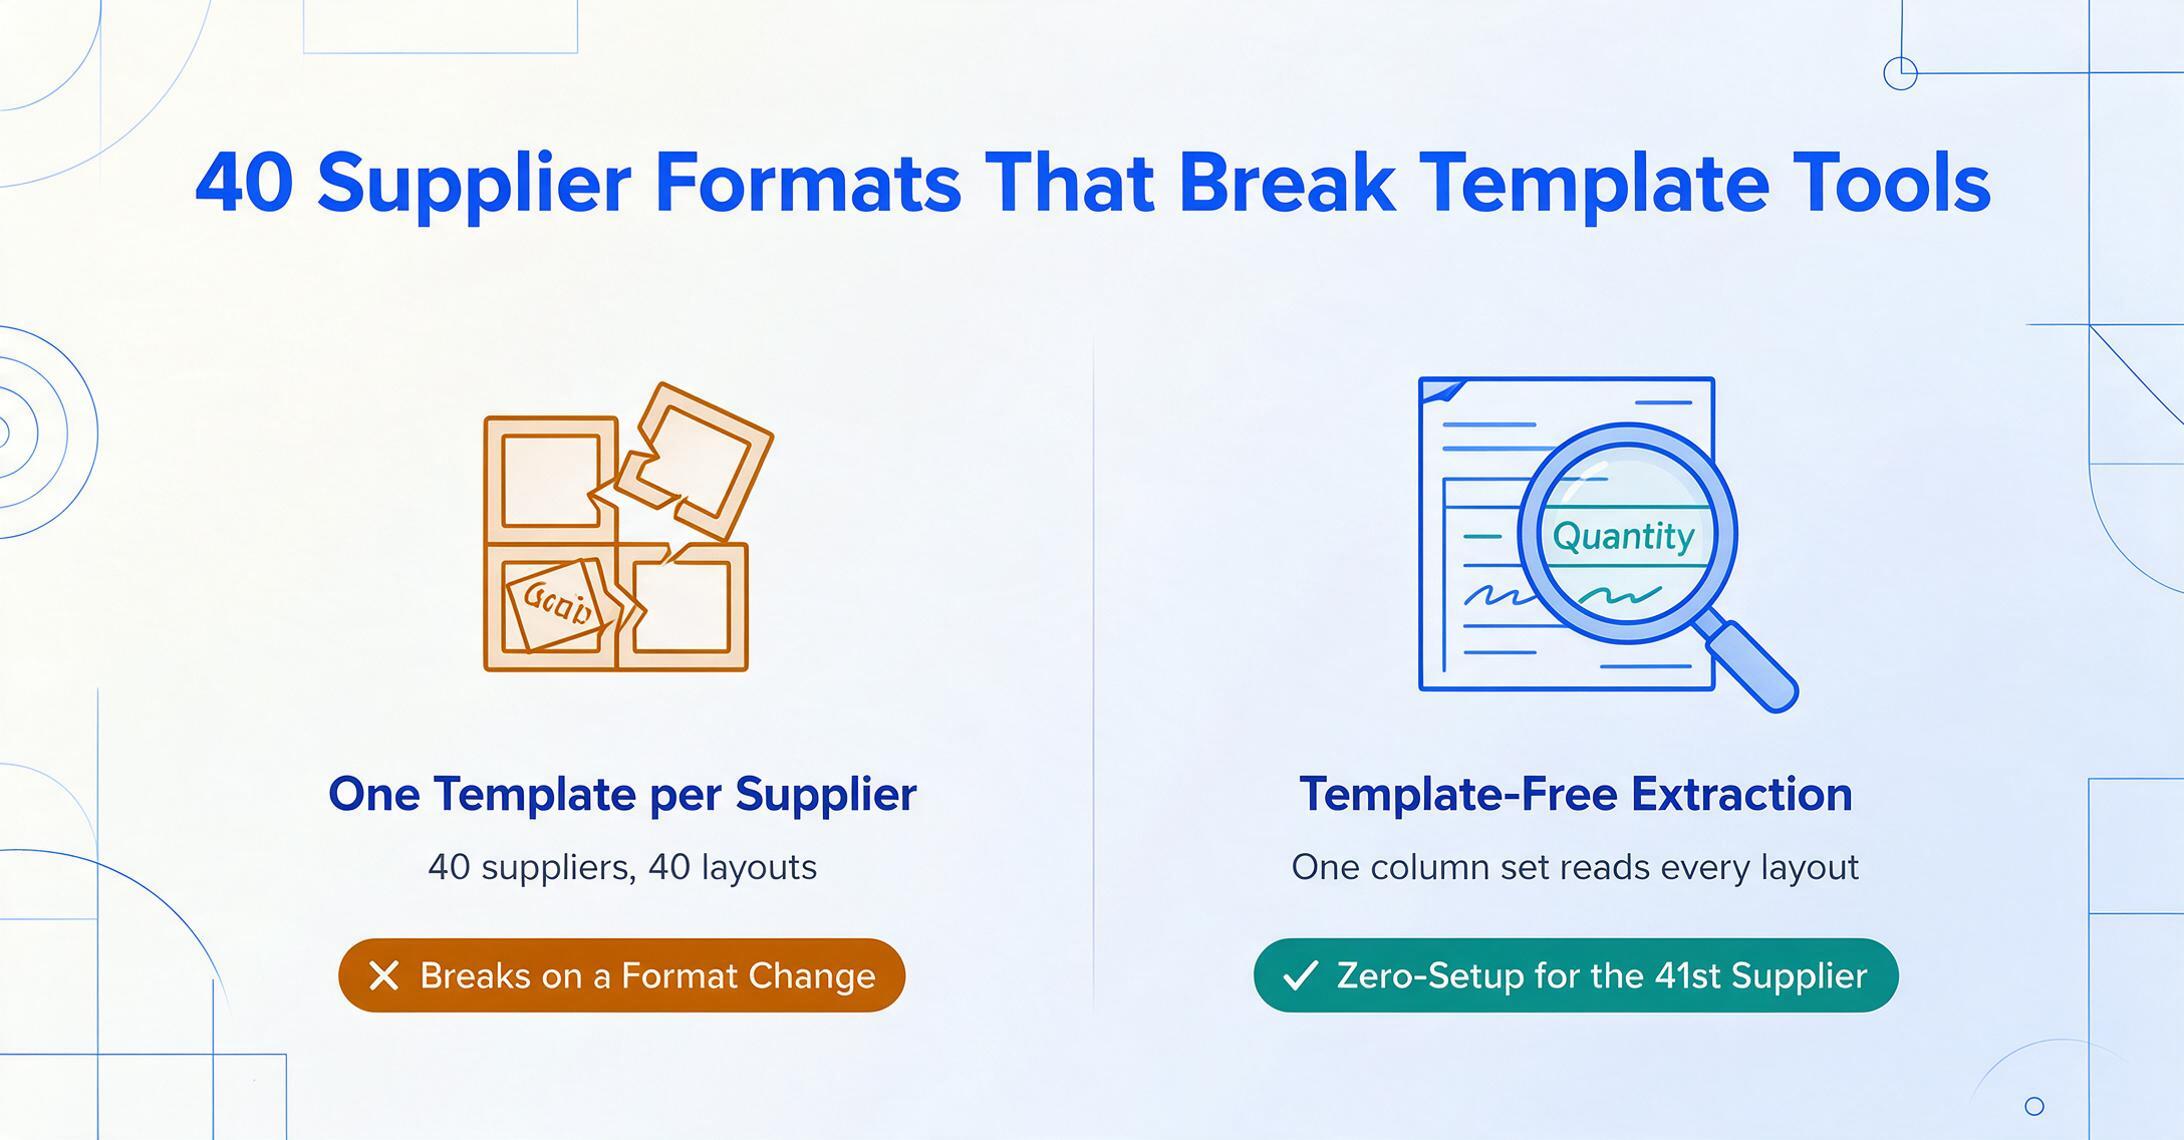
現場に届くフォーマットの多様さこそ、テンプレートベースの抽出アプローチが建設資材の受入で失敗する理由です。テンプレートツールはフィールドの周りにボックスを描きます。「数量は右上隅から3インチの位置」というように。そして、異なるレイアウトを使うサプライヤーごとに独自のテンプレートが必要になります。材木置場のカーボンコピー、コンクリートプラントのバッチチケット(配合設計、スランプ、立方ヤード、トラック番号、バッチ時間 — 材木チケットにはないフィールド)、鉄筋加工業者のヒート番号、MEP販売店のSKUコード:これでは40社のサプライヤーに40のテンプレートが必要になり、そのうちの1社でもフォーマットを変更すれば、テンプレートは壊れてしまいます。
セマンティック抽出には、そのような問題はありません。AIはコンクリートチケットの「数量」を、材木置場のカーボンコピーと同じように読み取ります。数量が何であるかを理解するのであって、列がたまたまどこにあるかではないからです。これが位置ベースと意味ベースの抽出の違いであり、ステップ2で定義した同じ列定義が、サプライヤーごとのセットアップなしで、あらゆるチケットフォーマットで機能する理由です。41社目のサプライヤーを追加してもコストはかかりません。そのフォーマットは同じパイプラインを通るだけです。
正直な限界:判読可能な手書き文字は確実に抽出できますが、劣化の激しいカーボンコピーや雨濡れのチケットは、低信頼度フィールドとしてフラグが立てられ、レビューが必要になります — 通常は文書あたり数個です。レビューステップが存在するのはまさにこのためです。フラグが立てられたセルを検証するのであって、チケット全体を打ち直すわけではありません。劣化した文書全体にわたる抽出精度の詳細 — 何が精度を向上させ、何が向上させないか — については、建設現場文書の品質に関する完全ガイドが参考になります:AIは建設現場の文書を確実に読み取れるか。
Procore、Viewpoint、Sage 300との位置づけ
建設ソフトウェアプラットフォームは受入記録を追跡しますが、紙から作成するわけではありません。ProcoreのCommitmentsツールは発注書明細を受入数量と照合しますが、受入数量は納品書を読んだ担当者が入力します。Sage 300 Construction and Real Estateには購買モジュールに発注書をクローズする入庫エントリがありますが、キーボードから入力されます。Viewpoint VistaとBluebeamは文書とワークフロー側を処理します——納品が発生したことを追跡し、PDFの記録を管理します——しかし、いずれも紙を読み取って受入記録に変換することはありません。「現場で署名された納品書」と「ERPの受入数量」の間には、依然として人の入力が存在します。
抽出レイヤーはそのギャップに位置します。生成されるスプレッドシート——発注書番号、工事番号、原価コード、受入数量がすでに照合済み——は、これらのプラットフォームの受入モジュールが期待する入力そのものです。CSVとしてProcoreのCommitmentsにインポートする場合も、Sage 300の入庫エントリに入力する場合も、あるいはERPと並行して稼働する受入記録として保持する場合も同様です。これはプラットフォームを置き換えるのではなく補完します。ERPは発注契約と支払いのシステム・オブ・レコードであり続け、抽出は紙をそこに取り込む手作業を排除します。同じパターンは建設プロジェクトの財務に影響する他の文書にも適用されます——下請け業者の請求書と建設許可データはどちらも同じ抽出・スプレッドシート化パイプラインを通じて同じ工事原価元帳に流れ込みます。
よくある質問
材木店からの手書きの納品書でも処理できますか?
はい——判読可能な手書きであれば可能です。AIはピクセルテンプレートの照合ではなく、文脈における文字形状の理解によって手書きテキストを読み取ります。明確に書かれた納品書は確実に抽出されます。薄紙に青く印刷されたカーボンコピーや、大きく劣化した手書き文字は、レビュー用に低信頼度フィールドがフラグされます——通常は30以上のフィールドのうち数個——システムは確認すべきセルを正確にハイライトするため、文書全体を校正する必要はありません。
納品書に発注書番号がない場合はどうなりますか?
これはよくあることです——多くのサプライヤーの伝票には自社の納品番号しか記載されていません。発注書番号フィールドは空白のまま出力され、レビュー時に記入します。あるいは、より良い方法として、サプライヤーから工事番号への推論ルールを設定すれば、工事番号が自動的に入力され、その納品がどの発注書に属するかが絞り込まれます。一貫して発注書番号を省略するサプライヤーには、すべての納品書に発注書番号を必須とするプロセス変更が根本的な解決策となります。抽出ワークフローは、欠落したフィールドを照合不能な行として帳尻合わせに紛れ込ませるのではなく、可視化します。
配合設計、スランプ、トラック番号が記載されたコンクリートバッチチケットも読み取れますか?
はい。コンクリートバッチチケットはシステム生成の印刷文書であるため、高い精度で抽出できます。配合設計、スランプ、立方ヤード、バッチ時間、トラック番号はすべてフィールドとして出力されます。フォーマットは木材チケット(明細行テーブルなし、ヘッダーデータ多め)とはかなり異なりますが、抽出は位置ベースではなく意味ベースのため、同じ列定義で両方に対応できます。立方ヤード受入数量、配合設計、トラック番号など、必要なフィールドを追加すれば、チケットごとに値が入力されます。
サプライヤー間で単位が異なる場合(ボードフィート vs. 本、立方ヤード vs. トン)はどうすればよいですか?
抽出では、チケットに印刷されている単位(本、ボードフィート、立方ヤード、リニアフィート、トン)をそのまま読み取り、印刷された単位を保持します。単位の自動換算は行いません。比較用に換算数量が必要な場合は、換算式を使った計算列を設定してください。例えば、2×6材の場合、本数(ボードフィート ÷ 2.67)のような計算列を設定すると、AIが抽出時に計算を実行するため、差異比較は比較可能な数値で行われます。
これはProcoreやSage 300の代替になりますか?
いいえ。これは、それらのプラットフォームの前段に位置するデータ取得レイヤーです。Procore、Sage 300 CRE、Viewpoint、Bluebeamは受入記録を追跡し、その周辺のワークフローを管理しますが、受入数量は依然としてキーボード入力でそれらのシステムに入力されます。抽出機能は、それらのシステムの受入モジュールやインポートテンプレートが期待する構造化された受入データ(発注書番号、工事番号、原価コード、数量、差異)を生成することで、この手作業を排除します。ERPは引き続きシステム・オブ・レコード(公式記録)であり、抽出機能は署名済みの紙のチケットとERPの受入数量フィールドの間のギャップを埋めます。
数量フィールドと単位フィールドの抽出精度はどのくらいですか?
印刷・タイプされたチケット(コンクリートバッチチケット、鉄筋PDF、MEP梱包明細)の場合、数値フィールドの精度は最大99%です。手書きのカーボンコピーは変動するケースで、判読可能な手書きは確実に抽出されますが、劣化したコピーは低信頼度フィールドにフラグが立てられ、レビュー対象となります。そのため、ワークフローには検証ステップが含まれています。セルにホバーすると値の取得元となったチケットの正確な領域が表示され、フラグが立てられた少数のセルを修正してエクスポートします。検証パスは文書あたり数秒で完了し、完全な転記にかかる数分とは比べものになりません。また、この検証パスを経ずにエクスポートされたものを公式なものとして扱うべきではありません。
現場監督が署名するすべての納品書は、まだ存在していない在庫データの1行です。数量、単位、サプライヤー、日付。問題は、そのデータが月末の在庫照合では見えない現場事務所のフォルダに眠っているのか、それとも署名された同じ週に発注書や予算と照合できるスプレッドシートにあるのか、ということだけです。抽出は簡単な部分です。照合の優位性は、受入記録をそもそも持っているかどうかにかかっています。
納品書で試す