建設デジタル変革は
ひとつの文書から始まる
AGCおよびSage 2026建設業界の雇用と事業見通しによると、建設会社の61%が現在AIを導入しているか、今年のAI支出を増やす計画があり、その活動の45%はオフィスおよび管理業務に集中しています。資金は動いています。しかし、プロジェクトが停滞するのは順序付けの段階です。多くの建設会社が最初に導入するプラットフォームは、ファイルがすでにデータ化されていることを前提としている一方で、バックオフィスを詰まらせる文書はPDF、携帯電話の写真、カーボンコピーの現場フォームとして届き、それらは今も手作業で読み取って入力しなければならないからです。
重要なポイント
- 建設会社の61%がAIに投資しており、その45%は請求書や日報が今も手入力されているオフィス業務に充てられています。
- 御社のプラットフォームは自社が管理するワークフローをデジタル化しましたが、外部から届く下請け業者の請求書や保険証明書を読み取ることはありません。そのため、ソフトウェアの一覧は完璧に見えても、デスク業務は手作業のままです。
- 最初に自動化すべき文書は、そのデータを待っている人の列が最も長い文書であり、デモで最も見栄えのする文書ではありません。
建設業のデジタルトランスフォーメーションが「再入力」の段階で停滞する理由
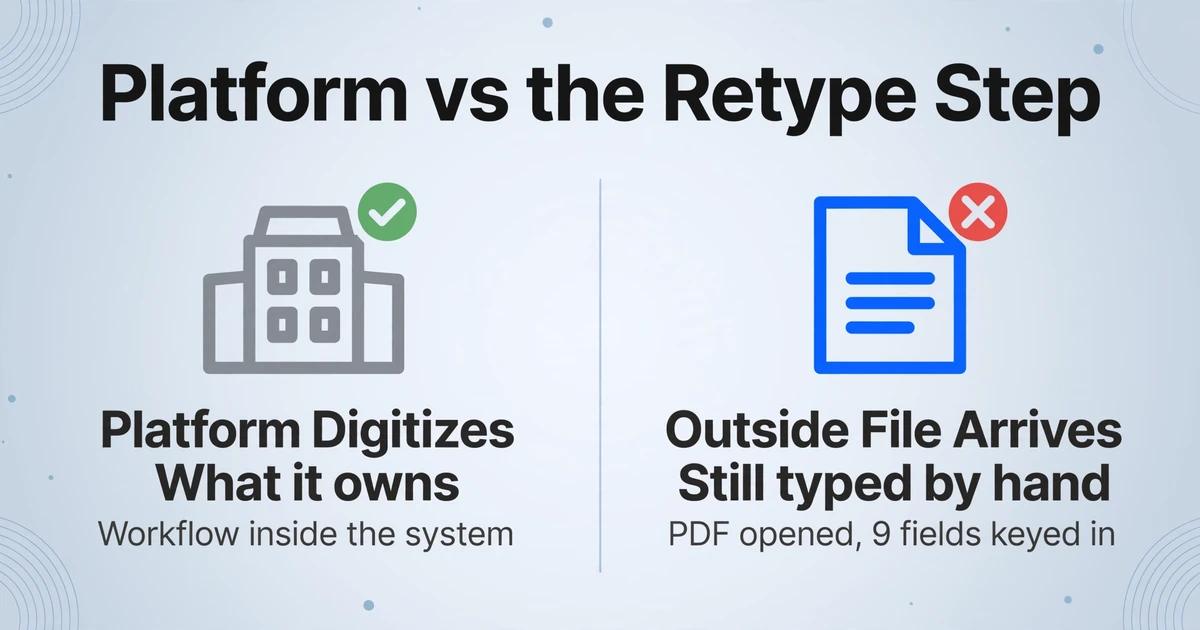
建設プラットフォームは、内部に入るデータを管理するために作られており、外部から届くデータを読み取るようには設計されていません。Procore、Sage 300 CRE、Viewpoint Vista、Autodesk Construction Cloudは、いずれもコミットメント、承認済み変更指示書、工事費明細表を保持しています。しかし、下請け業者がQuickBooksで作成した請求書、保険代理店がメールで送ってきたACORD 25、現場監督がペンで記入した日報を読み取る機能はありません。これらの文書は外部の当事者が外部のソフトウェアで作成するため、そのデータはキーボードを通じて御社のシステムに入力する必要があります。
これこそが、デジタルトランスフォーメーションのロードマップを書き留める価値がある理由となるギャップです。プロジェクト管理プラットフォームは、自社が所有するワークフローをデジタル化します。しかし、月末の最終日に4時40分に届くファイルには対応しません。オフィスでは依然としてPDFを開き、9つのフィールドを読み取り、ERPに入力しています。ソフトウェアのリスト上では変革は完了しているように見えても、実際の作業が行われる机の上では手作業が続いています。
文書のデジタル化とデータ抽出は別の作業です。スキャンはページを画像に変えます。抽出はページをシステムが利用できる行に変えます。これこそが、これまで再入力のステップで手作業で行われていた部分です。
この傾向は、テクノロジーを避けてきた企業に限った話ではありません。r/ConstructionManagersの最近のスレッドでは、業界の状況が率直に要約されています。「建設マネージャーは膨大な管理業務を手作業で行っている。PDFや紙の請求書データをコピー&ペーストしている」。ソフトウェアの導入と手動データ入力が共存するのは、ソフトウェアが自社のデータベースの境界で止まり、文書がその外側に存在するためです。
建設業者を顧客に持つ会計事務所は、r/Constructionでその量を次のように説明しています。「毎月、各クライアントについて、何百ページもの請求書・領収書を確認している。それらは管理者に渡り、印刷される」。印刷、仕分け、入力。この連鎖は長く、そのコストは見えにくくなっています。
建設業におけるOCRは、デジタルトランスフォーメーションのロードマップの入り口です。なぜなら、下流のすべてのシステムが依存する唯一のステップに取り組むからです。支払申請の照合、原価コードの計上、コンプライアンス画面での期限切れ証明書の警告の前に、データはページから離れる必要があります。これを実現することがステップ1であり、ステップ1はどのページから始めるかという選択です。
ステップ1:社外から届くドキュメントを把握する
ソフトウェアを選ぶ前に、社外から入ってきて月末に手入力となっているドキュメントをリストアップしてください。完全な記録監査は必要ありません。必要なのは、担当者が読んで再入力している定期的なファイルであり、それはほぼ毎回同じ8〜10種類です。
以下の表は、ゼネコン向けの代表的なリストです。御社の組み合わせは業種や自社施工の量によって異なりますが、送信元と送信先の列はほとんど変わりません。
| ドキュメント | 一般的な受領形式 | データの格納先 | 手入力される項目 |
|---|---|---|---|
| 下請け業者請求書 | QuickBooksまたはカスタムPDF、場合により電話で撮影した写真 | Sage 300 CRE / Viewpoint / Foundationの買掛金 | 下請け名、ジョブ番号、原価コード、請求額、保留金、差引支払額、請求日 |
| AIA G702/G703支払申請書 | 署名・スキャン済みフォームと継続シート | 支払スケジュール / 工事原価台帳 | 契約累計額、完了・保管額、保留金、今回支払額、残工事額 |
| ACORD 25証明書(COI) | 保険代理店からのPDF | コンプライアンススプレッドシートまたはCOIトラッカー | 保険証券番号、保険会社、保険種別、限度額、開始日・満了日、追加被保険者 |
| 認定給与報告書(WH-347) | 各下請けからスキャンまたはPDFで提出 | prevailing wageコンプライアンス記録 | 作業員名、職種区分、通常・時間外労働時間、賃率、総賃金、控除額 |
| 日報 | 手書きの用紙または電話で撮影した写真 | 日報、給与計算、生産管理 | 作業班、職種別時間、機器ID、納品情報、完了作業、安全メモ |
| 作業班タイムシート | 紙、テキスト送信された写真、またはタブレットフォーム | 給与計算と工事原価 | 従業員、日付、時間、フェーズまたは原価コード |
| 発注書と納品伝票 | サプライヤーPDF、納品書、または手書き伝票 | 受入記録 / コミットメント記録 | PO番号、サプライヤー、品目、数量、単価、納品日 |
| 放棄証と変更指示書 | 署名・公証済みPDFまたはスキャンした紙 | 放棄証記録 / 変更指示書記録 | 請求者、対象日、放棄の種類、金額、CO番号、コスト影響、署名 |
このリストは2つのことを同時に行います。毎月の労力のうち、どれだけがドキュメント処理に費やされているかを示し、プラットフォームがすでに追跡しているファイルと、まったく目にしていないファイルを分けます。Procoreはコミットメントと承認済みの変更指示書を保持しますが、下請け業者の請求書や代理店の証明書は読み取りません。これらが自動化の候補であり、次のステップはどれを最初に処理するかを決めることです。これらのドキュメントがゼネコンの評価基準にどう結びつくかについての詳細は、建設向けドキュメント抽出ソフトウェアのガイドをご覧ください。
ステップ2:入力にかかるコストでドキュメントをランク付けする
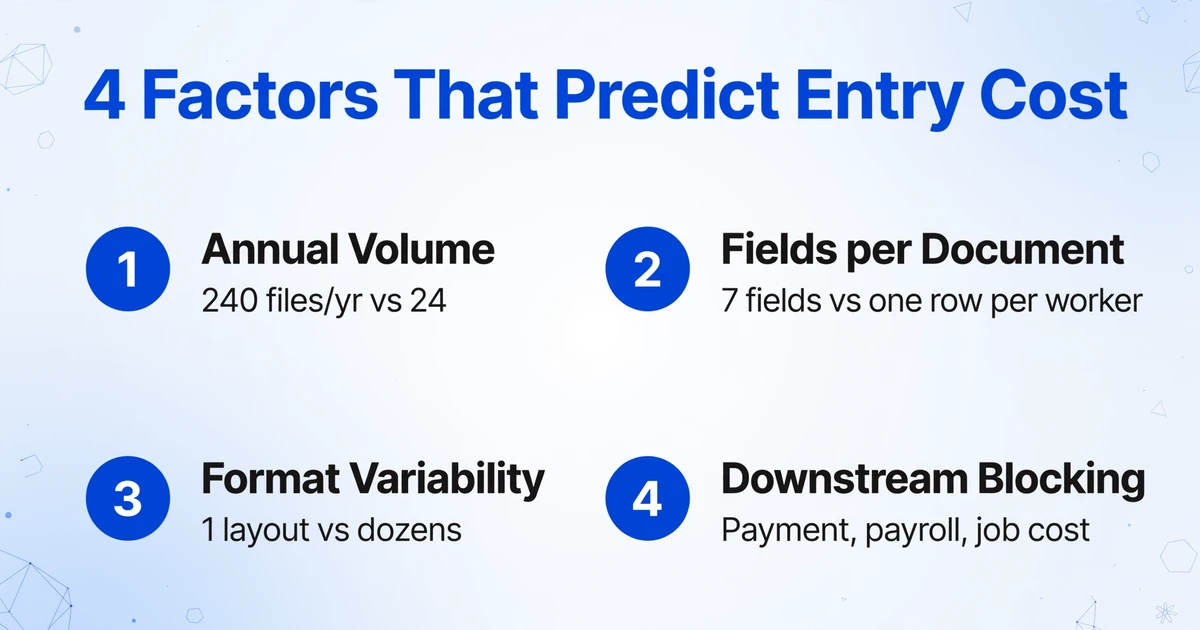
請負業者は通常、ベンダーのデモで最初のドキュメントを選びます。つまり、営業コールで最も印象的に見えるファイルが最初に選ばれるということです。より良い判断基準は、そのドキュメントが消費する労力です。4つの要素がそのコストを予測し、これらはすべて先月の記録から何も購入せずに推定できます。
年間ボリューム
1年間に処理されるドキュメントの数です。年に240回届くファイルは、月に2回しか届かないファイルよりも処理コストがかかります。たとえ後者の方が読みにくくてもです。
ドキュメントあたりのフィールド数
読み取って入力する値の数です。7つのフィールドがある1ページの請求書は、作業員ごとに行があるWH-347よりもはるかに少ない労力で済みます。
フォーマットのばらつき
ドキュメントがどのくらいのレイアウトや手書きスタイルで届くかです。標準化されたAIA G702は1つのフォーマットです。下請け業者の請求書の山は数十種類あり、新しいレイアウトごとに読み取り時間が増えます。
下流工程のブロッキング
このデータを待って次のタスクを進める人がいるかどうかです。入力されていない請求書は支払いを遅らせます。入力されていないタイムシートは給与計算を遅らせます。遅れた現場報告書は、オーナーが尋ねる工事原価の全体像を遅らせます。
各候補を4つの要素すべてについて1〜3点で評価し、合計してください。 合計が最も高いものが最初の自動化ターゲットです。下請け業者の請求書、日報、タイムシートは、頻繁に届き、多くのフィールドを持ち、フォーマットがばらつき、誰かの作業をブロックするため、高得点になりがちです。ACORD 25証明書は、ボリュームが少なくてもブロッキングの点で高得点になるため、最初ではなく2番目または3番目のターゲットになることがよくあります。
順位が重要なのは、算数の問題だからです。1ページを手入力するのに平均で約3分かかります。ImageToTable.aiは1ページを約5〜10秒で処理し、印刷された表データに対して最大99%の認識精度を報告しています。これを、それぞれ8つのフィールドがある240件の請求書に当てはめると、その差はもはや便利さの域を超えます。その作業は、人が1週間かけて行うものから、人が確認するだけのものへと変わります。
最初に自動化すべきドキュメントは、量が最も多く、ばらつきが最も大きく、そのデータを待っている人の列が最も長いものです。フォーマットの複雑さだけが指標ではありません。待っている人が指標なのです。
ステップ3: フォーマットの多様性に対応できる抽出アプローチを選ぶ
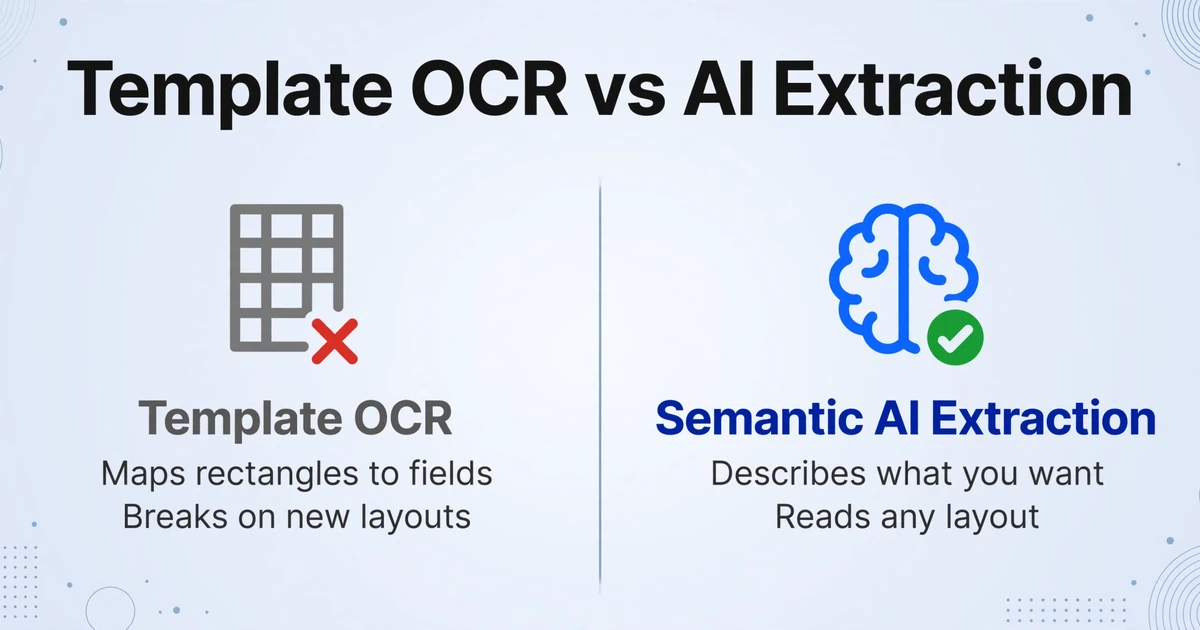
どのドキュメントから始めるかが決まれば、次はツールの選択が、パイロット運用が協力業者との実際のやり取りで通用するかどうかを左右します。この2つの一般的なアプローチは、建設関連の書類では大きく異なる動作をします。
テンプレート型およびゾーン型OCRツールは、既知のフォーム上の各フィールドに矩形をマッピングします。これは、レイアウトの数が少なく安定している場合に有効ですが、建設業界はそうではありません。10人の下請け業者がいれば10種類の請求書レイアウトが存在し、そのうちのいくつかは手書きです。ある業者のフォーム用に作られたテンプレートは、次の業者のフォームでは何の役にも立ちません。新しいベンダーが増えるたびにメンテナンスは増え、テンプレートは誰かが最後に描き忘れたフォーマットと同じ程度の精度しかありません。テンプレートベースのOCRとAI抽出の違いについては、下請け業者請求書におけるAI抽出と会計テンプレートの比較で詳しく解説しています。
セマンティックAI抽出は、その前提を逆転させます。値がどこにあるかを記述する代わりに、何が欲しいかを記述します。これがカスタム列抽出です。「Sub Name」「Retainage」「Cost Code」「Expiration Date」など、必要な列名を入力すると、AIが各ドキュメントを読み取り、ページ上のどこに表示されていても、送信者がどのようにラベル付けしていても、その列の意味に一致する値を特定します。入力した列名が出力テーブルのヘッダーになるため、スプレッドシートはERPが期待するフィールドと、整形の手間なく一致します。
このアプローチをデモではなく建設オフィスに適したものにする2つの機能があります。バッチ処理は、多数のファイルを一度に受け入れ、その結果を単一のスプレッドシートに統合します。これは、月末にドキュメントが1件ずつではなく、実際に届く方法に合致しています。また、カスタム列は推論値をサポートしているため、「Cost Code (options: Concrete/Steel/Wood Framing/Finishes/Other)」のような列を定義し、請求書にコードが印刷されていない場合でも、AIがドキュメントの内容からカテゴリを割り当てることができます。抽出と分類が同じパスで完了します。
ファイルは安全に処理され、保存されることはありません。
デモは請求書から始まります。なぜなら、それが通常、企業が最初にテストするドキュメントだからです。同じ仕組みで、手書きの日報、ACORD 25、WH-347も処理できます。列名を変更してファイルをアップロードするだけです。このツールは請求書に特化したものではありません。だからこそ、単一のパイロットをステップ1のリストの残り全体に拡張できるのです。
ステップ4: 1つのドキュメントタイプでパイロットを実施し、拡大前に検証する
パイロットはデモではなく、検証作業です。ステップ2で最もスコアが高かったドキュメントを選び、実際のサンプル20〜30件を抽出にかけ、出力をソースドキュメントとフィールドごとに比較します。複数の送信元からのファイルを使用し、乱雑なものも含めてください。撮影された請求書、汚れたカーボンコピー、これまで取引のない代理店からの証明書などです。きれいなサンプルでのパイロットは、12月の状況については何も教えてくれません。
検証こそ、レビュー層が価値を発揮する場です。ImageToTable.aiにはBbox-assisted verificationが含まれており、特定のセルを生成した元ドキュメント上の正確な位置をハイライト表示します。値にホバーまたはタップすると、ソースの位置が双方向で強調表示されるため、レビュー担当者はページ全体を読み直すことなく、保留金の金額や有効期限を確認できます。この位置特定はドキュメントごとに手動でトリガーすることも、処理後に自動で実行するよう設定して、レビュー担当者がファイルを開いたときに準備完了の状態にしておくこともできます。
開始前に合格基準を設定してください。パーセンテージではなく、ワークフローの通貨で設定します。「下請け業者の請求書の全フィールドが25件中24件で正確である」という基準は、コントローラーが行動に移せるものです。修正が必要な1件は、パイロットの失敗ではありません。それは手書きを読むシステムの正直な出力であり、レビューステップが存在する理由です。
パイロット計画には、初日から2つの制限を含めるべきです。ビジョンモデルが見たことのない形式で届いたドキュメントは、より鮮明な写真として再アップロードが必要になる場合があります。また、裏書が実際に補償範囲を拡張するかどうかなど、リスクの高いコンプライアンス判断は、フィールドの捕捉がどれほど正確であっても、抽出ステップの仕事ではありません。それらは担当者に残されます。
ステップ5:監視する習慣にしてから、次のドキュメントへ拡大する
最初のドキュメントタイプで方法が証明され、2つ目でプラットフォームが証明されます。パイロット後は、ドキュメントタイプごとに1つの数値を追跡します。それは、修正なしでレビューを通過するファイルの割合です。請求書が基準値を上回っていれば、ランキングから次の候補を追加し、同じ列ベースの設定を再利用します。日報、タイムシート、COIにはそれぞれ独自の列名が必要ですが、いずれも新しいツールは必要ありません。
出力は、すでに運用しているシステムにそのまま残ります。抽出ではExcel、CSV、JSONが生成され、これらはERPや原価管理ソフトウェアが期待するインポート構造にマッピングされます。オフィスがスプレッドシートで作業している場合は、Google Sheetsアドオンが抽出した行をアクティブなシートに直接書き込みます。抽出結果を人ではなくソフトウェアに渡す必要がある場合は、公開APIがアップロード、バッチ処理、ステータスをREST経由で公開し、完了時にはウェブフックで通知されるため、誰もキューをポーリングする必要がありません。すべての統合におけるポイントは同じです。データは誰かの手を経由せずにフォーマットのギャップを越えます。建設ドキュメントで利用可能なプラットフォームの比較を広く確認するには、建設ドキュメント抽出ツールのテスト済み総まとめをご覧ください。
2つの取り込み機能により、外部関係者からキューまでの距離を短縮できます。Collection Linkは共有可能なURLで、下請け業者や現場従業員がログインなしでファイルを直接アカウントにアップロードでき、転送の手間を省きます。Email Inboxは各アカウントにアドレスを提供し、転送された添付ファイルや転送された請求書メールを受け取って処理に直接投入し、送信者ホワイトリストも任意で設定できます。どちらも抽出が始まる前の処理を減らし、ドキュメントを他のすべてと同じキューに保持します。
建設業におけるデジタル変革のロードマップは、購入するプラットフォームのリストではありません。キーストロークから行への変換対象となるドキュメントタイプの順序であり、それぞれがレビューに耐えることが証明されるたびに1つずつ拡大していくものです。
ドキュメント自動化が解決しないこと
抽出はフォーマットのギャップを埋めます。しかし、ワークフローのすべてのギャップを埋めるわけではなく、それを前提にしたロードマップはパイロットで失敗します。
プロジェクト管理やERPシステムの代わりにはなりません。 Procoreは引き続きコミットメントを保持し、Sageは元帳を保持し、抽出はそれらにデータを供給するものであり、競合するものではありません。承認ルーティング、条件付きロジックによる三者照合、または完全なAPワークフローが必要な場合、それは既存のプラットフォームまたは専門システムに存在するものであり、抽出ステップにはありません。
コンプライアンスの判断は行いません。 抽出はACORD 25から保険証券番号、限度額、裏書フォーム番号、満了日を構造化された行に取り込むことができます。しかし、証明書が指定する裏書が実際に完了した作業の補償を提供するかどうかを判断することはできず、リーエン放棄額がそれが決済する請求書と一致するかを検証することもできません。これらは文書横断的またはポリシー上の問題であり、リスクマネージャーまたはコントローラーが担当します。抽出が変えるのは、その判断に必要なデータが4つのPDFに分散するのではなく、1つのテーブルに収まることです。これにより、担当者はより迅速に判断できるようになります。
難しい文書では100パーセントに達しません。 印刷された表データは高い精度で抽出されます。汚れたフォーム上の密集した手書き文字はより難しく、そのためにレビューステップが存在します。現実的な約束は完全な自動化ではありません。かつてすべての値を手入力していた担当者が、難しい値だけをチェックするようになることです。
すでに壊れていたプロセスを修正することはありません。 材料購入がどのコストコードに属するかを誰も知らない場合、データ取得の高速化はより速い意見の相違を生むだけです。抽出はキーボード入力を排除します。これは現実的で測定可能なコスト削減です。御社のビジネスがコードを設定し、承認し、支払う方法についての決定は、引き続き御社に属します。
よくある質問
建設デジタル変革の最初のステップは何ですか?
最初のステップは、文書データの取得を後回しにしないことです。プラットフォームの外部から届き、手入力が必要な文書を洗い出し、消費する工数でランク付けし、最もコストが高いものから自動化します。ファイルがすでにデータ化されていることを前提としたプラットフォームの導入では、バックオフィスを停滞させる手入力を排除することはできません。
OCRは手書きの建設文書でも機能しますか?
文字の形を照合する従来のOCRは、手書き文字を苦手としています。ImageToTable.aiの背後にあるビジョンモデルのアプローチは、印字テキスト、手書き文字、表、チェックボックスを同じパスで読み取るため、型紙の請求書用に構築した列セットが手書きの日報にも対応します。密度が高かったり、かすれた手書き文字の精度は印字された表よりも低いため、そのようなファイルではレビューモードが重要になります。
最初に自動化すべき建設文書はどれですか?
量、文書あたりのフィールド数、フォーマットのばらつき、そのデータを待つ人数のスコアが最も高い文書から始めてください。多くのゼネコンにとって、これは下請け業者の請求書、日報、またはタイムシートを指し、ACORD 25の証明書は、量が少なくても支払いとコンプライアンスを阻害するため、そのすぐ後ろに続きます。AIA G702のような標準化されたフォームは、2番目または3番目のパイロットとして適していることが多いです。
これはProcore、Sage 300 CRE、またはViewpointを置き換えますか?
いいえ。文書抽出は、既存のプラットフォームが消費するデータを準備します。Excel、CSV、JSONを出力し、Google Sheetsに書き込んだり、REST APIを通じてソフトウェアにデータを供給したりできますが、コミットメント、元帳、承認ワークフローはそれらを所有するシステムに残ります。抽出は、外部文書とシステム間の手入力を排除するだけで、それ以上のことは行いません。
各下請け業者の請求書フォーマット用にテンプレートを作成する必要がありますか?
いいえ。Custom Column Extractionは、文書のレイアウトではなく、入力する列名によって出力を定義するため、同じ設定でQuickBooksの請求書と手書きのチケットを読み取ることができます。テンプレートおよびゾーンOCRツールでは、フォーマットごとのマッピングが必要であり、これが新しい下請け業者を追加するたびに増大するメンテナンスコストになります。
機能するかどうかを確認するまでのパイロット期間はどのくらいですか?
1つの文書タイプの実際のファイルを20〜30件抽出にかけ、出力を元のファイルとフィールドごとに比較してください。ほとんどのチームはこれを数日で完了でき、その結果は、営業デモの印象ではなく、数値化できる合格率です。1つの文書タイプで、そのアプローチが実際の書類業務に耐えうるかを判断するには十分です。
建設デジタルトランスフォーメーションで価値を得る企業は、最も多くのソフトウェアを購入した企業ではありません。最初のドキュメントを慎重に選び、そのデータを行に抽出し、次のページに進む前に結果を検証した企業です。順序が正しければロードマップは短くなります。外部ドキュメントをマッピングし、労力でランク付けし、フォーマットに依存しない抽出アプローチを選び、1つをパイロットし、それが維持されたら拡大するだけです。
最初のステップを御社の書類でテストしてください。下請け業者の請求書1枚、日報1枚、証明書1枚をアップロードし、実際に必要な列に名前を付け、再入力のステップがなくなるかどうかを確認してください。御社の書類数枚で始める— テンプレート設定やサインアップは不要です。