Digitale Transformation im Bauwesen
beginnt mit einem Dokument
Einundsechzig Prozent der Bauunternehmen nutzen bereits KI oder planen, ihre Ausgaben dafür in diesem Jahr zu erhöhen, und 45 Prozent dieser Aktivität entfällt auf Büro- und Verwaltungsarbeit, so der AGC and Sage 2026 Construction Hiring and Business Outlook. Das Geld fließt. Die Reihenfolge ist der Punkt, an dem Projekte ins Stocken geraten, denn die erste Plattform, die viele Auftragnehmer kaufen, setzt voraus, dass die Dateien bereits Daten sind, während die Dokumente, die das Backoffice verstopfen, als PDFs, Handyfotos und Durchschlag-Feldformulare ankommen, die immer noch von Hand gelesen und abgetippt werden müssen.
Wichtigste Erkenntnisse
- Einundsechzig Prozent der Bauunternehmen investieren in KI, und 45 Prozent davon fließen in Büroarbeit, wo Rechnungen und Tagesberichte weiterhin von Hand abgetippt werden.
- Ihre Plattform hat den Workflow digitalisiert, den sie selbst besitzt, liest aber nie die Subunternehmer-Rechnung oder den Versicherungsnachweis, die von außen kommen – so wirkt die Softwareliste vollständig, während der Schreibtisch manuell bleibt.
- Das zuerst zu automatisierende Dokument ist das mit der längsten Warteschlange von Personen, die auf seine Daten warten – nicht das, das in einer Demo am besten aussieht.
Warum die digitale Transformation im Bauwesen am Abtipp-Schritt scheitert
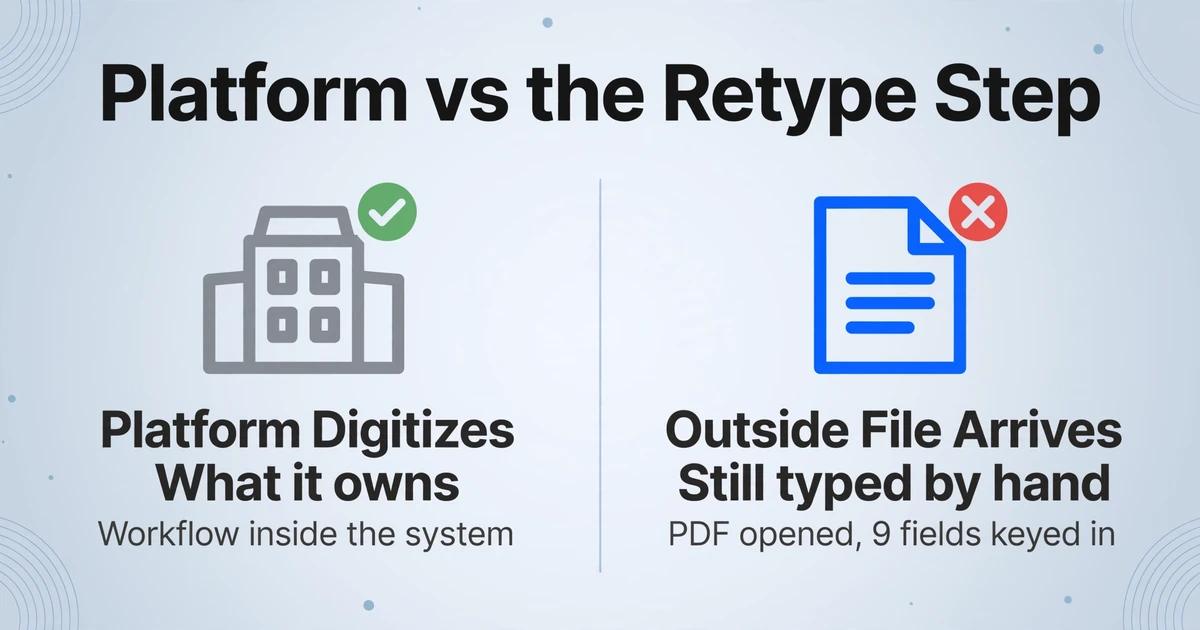
Die Bauplattformen wurden gebaut, um zu verwalten, was in sie hineingelangt – nicht, um zu lesen, was von außen ankommt. Procore, Sage 300 CRE, Viewpoint Vista und Autodesk Construction Cloud verwalten die Vergabe, die genehmigte Nachtragsänderung und den Leistungsverzeichnisplan. Keine von ihnen liest die Rechnung, die ein Subunternehmer in QuickBooks erstellt hat, den ACORD 25, den ein Versicherungsvertreter per E-Mail geschickt hat, oder den Tagesbericht, den ein Bauleiter mit dem Stift ausgefüllt hat. Diese Dokumente werden von externen Parteien mit externer Software erstellt, und ihre Daten müssen über eine Tastatur in Ihr System gelangen.
Das ist die Lücke, die es wert macht, eine Roadmap für die digitale Transformation aufzuschreiben. Eine Projektmanagement-Plattform digitalisiert den Workflow, den sie besitzt. Sie berührt nicht die Datei, die um 16:40 Uhr am letzten Tag des Monats eintrifft. Das Büro öffnet weiterhin das PDF, liest neun Felder und tippt sie in das ERP. Die Transformation sieht in der Softwareliste vollständig aus und bleibt am Schreibtisch, wo die Arbeit passiert, manuell.
Ein Dokument zu digitalisieren und Daten daraus zu extrahieren sind zwei verschiedene Aufgaben. Scannen verwandelt eine Seite in ein Bild. Extraktion verwandelt die Seite in Zeilen, die ein System nutzen kann – das ist der Teil, den der Abtipp-Schritt von Hand erledigt hat.
Dieses Muster beschränkt sich nicht auf Unternehmen, die Technologie gemieden haben. In einem aktuellen Thread in r/ConstructionManagers war die Zusammenfassung der Branche deutlich: „Bauleiter erledigen tonnenweise Verwaltungsaufgaben manuell. Rechnungsdaten aus PDFs oder manchmal sogar Papier kopieren und einfügen.“ Softwareeinführung und manuelle Dateneingabe koexistieren, weil die Software an der Grenze ihrer eigenen Datenbank endet und die Dokumente außerhalb davon leben.
Eine Wirtschaftsprüfungsgesellschaft, die Bauunternehmer betreut, hat das Volumen in r/Construction in Perspektive gesetzt: „Jeden Monat sehen wir für jeden Kunden hunderte Seiten Rechnungen/Belege, die an die Verwaltung gehen, die sie ausdruckt.“ Drucken, sortieren, eintippen. Die Kette ist lang genug, um ihre eigenen Kosten zu verbergen.
OCR im Bauwesen ist der Einstiegspunkt für eine Roadmap zur digitalen Transformation, weil es den einen Schritt angreift, von dem jedes nachgelagerte System abhängt. Bevor ein Zahlungsantrag abgeglichen, eine Kostennummer belastet oder ein Compliance-Bildschirm ein abgelaufenes Zertifikat markieren kann, müssen die Daten die Seite verlassen. Das zu erreichen ist Schritt eins – und Schritt eins ist die Entscheidung, mit welcher Seite man beginnt.
Schritt 1: Erfassen Sie die Dokumente, die von außerhalb Ihrer Plattform eingehen
Bevor Sie Software auswählen, listen Sie die Dokumente auf, die von außen in Ihr Unternehmen gelangen und am Monatsende als manuelle Tastatureingaben enden. Sie benötigen keine vollständige Aufzeichnungsprüfung. Sie benötigen die wiederkehrenden Dateien, die eine Person liest und neu eintippt – das sind fast immer dieselben acht bis zehn Typen pro Zyklus.
Die folgende Tabelle ist die Kurzliste für einen Generalunternehmer. Ihre eigene Mischung variiert je nach Gewerk und dem Umfang der Eigenleistung, aber die Quellen- und Zielspalten ändern sich selten.
| Dokument | Kommt in der Regel an als | Daten müssen landen in | Felder, die erfasst werden |
|---|---|---|---|
| Subunternehmerrechnung | QuickBooks oder individuelles PDF, manchmal ein Handyfoto | AP in Sage 300 CRE / Viewpoint / Foundation | Subname, Auftragsnummer, Kostenstelle, abgerechneter Betrag, einbehaltener Betrag, Nettobetrag, Rechnungsdatum |
| AIA G702/G703 Zahlungsantrag | Unterschriebenes und gescanntes Formular plus Fortsetzungsblatt | Auszahlungsplan / Auftragskostenbuch | Vertragssumme bis heute, abgeschlossen und eingelagert, einbehaltener Betrag, aktuell fälliger Betrag, Restbetrag bis zur Fertigstellung |
| ACORD 25 Bescheinigung (COI) | PDF von einem Versicherungsmakler | Compliance-Tabelle oder COI-Tracker | Polizzennummer, Versicherer, Deckungsart, Limits, Beginn und Ablauf, zusätzlich versicherte Person |
| Zertifizierte Lohnabrechnung (WH-347) | Gescanntes oder PDF-Report von jedem Sub | Logbuch zur Einhaltung des vorherrschenden Lohns | Arbeitnehmername, Klassifizierung, reguläre und Überstunden, Stundensatz, Bruttolohn, Abzüge |
| Täglicher Baustellenbericht | Handgeschriebene Seite oder Handyfoto | Tagesprotokoll, Lohnabrechnung, Produktionsverfolgung | Kolonne, Stunden nach Gewerk, Geräte-IDs, Lieferungen, abgeschlossene Arbeiten, Sicherheitshinweise |
| Kolonnen-Stundenzettel | Papier, per SMS gesendetes Foto oder Tablet-Formular | Lohnabrechnung und Auftragskosten | Mitarbeiter, Datum, Stunden, Phase oder Kostenstelle |
| Bestellung und Lieferschein | Lieferanten-PDF, Packzettel oder handgeschriebener Lieferschein | Wareneingangslogbuch / Verbindlichkeitenaufzeichnung | Bestellnummer, Lieferant, Artikel, Menge, Einzelpreis, Lieferdatum |
| Lien-Verzicht und Nachtragsangebot | Unterschriebenes, notariell beglaubigtes PDF oder gescanntes Papier | Lien-Verzichtslogbuch / Nachtragslogbuch | Antragsteller, bis Datum, Verzichtstyp, Betrag, Nachtragsnummer, Kostenauswirkung, Unterschriften |
Die Liste erfüllt zwei Aufgaben gleichzeitig. Sie zeigt, wie viel Ihrer monatlichen Arbeitszeit auf die Dokumentenbearbeitung entfällt, und sie trennt die Dateien, die Ihre Plattform bereits erfasst, von denen, die sie nie sieht. Procore hält die Verpflichtung und die genehmigte Nachtragsänderung fest. Es liest jedoch nicht die Rechnung des Subunternehmers oder die Bescheinigung des Agenten. Diese sind die Kandidaten für die Automatisierung, und der nächste Schritt ist zu entscheiden, welcher zuerst bearbeitet wird. Eine ausführlichere Behandlung, wie diese Dokumente mit den Bewertungskriterien eines Generalunternehmers zusammenhängen, finden Sie in unserem Leitfaden zu Dokumentextraktionssoftware für das Bauwesen.
Schritt 2: Ordnen Sie diese Dokumente nach den Kosten, die ihre Erfassung verursacht
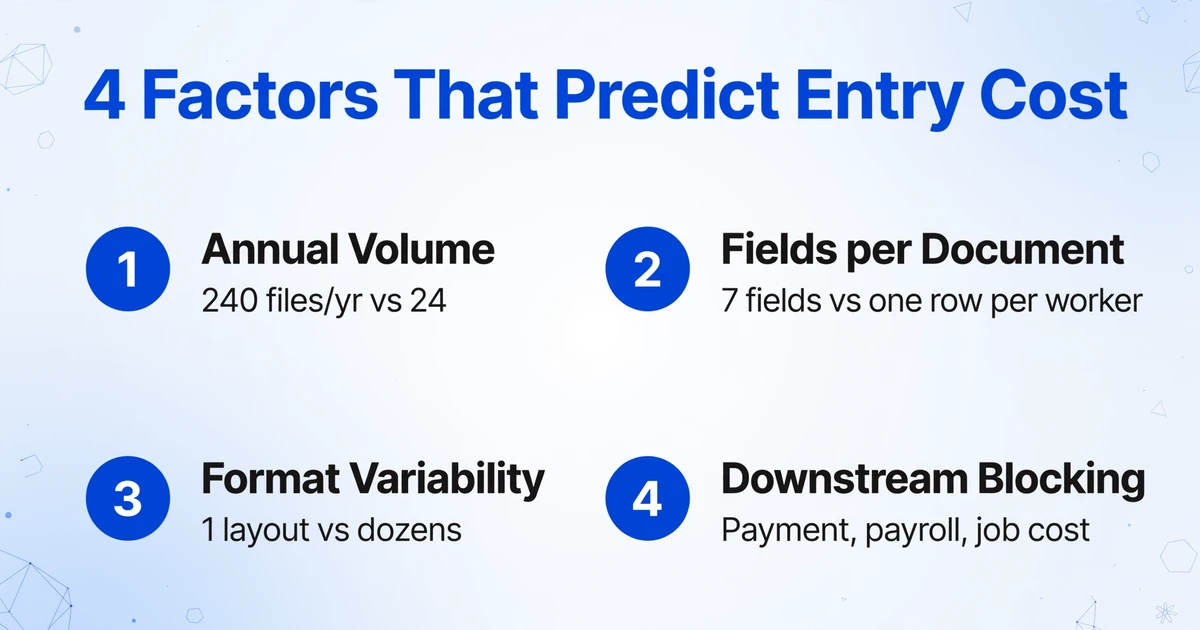
Auftragnehmer wählen das erste Dokument meist nach einer Verkäuferdemo aus, was bedeutet, dass die Datei, die im Verkaufsgespräch am beeindruckendsten wirkt, zuerst kommt. Ein besserer Entscheidungsfaktor ist die Arbeit, die das Dokument verbraucht. Vier Faktoren sagen diese Kosten voraus, und Sie können alle vier anhand der Aufzeichnungen des letzten Monats schätzen, ohne etwas zu kaufen.
Jährliches Volumen
Wie viele dieser Dokumente pro Jahr durchlaufen. Eine Datei, die 240-mal eintrifft, verursacht höhere Bearbeitungskosten als eine, die zweimal im Monat eintrifft, selbst wenn die zweite schwerer zu lesen ist.
Felder pro Dokument
Wie viele Werte gelesen und erfasst werden. Eine einseitige Rechnung mit sieben Feldern verbraucht weit weniger als ein WH-347 mit einer Arbeiterzeile für jede Person im Team.
Formatvielfalt
In wie vielen Layouts und Handschriftstilen das Dokument erscheint. Ein standardisiertes AIA G702 ist ein Format. Ein Stapel von Subunternehmerrechnungen sind Dutzende, und jedes neue Layout erhöht die Lesezeit.
Nachgelagerte Blockierung
Ob eine Person auf diese Daten wartet, um die nächste Aufgabe zu erledigen. Eine nicht erfasste Rechnung verzögert eine Zahlung. Ein nicht erfasster Stundenzettel verzögert die Lohnabrechnung. Ein verspäteter Feldbericht verzögert das Bild der Auftragskosten, nach dem der Eigentümer fragt.
Bewerten Sie jeden Kandidaten von eins bis drei in allen vier Faktoren und addieren Sie sie. Die höchsten Gesamtwerte sind Ihre ersten Automatisierungsziele. Subunternehmerrechnungen, Tagesberichte und Stundenzettel erzielen tendenziell hohe Werte, da sie häufig eintreffen, viele Felder enthalten, im Format variieren und jemanden blockieren. ACORD-25-Bescheinigungen erzielen auch bei geringerem Volumen hohe Werte bei der Blockierung, weshalb sie oft das zweite oder dritte Ziel sind und nicht das erste.
Das Ranking ist wichtig, denn es geht um Rechenaufwand. Eine Seite manuell einzugeben dauert im Durchschnitt etwa drei Minuten. ImageToTable.ai verarbeitet eine Seite in etwa 5 bis 10 Sekunden und meldet bis zu 99 Prozent Erkennungsgenauigkeit bei gedruckten Tabellendaten. Übertragen auf 240 Rechnungen mit jeweils acht Feldern ist der Unterschied keine reine Bequemlichkeit mehr. Die Aufgabe wandelt sich von einer Tätigkeit, die eine Person die ganze Woche beschäftigt, zu einer Tätigkeit, die eine Person nur noch prüft.
Das Dokument, das sich zuerst zu automatisieren lohnt, ist das mit dem höchsten Volumen multipliziert mit der größten Variabilität multipliziert mit der längsten Schlange von Menschen, die auf seine Daten warten. Die Formatkomplexität allein ist nicht das Signal. Wartende Menschen sind es.
Schritt 3: Wählen Sie einen Extraktionsansatz, der Formatvielfalt übersteht
Sobald Sie wissen, mit welchem Dokument Sie beginnen, entscheidet die Wahl des Werkzeugs, ob der Pilotversuch den Kontakt mit Ihren Subunternehmern übersteht. Die beiden gängigen Ansätze verhalten sich bei Baupapierkram sehr unterschiedlich.
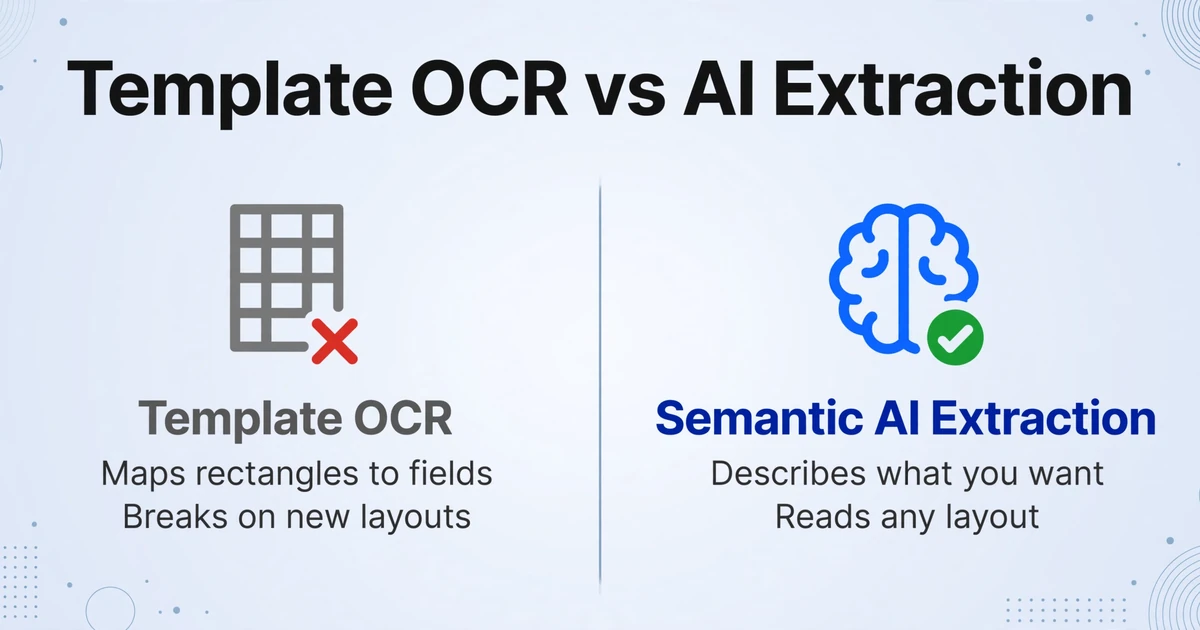
Template- und Zonen-OCR-Werkzeuge ordnen jedem Feld auf einem bekannten Formular ein Rechteck zu. Das funktioniert, wenn die Anzahl der Layouts klein und stabil ist – und das ist im Bauwesen nicht der Fall. Zehn Subunternehmer erzeugen zehn Rechnungslayouts, ein paar davon handschriftlich, und ein Template, das für das Formular eines Subunternehmers erstellt wurde, liefert beim nächsten Subunternehmer nichts Brauchbares. Der Wartungsaufwand wächst mit jedem neuen Anbieter, und ein Template ist nur so gut wie das letzte Format, das jemand zu zeichnen gedacht hat. Der Unterschied zwischen template-basierter OCR und KI-Extraktion wird in unserem Vergleich von KI-Extraktion und Buchhaltungsvorlagen für Subunternehmerrechnungen ausführlicher behandelt.
Semantische KI-Extraktion kehrt die Annahme um. Statt zu beschreiben, wo ein Wert sitzt, beschreiben Sie, was Sie wollen. Das ist Custom Column Extraction: Sie geben die Spaltennamen ein, die Sie benötigen, „Sub Name", „Retainage", „Cost Code", „Expiration Date", und die KI liest jedes Dokument und lokalisiert den Wert, der der Bedeutung der Spalte entspricht, wo auch immer er auf der Seite erscheint und wie auch immer der Absender ihn bezeichnet hat. Die Spaltennamen, die Sie eingeben, werden zu den Kopfzeilen Ihrer Ausgabetabelle, sodass die Tabelle den Feldern entspricht, die Ihr ERP erwartet, ohne einen Umformulierungsschritt.
Zwei Funktionen machen den Ansatz für ein Bauunternehmen geeignet und nicht nur für eine Demo. Batch processing akzeptiert viele Dateien auf einmal und führt die Ergebnisse in einer einzigen Tabelle zusammen, was der Art entspricht, wie Dokumente tatsächlich zum Monatsende eintreffen, statt einzeln. Und benutzerdefinierte Spalten unterstützen abgeleitete Werte, sodass Sie eine Spalte wie „Cost Code (Optionen: Concrete/Steel/Wood Framing/Finishes/Other)" definieren können und die KI die Kategorie aus dem Inhalt des Dokuments zuweist, selbst wenn die Rechnung nie einen Code gedruckt hat. Extraktion und Klassifizierung erfolgen im selben Durchlauf.
Dateien werden sicher verarbeitet und nicht gespeichert.
Die Demo beginnt mit einer Rechnung, weil das in der Regel das erste Dokument ist, das ein Unternehmen testet. Derselbe Mechanismus verarbeitet einen handschriftlichen Tagesbericht, ein ACORD 25 oder ein WH-347. Sie ändern die Spaltennamen und laden die Dateien hoch. Nichts an dem Tool ist rechnungsspezifisch – genau das macht einen einzelnen Pilotversuch auf den Rest der Liste aus Schritt 1 erweiterbar.
Schritt 4: Pilotieren Sie einen Dokumenttyp und verifizieren Sie, bevor Sie skalieren
Ein Pilotversuch ist eine Verifikationsübung, keine Demo. Wählen Sie das am höchsten bewertete Dokument aus Schritt 2, führen Sie 20 bis 30 reale Beispiele durch die Extraktion und vergleichen Sie die Ausgabe Feld für Feld mit den Quelldokumenten. Verwenden Sie Dateien von mehr als einem Absender und schließen Sie die unordentlichen ein: die fotografierte Rechnung, den verschmierten Durchschlag, das Zertifikat eines Agenten, mit dem Sie noch nie zusammengearbeitet haben. Ein Pilotversuch mit sauberen Mustern sagt Ihnen nichts über den Dezember.
Bei der Verifikation zeigt sich, warum eine Prüfebene ihren Platz verdient. ImageToTable.ai umfasst Bbox-assisted verification, das die genaue Stelle im Originaldokument hervorhebt, die eine bestimmte Zelle erzeugt hat. Fahren Sie mit der Maus über einen Wert oder tippen Sie ihn an, und die Quellposition leuchtet auf – in beide Richtungen –, sodass ein Prüfer einen Einbehaltsbetrag oder ein Ablaufdatum bestätigen kann, ohne die ganze Seite erneut zu lesen. Sie können die Lokalisierung pro Dokument auslösen oder so einstellen, dass sie nach der Verarbeitung automatisch läuft, sodass sie bereitsteht, wenn der Prüfer die Datei öffnet.
Legen Sie vor Beginn eine Bestehensgrenze fest, in der Währung des Workflows und nicht als Prozentsatz. „Jedes Feld auf einer Subunternehmerrechnung ist in 24 von 25 Dateien korrekt" ist eine Schwelle, mit der ein Controller arbeiten kann. Die eine Datei, die korrigiert werden muss, ist kein Scheitern des Pilotversuchs. Sie ist das ehrliche Ergebnis eines Systems, das Handschrift liest, und sie ist der Grund, warum es den Prüfschritt gibt.
Zwei Grenzen gehören von Tag eins in den Pilotplan. Ein Dokument, das in einem Format ankommt, das kein Vision-Modell je gesehen hat, muss möglicherweise als klareres Foto neu hochgeladen werden. Und risikoreiche Compliance-Entscheidungen – etwa ob ein Zusatz die Deckung tatsächlich erweitert – sind nicht die Aufgabe des Extraktionsschritts, egal wie genau die Felderfassung ist. Diese bleiben bei einer Person.
Schritt 5: Machen Sie es zur überwachten Gewohnheit und erweitern Sie dann auf das nächste Dokument
Der erste Dokumenttyp beweist die Methode. Der zweite beweist die Plattform. Nach dem Pilotprojekt verfolgen Sie eine Kennzahl pro Dokumenttyp: den Anteil der Dateien, die die Prüfung ohne Korrektur bestehen. Wenn Rechnungen über Ihrer Schwelle bleiben, fügen Sie den nächsten Kandidaten aus der Rangliste hinzu und verwenden dasselbe spaltenbasierte Setup. Tagesberichte, Stundenzettel und COIs benötigen jeweils eigene Spaltennamen, und keiner von ihnen benötigt ein neues Tool.
Die Ausgabe bleibt in den Systemen, die Sie bereits betreiben. Die Extraktion erzeugt Excel, CSV und JSON, die sich in die Importstrukturen Ihres ERP und Ihrer Projektkosten-Software einfügen. Wenn das Büro mit Tabellenkalkulationen arbeitet, schreibt ein Google Sheets-Add-on extrahierte Zeilen direkt in das aktive Blatt. Wenn die Extraktion Software statt einer Person versorgen soll, stellt die öffentliche API Upload, Batch-Verarbeitung und Status über REST bereit, mit Webhooks bei Abschluss, sodass niemand eine Warteschlange abfragen muss. Der Punkt bei jeder Integration ist derselbe: Die Daten überbrücken die Formatlücke, ohne durch die Hände von jemandem zu gehen. Für einen breiteren Überblick darüber, wie die verfügbaren Plattformen bei Baudokumenten abschneiden, siehe die getestete Übersicht der Tools zur Extraktion von Baudokumenten.
Zwei Erfassungsfunktionen verkürzen den Weg zwischen der externen Partei und Ihrer Warteschlange. Collection Link ist eine teilbare URL, die ein Subunternehmer oder Feldmitarbeiter öffnet, um Dateien direkt in Ihr Konto hochzuladen – ohne Anmeldung auf deren Seite, was eine Weiterleitungsrunde erspart. Email Inbox gibt jedem Konto eine Adresse, die weitergeleitete Anhänge oder weitergeleitete Rechnungs-E-Mails annimmt und sie direkt in die Verarbeitung einfügt, mit optionaler Absender-Whitelist. Beides reduziert die Handhabung, bevor die Extraktion überhaupt beginnt, und beide halten das Dokument in derselben Warteschlange wie alles andere.
Eine Roadmap zur digitalen Transformation im Bauwesen ist keine Liste von Plattformen, die man kaufen soll. Es ist eine Abfolge von Dokumenttypen, die von Tastatureingaben in Zeilen umgewandelt werden, jeweils einzeln erweitert, sobald sich zeigt, dass sie der Prüfung standhalten.
Was Dokumentenautomatisierung nicht behebt
Extraktion schließt die Formatlücke. Sie schließt nicht jede Lücke im Workflow, und eine Roadmap, die etwas anderes behauptet, wird die Pilotphase verlieren.
Sie ersetzt nicht Ihr Projektmanagement- oder ERP-System. Procore hält weiterhin die Verpflichtungen, Sage führt weiterhin das Hauptbuch, und die Extraktion speist diese Systeme, anstatt mit ihnen zu konkurrieren. Wenn Sie Genehmigungsroutinen, Drei-Wege-Abgleich mit bedingter Logik oder einen vollständigen AP-Workflow benötigen, lebt dieser in der Plattform, die Sie bereits besitzen, oder in einem spezialisierten System – nicht im Extraktionsschritt.
Sie trifft nicht die Compliance-Entscheidung. Die Extraktion kann die Policennummer, Deckungssummen, Endorsement-Formularnummer und das Ablaufdatum von einem ACORD 25 in eine strukturierte Zeile übernehmen. Sie kann nicht entscheiden, ob das im Zertifikat genannte Endorsement tatsächlich Completed-Operations-Deckung bietet, und sie kann nicht prüfen, ob der Betrag eines Lien Waivers der Rechnung entspricht, die er begleicht. Das sind dokumentübergreifende oder versicherungspolitische Fragen, die bei einem Risikomanager oder einem Controller bleiben. Was die Extraktion ändert, ist, dass die für diese Entscheidung benötigten Daten in einer Tabelle liegen statt über vier PDFs verteilt zu sein – genau das ermöglicht es einer Person, die Entscheidung schneller zu treffen.
Sie erreicht bei schwierigen Dokumenten keine 100 Prozent. Gedruckte Tabellendaten werden mit hoher Genauigkeit extrahiert. Dichte Handschrift auf einem verschmierten Formular ist schwieriger, und genau dafür gibt es den Prüfschritt. Das realistische Versprechen ist nicht perfekte Automatisierung. Es ist, dass die Person, die früher jeden Wert abgetippt hat, jetzt nur noch die schwierigen Werte prüft.
Sie behebt keinen Prozess, der bereits kaputt war. Wenn niemand weiß, welcher Kostencode einen Materialeinkauf zugeordnet bekommt, erzeugt schnellere Datenerfassung nur schnellere Uneinigkeit. Die Extraktion entfernt die Tastatur – das ist ein realer und messbarer Kostenfaktor. Die Entscheidungen darüber, wie Ihr Unternehmen codiert, genehmigt und bezahlt, bleiben weiterhin in Ihrem Unternehmen.
FAQ
Was ist der erste Schritt bei der digitalen Transformation im Bauwesen?
Der erste Schritt ist, die Erfassung von Dokumentdaten nicht mehr als Nebensache zu behandeln. Erfassen Sie die Dokumente, die von außerhalb Ihrer Plattform eintreffen und manuell eingegeben werden müssen, ordnen Sie sie nach dem Arbeitsaufwand, den sie verursachen, und automatisieren Sie zuerst das kostenintensivste. Ein Plattformkauf, der davon ausgeht, dass die Dateien bereits Daten sind, beseitigt nicht die manuelle Eingabe, die das Backoffice ausbremst.
Funktioniert OCR bei handschriftlichen Baudokumenten?
Traditionelle OCR, die Zeichenformen abgleicht, hat bei Handschrift Probleme. Der Vision-Modell-Ansatz hinter ImageToTable.ai liest gedruckten Text, Handschrift, Tabellen und Kontrollkästchen in einem Durchgang, sodass ein für eine getippte Rechnung erstelltes Spaltenset auch bei einem handschriftlichen Tagesbericht funktioniert. Die Genauigkeit bei dichten oder verschmierten Handschriften ist geringer als bei gedruckten Tabellen, weshalb der Überprüfungsmodus bei diesen Dateien wichtig ist.
Welches Baudokument sollte ich zuerst automatisieren?
Beginnen Sie mit dem Dokument, das bei Volumen, Feldern pro Dokument, Formatvielfalt und der Anzahl der Personen, die auf seine Daten warten, am besten abschneidet. Für die meisten Generalunternehmer sind das Subunternehmerrechnungen, Tagesberichte oder Stundenzettel, dicht gefolgt von ACORD-25-Zertifikaten, da diese selbst bei geringerem Volumen Zahlungen und Compliance blockieren. Standardisierte Formulare wie das AIA G702 eignen sich oft als zweiter oder dritter Pilot.
Wird dies Procore, Sage 300 CRE oder Viewpoint ersetzen?
Nein. Die Dokumentextraktion bereitet Daten auf, die Ihre bestehende Plattform konsumiert. Sie gibt Excel, CSV, JSON aus und kann in Google Sheets schreiben oder Software über eine REST API speisen, aber der Verpflichtungs-, Hauptbuch- und Genehmigungsworkflow bleibt in dem System, das sie besitzt. Die Extraktion entfernt die manuelle Tastatureingabe zwischen dem externen Dokument und dem System – und sonst nichts.
Muss ich für jedes Rechnungsformat jedes Subunternehmers eine Vorlage erstellen?
Nein. Benutzerdefinierte Spaltenextraktion definiert die Ausgabe über die Spaltennamen, die Sie eingeben, nicht über das Layout des Dokuments. Dasselbe Setup liest also eine QuickBooks-Rechnung und einen handschriftlichen Beleg. Vorlagen- und Zonen-OCR-Tools erfordern dagegen eine Zuordnung pro Format – das sind die Wartungskosten, die mit jedem neuen Subunternehmer steigen.
Wie lange dauert ein Pilot, bevor ich weiß, dass es funktioniert?
Lassen Sie 20 bis 30 echte Dateien eines Dokumenttyps durch die Extraktion laufen und vergleichen Sie die Ausgabe Feld für Feld mit den Originalen. Die meisten Teams schaffen das in wenigen Tagen, und das Ergebnis ist eine Erfolgsquote, die Sie beziffern können, statt eines Eindrucks aus einer Vertriebsdemo. Ein Dokumenttyp reicht aus, um zu beurteilen, ob der Ansatz Ihren tatsächlichen Papierkram übersteht.
Die Unternehmen, die bei der digitalen Transformation im Bauwesen echten Nutzen erzielen, sind nicht diejenigen, die die meiste Software gekauft haben. Es sind diejenigen, die das erste Dokument sorgfältig ausgewählt, dessen Daten in Zeilen extrahiert und das Ergebnis überprüft haben, bevor sie zur nächsten Seite übergingen. Der Fahrplan ist kurz, wenn die Reihenfolge stimmt: die externen Dokumente erfassen, nach Arbeitsaufwand ordnen, einen Extraktionsansatz wählen, der das Format ignoriert, einen Pilotversuch starten und erweitern, sobald er sich bewährt.
Testen Sie den ersten Schritt mit Ihren eigenen Unterlagen. Laden Sie eine Subunternehmerrechnung, einen Tagesbericht und eine Bescheinigung hoch, benennen Sie die Spalten, die Sie tatsächlich benötigen, und prüfen Sie, ob der Schritt des erneuten Abtippens entfällt. Beginnen Sie mit einigen Ihrer eigenen Dokumente ohne Vorlageneinrichtung oder Anmeldung.