2026年おすすめ銀行取引明細書&財務データ
抽出ツール
請求書の抽出は、ほとんどのツールにとって解決済みの問題です。仕入先名、金額、日付を拾い出すだけ。個別のフィールドが1ページに収まります。しかし銀行取引明細書は別物です。複数ページにわたる取引テーブルで、各行がその上の行に依存しています。1ページ目の期首残高から12ページ目の期末残高まで、累積残高が一貫している必要があります。ツールが1件の取引を見落としたり、列を1行ずらしたりすると、明細書全体が照合できなくなります。だからこそ、文字を読むだけで文脈を読まない一般的なOCRは、一見完成しているように見えて、最も基本的な会計テストを満たさないスプレッドシートを生成するのです。つまり、期首残高+入金額−出金額=期末残高、というテストです。
重要なポイント
- この7つのツールはすべて、精度のパーセンテージを前面に打ち出しています。しかし、その数字は、明細書が実際に照合できるかどうかを教えてくれません。
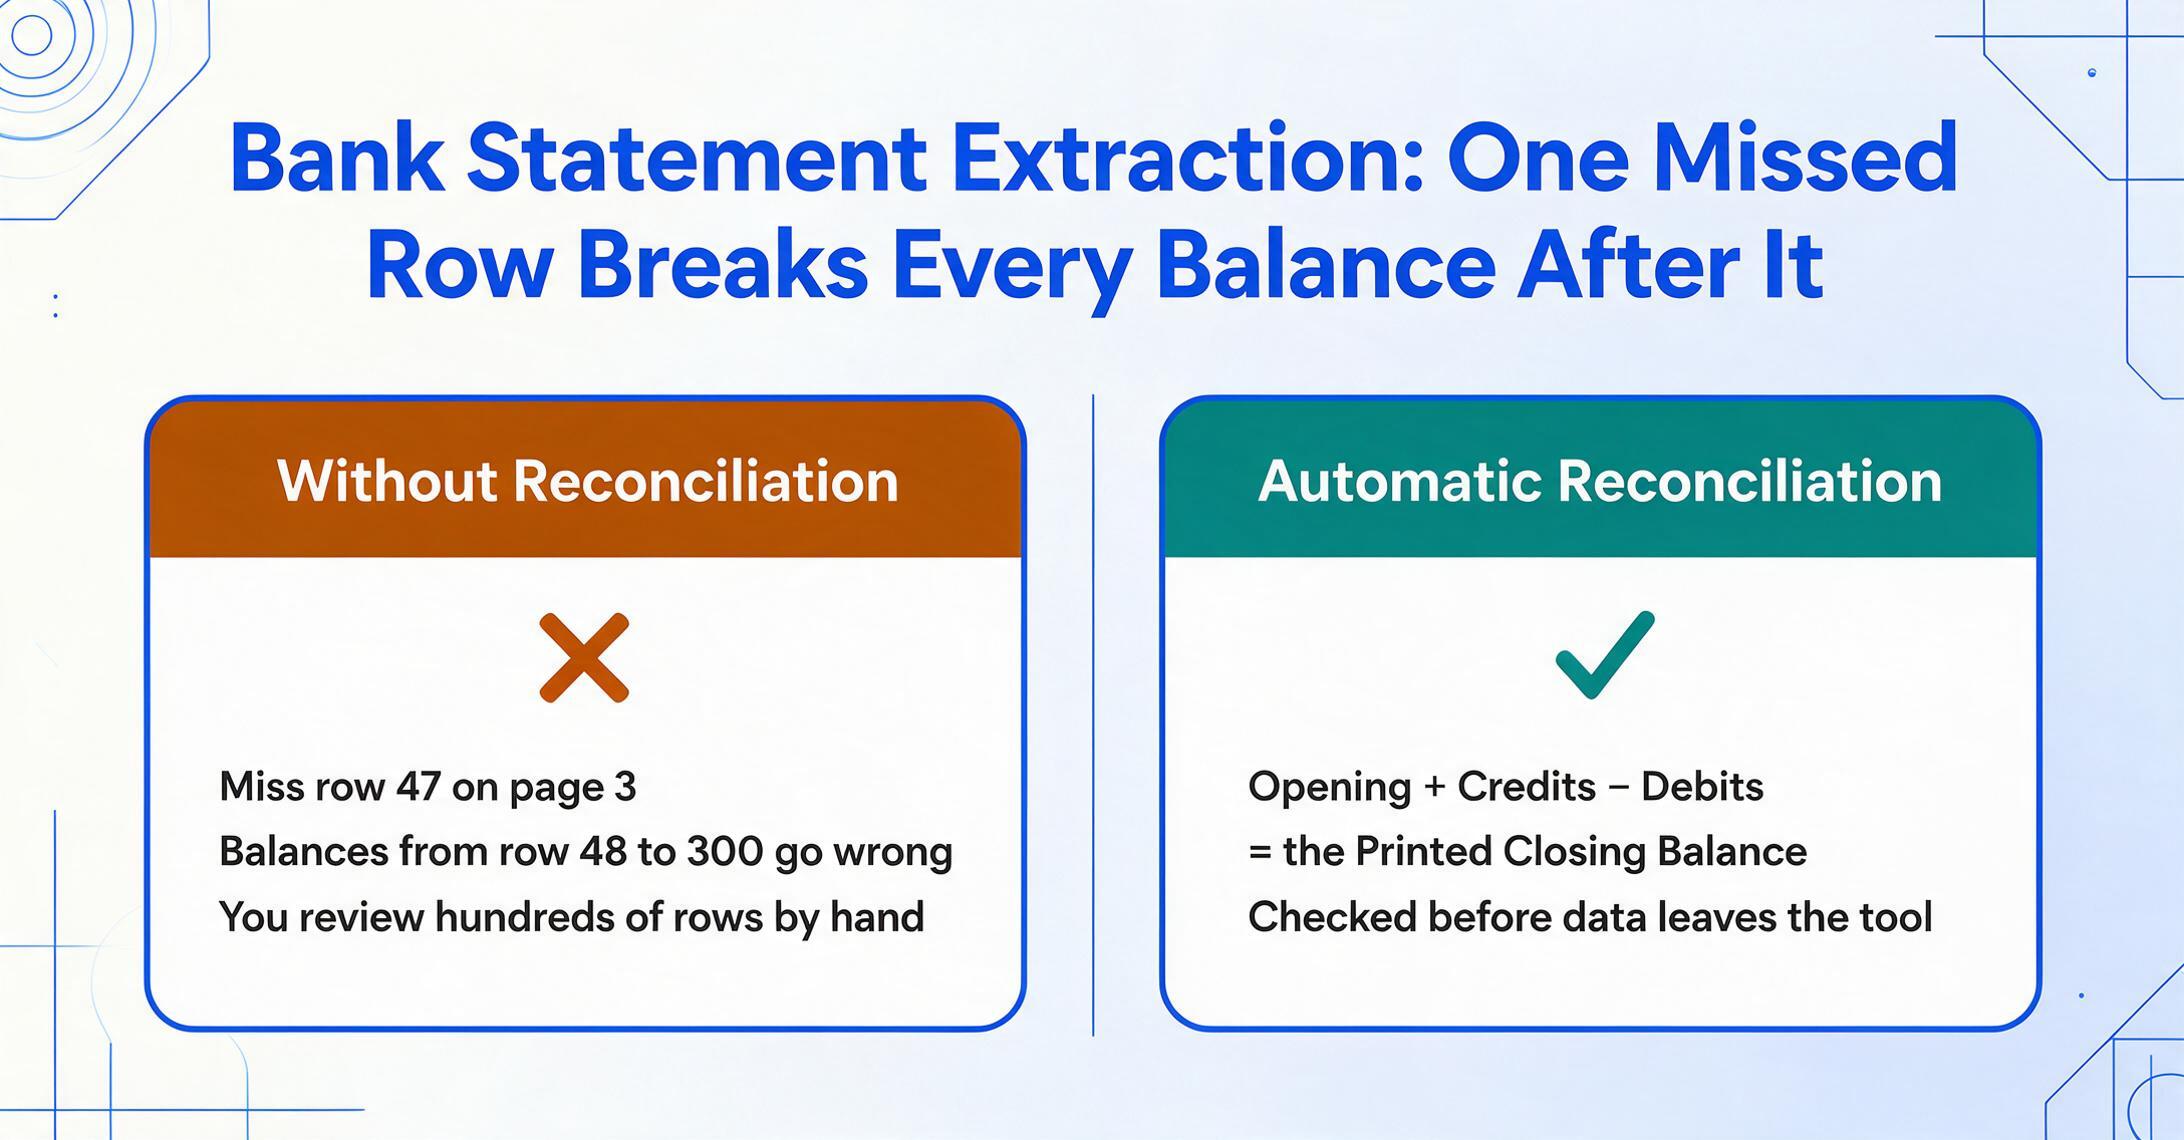
- 12ページの明細書が99%正確でも、役に立たないことがあります。取引を1行でも見落とせば、それ以降の累積残高はすべて静かに間違ったものになります。
- 比較する価値がある唯一の指標は、データが外部に出る前に、ツールが期首残高+入金額−出金額=期末残高をチェックするかどうかです。つまり、抽出に組み込まれた照合であり、後付けの照合ではありません。
銀行取引明細書が汎用OCRでうまくいかない理由 — 代わりに何を重視すべきか
ほとんどの文書抽出ツールは請求書向けに作られています。請求書にはヘッダーブロック(仕入先、日付、合計)と明細行があります。ヘッダー抽出を間違えることはほとんどありません。出力スキーマも一貫しています:明細行ごとに1行、請求書ごとに1行です。しかし銀行取引明細書にはヘッダーブロックがありません。30ページに及ぶ取引テーブルがあり、各行には前の行から計算された累積残高が含まれています。ツールが3ページ目の47行目を見逃したら、48行目から300行目までのすべての残高が間違ったものになります。銀行取引明細書以外にもテーブル中心の文書を扱っているなら、テーブル・フォーム抽出ツールガイドで、このセクションで説明する一般的な構造上の問題を詳しく解説しています。
銀行取引明細書のデータ抽出の技術的な仕組みについてもっと深く知りたい方(銀行取引明細書をExcelに変換するパイプラインをフォーマット横断で構築する方法を含む)は、ステップバイステップの抽出ガイドをご覧ください。要約すると、銀行取引明細書の抽出ツールで最も重要な品質シグナルは、ホームページのマーケティング上のパーセンテージではありません。それは、ツールが自動照合を実行するかどうかです — 抽出した入金額から出金額を差し引き、期首残高に加えた結果が、印刷された期末残高と一致するかを、データがツールから出る前にチェックすることです。これを実行しないツールの場合、負担はあなたにのしかかります:チームが何百もの取引行を1つずつレビューすることになり、自動化の目的が台無しになります。
世界の銀行業界はISO 20022 camt.053(BankToCustomerStatementメッセージ形式)と、その前身であるSWIFT MT940を中心に標準化が進んでいます。これらの標準は、デジタル銀行取引明細書の正確なXMLスキーマを定義しています — 期首残高、期末残高、取引の入金・出金インジケーター、明細書レベルの合計などの構造化フィールドです。しかし、中小企業や個人向けの明細書の大半は、構造化されたXMLではなくPDFとして届きます。抽出ツールの役割は、PDFレンダリングで失われた構造化データを再構築することです。優れたツールは、再構築したデータを明細書自体の合計と照合します — 銀行の内部システムがcamt.053メッセージを公開前に検証するのと同じ方法です。
この問題の現実的な規模を示す例:FlowboostがインタビューしたCPAの1人は、わずか20クライアント分の銀行取引明細書PDFを手動処理するのに月20〜25時間費やしていると報告しました。Redditでは、「銀行取引明細書をPDFから手入力しているのはうちの事務所だけ?」というスレッドが93のアップボートと83のコメントを集め、会計士たちが同じ苦労を語り合いました。あるコメンターはワークフローをこう要約しています:「PDFをダウンロードして、Excelを開いて、全行を入力し、最後に累積残高が一致することを願う。一致しなければ、もう1時間かけて不足している取引を探す」。これは精度の主張だけでは解決できない問題です — 自動検証だけが解決できる照合の問題なのです。
評価方法
今回、デモ通りの性能ではなく、日々の会計業務で重要となる5つの観点から、7つの銀行取引明細書抽出ツールを評価しました。各ツールは以下の項目で評価しています:
- 照合機能:抽出した取引合計が、明細書に記載されている期首残高と期末残高と一致するかを検証できるか。このチェックは自動で行われるか、それとも手動での確認が必要か。
- 対応銀行フォーマット:クライアントが実際に利用している銀行(信用組合、海外の金融機関、古いスキャン明細書を含む)に対応しているか、それとも米国の主要5銀行のみか。
- 出力先:データをQuickBooks Online、Xero、Sageに直接取り込めるか。それとも、すべての明細書がExcelで止まり、追加のインポート作業が必要になるか。
- 設定の手間:銀行フォーマットごとにテンプレートを作成したり、モデルをトレーニングしたり、解析ルールを書いたりする必要があるか。それとも、アップロードした最初の明細書から設定なしで動作するか。
- 料金の透明性と予測可能性:料金が公開されており、1ページまたは1ドキュメント単位で、ボリュームに応じて線形にスケールするか。それとも、見積もりを取るために営業への連絡が必要か。
各ツールを、米国の主要銀行(Chase、Bank of America、Wells Fargo)、地域の信用組合、海外の銀行(Deutsche Bank)からのデジタルおよびスキャンされた銀行取引明細書PDFの混合セットでテストしました。目的は、各ツールがフォーマットの多様性、複数ページの明細書、累積残高のある取引テーブルをどのように処理するかを確認することでした。これは、会計士の受信トレイに届く実際の多様なデータです。
開示:ImageToTable.aiは、この記事でレビューされたツールの1つです。各レビューは、当社自身を含め、長所と限界について正直に書かれています。このリスト内のツールが掲載料を支払ったことはなく、アフィリエイトコミッションがランキングに影響を与えることもありません。
銀行取引明細書抽出ツール比較(2026年)
料金は2026年6月時点のものです。すべての料金は、公開されている料金表がある最も安い月額プランのものです。
| ツール | 開始価格 | 料金モデル | 最適な用途 | 主な制限 | 無料トライアル? |
|---|---|---|---|---|---|
| DocuClipper | $39/月 | ページ単位、段階制 | QuickBooks/Xeroへの直接連携が必要な会計事務所 | モバイルアプリなし。長い明細書ではページ単位のコストがかさむ | 14日間、120ページ |
| Nanonets | 約$499/月 | ページ単位、段階制 | 月5,000ページ以上のエンタープライズチーム | 初期費用が高い。カスタム形式にはモデルのトレーニングが必要 | 無料枠、500ページ |
| Docparser | $39/月 | 文書単位、段階制 | 安定した反復的な銀行レイアウトを持つチーム | テンプレートベース。新しい銀行形式には新しい解析ルールが必要 | 14日間トライアル |
| Parseur | $39/月 | ページ単位、段階制 | メール中心の銀行取引明細書ワークフロー | 下位プランでは複数レイアウトのサポートが限定的 | 無料枠、月20ページ |
| Airparser | $33/月 | クレジット単位、段階制 | 多様な明細書形式に対応するGPTベースの抽出 | ネイティブな会計連携なし。文書タイプによって精度が変動 | 30クレジットのトライアル |
| Affinda | 約$67/月(年払い) | 解析単位、年払い | 複数文書タイプの財務処理 | 銀行取引明細書の抽出は履歴書や請求書より未成熟。年払い契約が必要 | 14日間トライアル |
| ImageToTable.ai | 無料枠+有料 | 利用単位、段階制 | 計算列を使ったテンプレート不要のバッチ処理 | QuickBooks/Xeroへの直接連携なし。スプレッドシートネイティブのみ | 無料枠あり |
料金は2026年6月時点のものです。エントリーティアの月額料金を表示しています。すべてのツールでより高容量のプランが利用可能です。最新の料金は各ベンダーの料金ページをご確認ください。
DocuClipper — 会計事務所・簿記担当者に最適
DocuClipperは、この市場で最も頻繁に引用される銀行取引明細書の抽出ツールです。それもそのはず、最初から金融文書の抽出専用に作られた数少ないツールの一つであり、後から銀行取引明細書対応を追加した汎用パーサーではありません。DocuClipperの詳細な比較はこちら →
得意な点: DocuClipperは、デジタルまたはスキャンされたあらゆる銀行のPDFから取引を抽出し、エクスポート前に自動照合を実行します。このツールは、期首残高+入金額−出金額=期末残高を検証し、不一致をフラグして確認を促します。QuickBooks Online、QuickBooks Desktop、Xero、Sage、Excel、CSVに直接エクスポートできます。上位プランには取引のカテゴリ分類、キャッシュフロー分析、不正検出機能が含まれています。Baker Tilly、BDO、Sikichなど10,000以上の企業に信頼されています。
苦手な点: カメラ撮影に対応したモバイルアプリはなく、デスクトップ/クラウドのワークフローです。ページ単位の料金体系のため、1人のクライアントからの15ページの明細書で月間割り当ての15ページを消費し、通年の明細書を処理する企業には負担がかかります。月額$39のエントリープランには200ページしか含まれていません。
料金: スターター $39/月(200ページ)、プロフェッショナル $74/月(500ページ)、ビジネス $159/月(2,000ページ)。120ページを含む14日間のトライアルあり。
最適なケース: 毎月クライアントの明細書を処理し、スプレッドシートを介さずに出力を直接QuickBooksやXeroに取り込みたい会計事務所や簿記担当者。不向きなケース: 月額最低料金を正当化できない、低頻度・低ボリュームのニーズしかない個人ユーザー。
Nanonets — エンタープライズ規模の銀行取引明細書処理に最適
Nanonetsは、複数の文書タイプにわたって毎月数千の文書を処理する組織向けに構築されたAI搭載の文書処理プラットフォームです。銀行取引明細書の抽出機能は、APIファーストのアーキテクチャとエンタープライズ統合を備えた、より広範なIDPプラットフォームの中に位置づけられています。Nanonetsの詳細な比較はこちら →
得意な点: Nanonetsは、構造化・非構造化文書を高い精度で処理し、特殊な銀行フォーマット向けのカスタムモデルトレーニングをサポートし、自動化パイプライン向けのAPI統合を提供します。SAP、Xero、Sage、NetSuite、QuickBooksに接続でき、1時間あたり数千の文書を処理できます。検証ルールとエラー修正機能を備え、軽量ツールでは対応できない手書き文字や低品質のスキャン文書も処理できます。
苦手な点: 月額$499のエントリーポイントは、小規模事務所や個人の簿記担当者には手が届きません。カスタムユースケースでは初期のモデルトレーニングが必要で、テンプレート不要のツールのように新しい銀行フォーマットをアップロードするだけで即座に結果を得ることはできません。料金体系は複雑で、ブロックベースのクレジットに抽出、フォーマット、ルックアップの料金が別途かかるため、コストの予測が困難です。
料金: プロプラン 月額約$499(5,000ページ)。エンタープライズ向け料金あり。無料ティアには合計約500ページが含まれます。
最適なケース: 請求書やその他の財務文書とともに大量の銀行取引明細書を処理し、API統合を管理する技術リソースを持つ中堅からエンタープライズの財務チーム。不向きなケース: 小規模な会計事務所や個人 — 料金とセットアップの負担が低ボリュームのニーズに対して不釣り合いです。
Docparser — 定型テンプレートの銀行取引明細書ワークフローに最適
Docparserは、ユーザー定義の解析テンプレートを使用してPDFからデータを抽出する、成熟したルールベースの文書解析ツールです。このカテゴリでは最も古い製品(2013年設立)であり、一貫した文書レイアウト向けに十分にテストされたテンプレートエンジンを備えています。Docparserの完全比較を読む →
得意なこと: 同じ金融機関から毎月同じ形式で届く銀行取引明細書の場合、Docparserのテンプレートエンジンは信頼性が高く、予測可能です。特定の銀行レイアウト用の解析ルールを作成すると、その後の明細書はバリエーションなく自動的に処理されます。PDF、Word、画像形式に対応し、CSV、Excel、JSON、XML、Google スプレッドシートにエクスポートできます。このプラットフォームはクラウドストレージと統合し、webhookおよびZapier配信をサポートしています。
苦手なこと: テンプレートのメンテナンスが隠れたコストです。15の異なる銀行の明細書を処理する場合、15の個別の解析テンプレートが必要です。銀行が明細書のレイアウトを更新すると(予想以上に頻繁に発生します)、テンプレートが壊れて再設定が必要になります。多様なクライアント銀行を持つ企業にとって、このメンテナンス負担は時間の節約を帳消しにする可能性があります。Docparserには組み込みの照合チェックもなく、出力の検証は自分で行う必要があります。
料金: スターター $39/月(100文書)、プロフェッショナル $74/月(250文書)、ビジネス $159/月(1,000文書)。14日間の無料トライアル。
最適なケース: 安定した形式の既知の少数の金融機関からの銀行取引明細書を処理する運用チームで、AIよりも決定的なルールベースの抽出を好む場合。不向きなケース: 数十の銀行や信用組合にクライアントが分散している企業 — 形式ごとのテンプレートメンテナンスが管理不能になります。
Parseur — ノーコードのメールからExcelへの銀行取引明細書解析に最適
Parseurは、強力なメール取り込み機能を備えたノーコードの文書処理プラットフォームです。モデルの設定や解析ルールの作成をせずにデータ抽出を始めたい非技術系ユーザー向けに設計されています。Parseurの完全比較を読む →
得意なこと: Parseurの銀行取引明細書向け事前学習済みAIモデルはすぐに使えます — PDFをアップロードすると、ツールが取引、日付、説明、金額を自動的に識別して抽出します。メール解析ワークフローは際立っています:専用のParseurメールアドレスを設定し、銀行取引明細書のPDFを転送すると、到着時に自動的に抽出が行われます。ZapierとMakeを介して6,000以上のアプリに接続し、Excel、CSV、JSON、Google スプレッドシートにエクスポートできます。永久無料プラン(月20ページ)により、評価は本当にリスクなしです。
苦手なこと: マルチレイアウト対応 — 同じワークフロー内で大きく異なる銀行形式の明細書を処理すること — は下位プランでは制限されています。Parseurは主にメールファーストのツールです。銀行取引明細書がクライアントポータル、共有ドライブ、アップロードリンク経由で届く場合、メール転送ワークフローはステップを減らすどころか増やしてしまいます。
料金: $39/月(100ページ、年払い)、$99/月(1,000ページ)、$399/月(10,000ページ)。無料プラン:月20ページが永続的に利用可能。
最適なケース: 銀行取引明細書をメールで受け取り、セットアップなしで自動的に抽出を開始したい小規模企業や個人事業主。不向きなケース: ミドルウェアとしてのZapierなしでQuickBooks/Xeroへの直接統合が必要な企業、または無料プランの上限にすぐ達してしまう大量処理を行う企業。
Airparser — GPTを活用した柔軟な銀行取引明細書抽出に最適
Airparserは、特定の文書タイプ向けの事前学習モデルではなく、GPTベースのLLM抽出を使用するという、異なる技術的アプローチを採用しています。プレーンな英語で抽出したい内容を記述するだけで機能するため、非常に柔軟性が高い一方、財務文書では一貫性にトレードオフがあります。
得意な点: 自然言語によるスキーマ設定は本当に高速です。「各取引行から日付、説明、出金額、入金額、累積残高を抽出して」と入力するだけで、Airparserがそれらのフィールドを探し出します。PDF、画像、Word文書、メール、スプレッドシートに対応し、スキャン文書用のOCRもサポートしています。GPTベースのエンジンは、テンプレートの更新なしでフォーマット変更に適応するため、銀行のレイアウトが予期せず変更された場合にルールベースのツールよりも大きな利点となります。
不足している点: 精度は文書タイプと複雑さによって異なります。複数ページの銀行取引明細書に対するGPT抽出では、ページ間で結果に一貫性がない場合があります。10ページにわたる取引テーブルでは、2ページ目と7ページ目で列の解釈が異なる可能性があります。Airparserには会計ソフトウェアとのネイティブ統合がなく、出力はCSV、Excel、またはJSONで、別途インポート手順が必要です。照合チェック機能がないため、出力を手動で検証する必要があります。
料金: Starter $33/月(100クレジット、年払い)、Growth $49/月(500クレジット)、Business $149/月(2,000クレジット)。30クレジットの無料トライアルあり。1クレジット = PDF1ページ、画像1枚、またはメール1通です。
最適なユーザー: 多種多様で予測不可能なフォーマットの明細書を処理し、フォーマットごとの設定なしで適応できる柔軟な抽出ツールを必要とするユーザー。 不向きなユーザー: 抽出の一貫性と会計ソフトウェアへの直接統合が必須である、本番の会計ワークフローを運用するユーザー。
Affinda — 複数文書タイプの財務抽出に最適
Affindaは、AI文書処理プラットフォームで、履歴書の解析で最もよく知られていますが、口座明細書、財務諸表、請求書、契約書向けの抽出モデルも提供しています。強みは、特定の分野への深い特化ではなく、単一プラットフォームで多様な文書タイプを処理できることです。
得意な点: Affindaの事前構築済み口座明細モデルは、銀行およびクレジットカード明細書から取引レベルのデータを抽出し、プラットフォームは自然言語による検証ルールをサポートしています。例えば、「確認のため$5,000を超える取引にフラグを立てる」などです。ヒューマン・イン・ザ・ループのレビューインターフェースにより、下流システムにデータが入る前に、信頼度の低い抽出結果を検証できます。AffindaはSOC 2 Type IIおよびISO 27001認証を取得しており、コンプライアンス要件がある企業にとって重要です。
不足している点: 銀行取引明細書の抽出はAffindaの主な強みではありません。プラットフォームは履歴書の解析、請求書処理、ID文書の抽出により深く投資しています。年間料金モデル(最低$800/年)は、銀行取引明細書の抽出品質を十分に評価する前に契約を固定化します。QuickBooksやXeroとのネイティブ統合はなく、出力はAPI、CSV、またはExcel経由です。非同期APIモデルは、同期抽出ツールと比較してレイテンシーが追加されます。
料金: 約$800/年(6,000回の解析、年払い)、$18,000/年(780,000回の解析)までスケール。14日間の無料トライアル。
最適なユーザー: 銀行取引明細書を履歴書、契約書、ID文書とともに処理し、すべての文書タイプに対して単一の抽出プラットフォームを必要とする組織。 不向きなユーザー: 照合チェックやQuickBooksへの直接プッシュなど、銀行取引明細書に特化した機能を必要とする会計事務所。
ImageToTable.ai — テンプレート不要・計算列対応のバッチ処理に最適な銀行取引明細書ツール
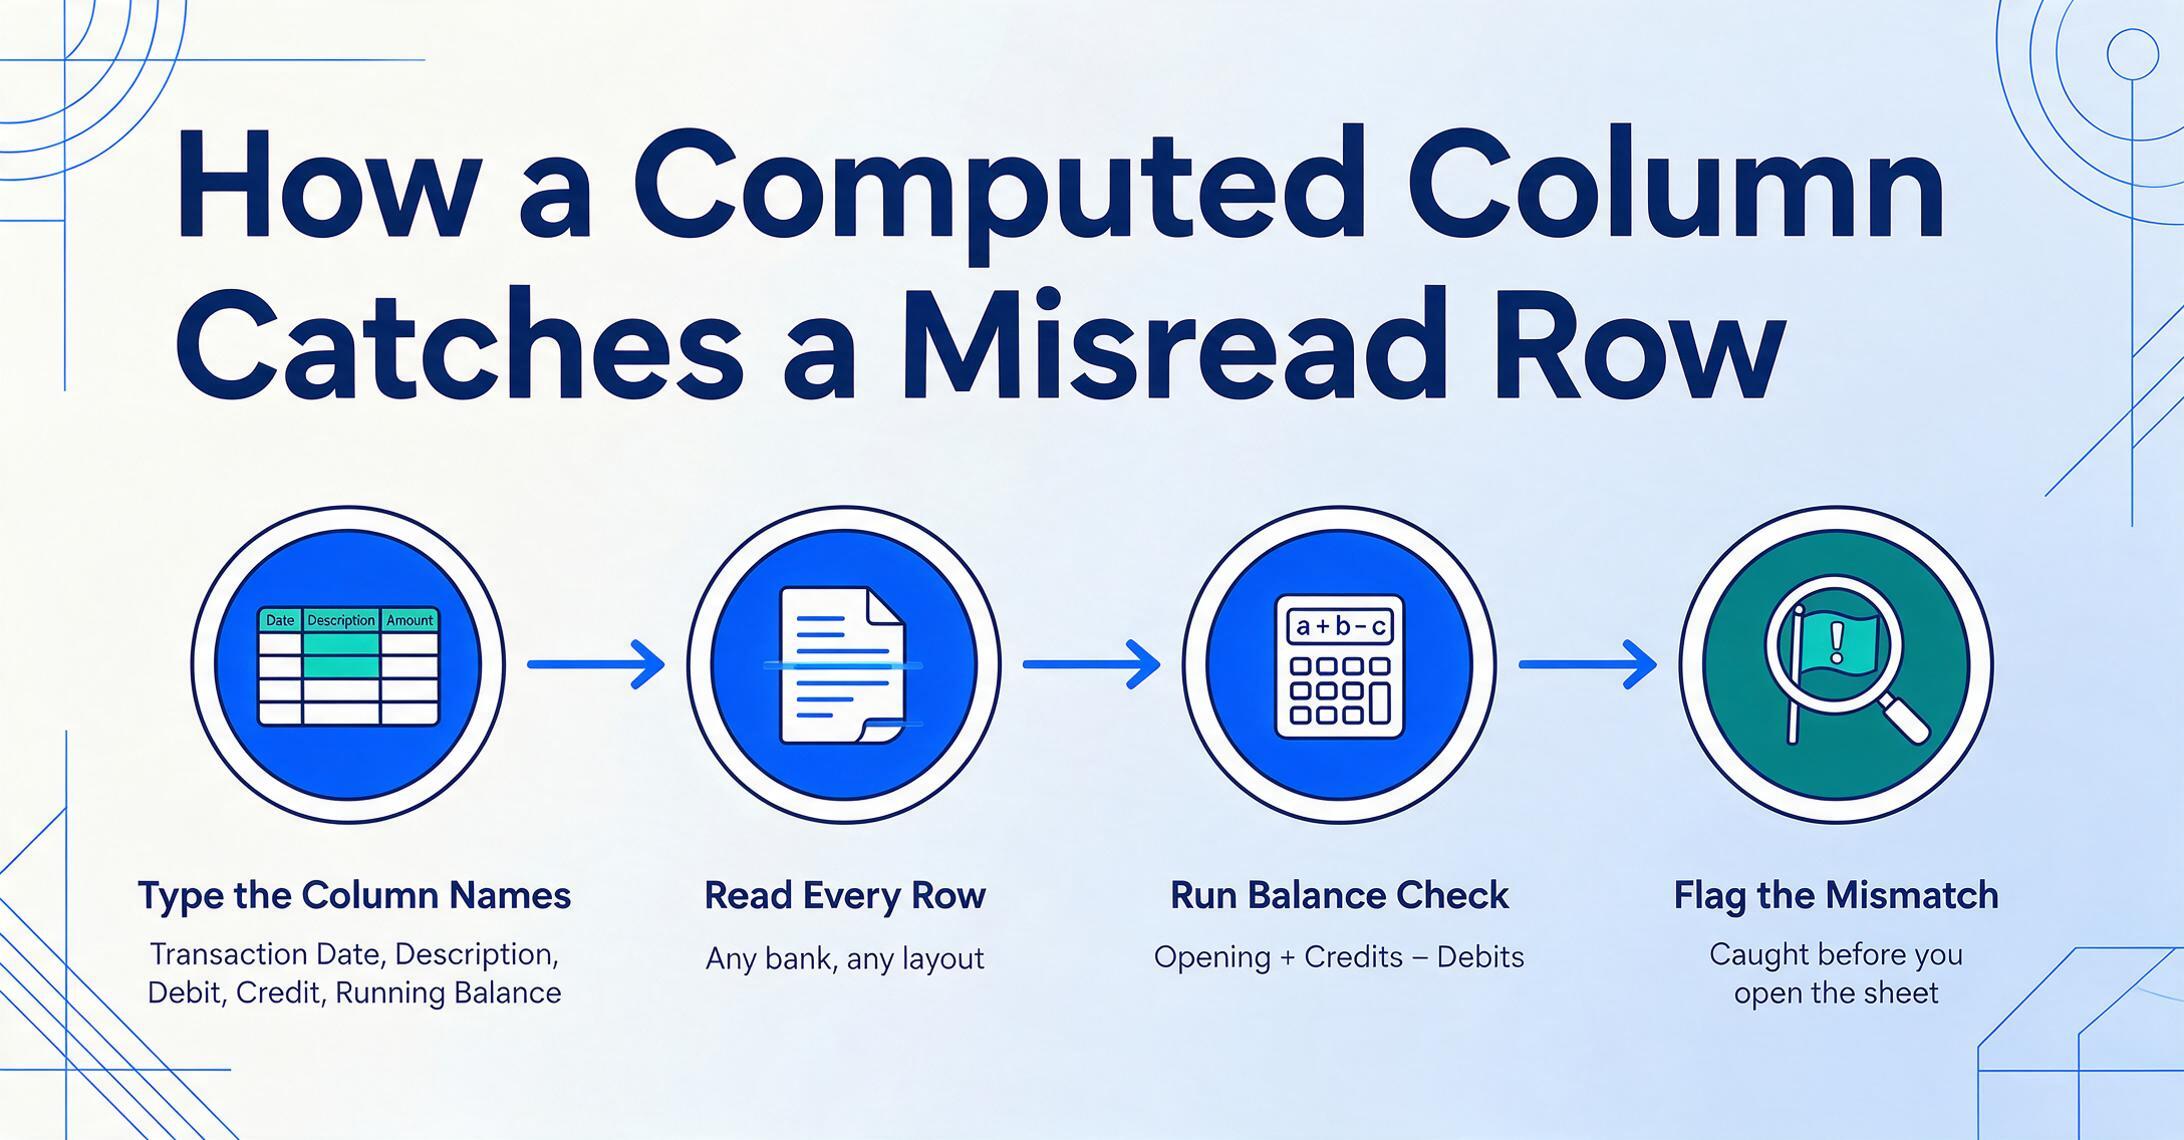
ImageToTable.aiは、銀行取引明細書の抽出に対して根本的に異なるアプローチを取ります。事前学習済みモデル、解析テンプレート、トレーニングデータセットを必要とする代わりに、カスタム列抽出を使用します。「取引日」「説明」「出金額」「入金額」「累積残高」など、必要な列名を入力するだけで、AIが文書内のどこにあっても各フィールドをその意味を理解して特定します。これは位置ベースの抽出ではなくセマンティックベースの抽出です。文書のレイアウトは関係ありません。
得意なこと: テンプレート不要のアプローチにより、メガバンク、地方銀行、信用組合、海外の銀行など、あらゆる銀行の取引明細書をフォーマットごとの設定なしで処理できます。バッチ処理はコアワークフローに組み込まれています。複数の口座から12ヶ月分の取引明細書をアップロードすると、ツールは抽出されたすべての取引を、一貫した列ヘッダーを持つ1つの統合Excelスプレッドシートにマージします。
計算列機能は、銀行取引明細書の作業に特に役立ちます。抽出中に照合チェックを実行する列を定義できます。たとえば、残高チェック(期首残高+入金額−出金額)という名前の列は、各行の累積残高がその上の行と一致しているかを計算します。取引が誤読された場合、計算列はスプレッドシートを開く前にそれを検出します。銀行取引明細書に役立つ他の計算列には、単一の金額列を使用する明細書用の取引タイプ(出金または入金)や、抽出された期末残高が印刷された期末残高と一致する場合に「はい」を出力する照合済み?などがあります。これは、抽出が信頼できるかどうかを示す単一セルのシグナルです。カテゴリ(オプション: 給与/消耗品/光熱費/家賃/その他)のような推論列を定義して、説明文から取引を自動分類することもできます。抽出と分類を1回のパスで実行できます。
コレクションリンク機能は、共有可能なアップロードページを生成します。銀行取引明細書のPDFを送る必要があるクライアントにリンクを送信すると、アカウントを作成することなく、ファイルが直接処理キューに届きます。
短所: ImageToTable.aiには、QuickBooks、Xero、Sageへの直接統合はありません。出力はExcel、CSV、またはJSONで、会計ソフトウェアへのインポートは別途行う必要があります。また、金融文書専用に作られているわけではなく、あらゆる文書タイプを処理するため、DocuClipperが長年の金融文書特化開発で築いてきた専門的な不正検出、キャッシュフロー分析、銀行フォーマット固有のヒューリスティックが不足しています。主なニーズが、カテゴリ分類と分析が組み込まれた専用の銀行取引明細書→QuickBooksパイプラインである場合、専用ツールの方が適しています。
料金: 無料プランあり、高ボリューム向けの有料プランあり。銀行テンプレートごとの料金はありません。テンプレート不要モデルにより、1つのプランで任意の数の銀行フォーマットをカバーできます。
最適な用途: さまざまな銀行の銀行取引明細書を処理する会計士、簿記担当者、小規模事業主向け。テンプレート不要の抽出、バッチ結合、計算列による照合を、スプレッドシート中心の単一ワークフローで実現したい方に最適です。コレクションリンク機能は、複数のクライアントから明細書を収集する事務所に特に強みを発揮します。不向きなケース: 手動インポートを介さずQuickBooks/Xeroへ直接連携する必要があるチーム、または銀行固有の不正検出やキャッシュフロー分析が抽出ツールに組み込まれていることを求める事務所。
選び方: チーム規模・処理量・会計スタック別
このリストの全ツールは、銀行取引明細書PDFからデータを抽出できます。本当の違いが顕在化するのは月末、20の異なる銀行から30通の明細書が届き、水曜日までにQuickBooksへ出力を反映させなければならないときです。照合パイプラインの詳細な手順については、Google スプレッドシートで銀行照合ワークフローを構築するガイドをご覧ください。抽出から検証済み元帳までのエンドツーエンドのプロセスを解説しています。
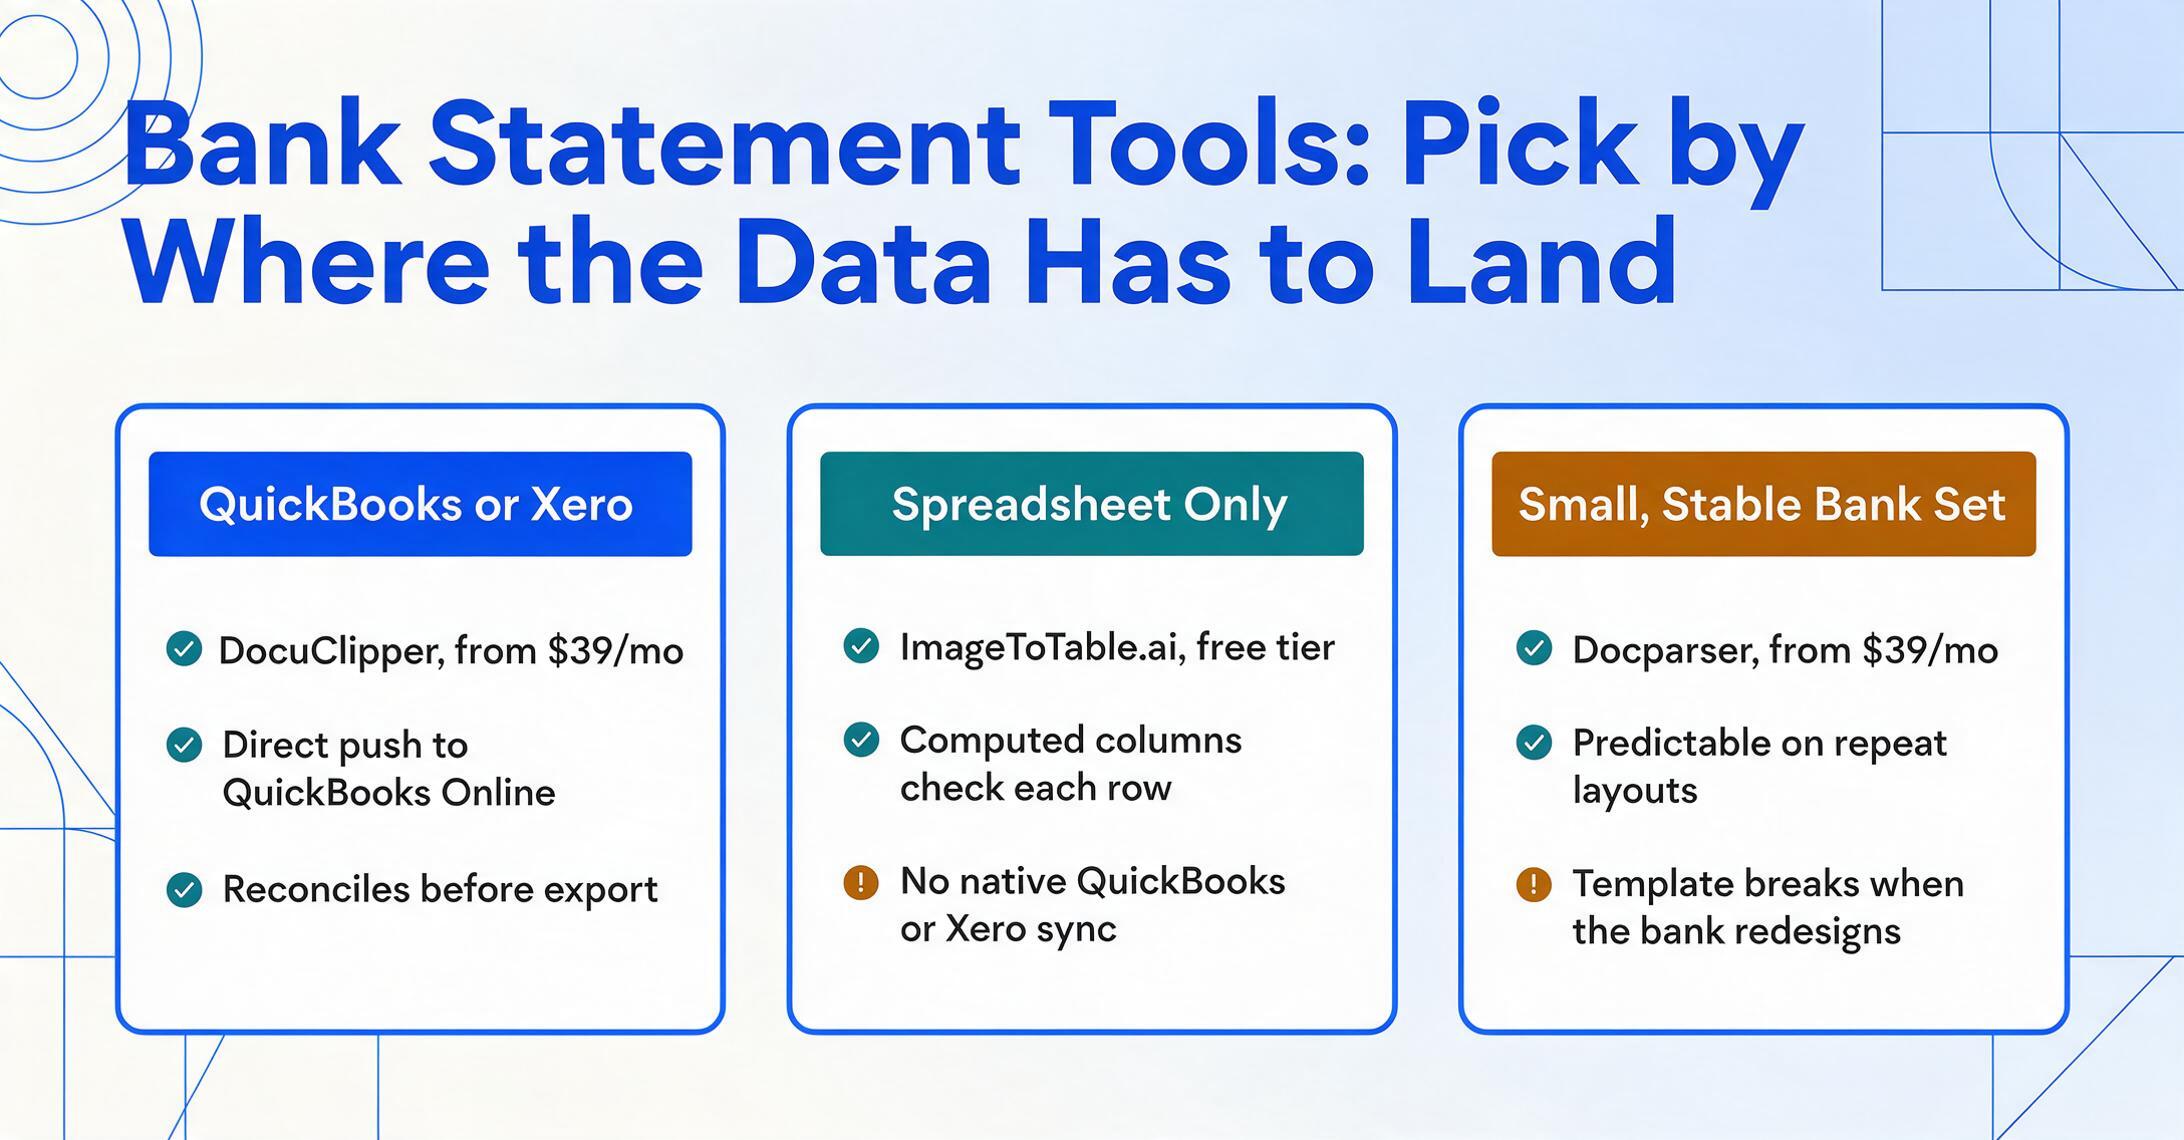
出力先がQuickBooks OnlineまたはXeroの場合: DocuClipperが最適です。直接連携、照合チェック、会計士向けに調整されたワークフローを備えています。Nanonetsはエンタープライズ規模で機能しますが、価格差は顕著です。
スプレッドシートだけで作業する場合: ImageToTable.aiがスタンドアロンのスプレッドシート中心オプションです。抽出中の自動照合チェック用の計算列と、クライアントのファイル収集用のコレクションリンク機能を備えています。
フォーマットが安定した少数の既知の銀行を扱う場合: Docparserのテンプレートエンジンは、予測可能で再現性のある結果を提供します。ただしレイアウトが変更されない限り有効です。
予測不能なフォーマットの明細書がメールで届く場合: Parseurのメール取り込みと事前学習済みAIが、セットアップ不要で最速のオプションです。AirparserのGPTベースのアプローチはフォーマットの多様性に優れていますが、複数ページの取引テーブルでは一貫性がやや劣ります。
銀行取引明細書以外にも多様なドキュメントタイプを処理する場合: AffindaとNanonetsがマルチドキュメントタイプ対応のプラットフォームです。Affindaはより導入しやすく、Nanonetsはエンタープライズ向けの選択肢です。
価格に敏感で、月100ページ未満を処理する場合: ImageToTable.aiの無料枠が最もハードルの低いオプションで、Parseurの永久無料枠(月20ページ)が唯一の真に無料で継続利用できるオプションです。
よくある質問
2026年の銀行取引明細書抽出ツールの精度はどのくらいですか?
最新のツールは、主要銀行のクリーンなデジタルPDFで99%以上のフィールドレベル精度を達成しています。スキャンや写真撮影された明細書は通常95〜98%です。実際に重要な精度の数字はベンダーのホームページに載っているものではなく、エクスポート前に自動照合(期首残高+入金額−出金額=期末残高)を実行するかどうかです。99.9%の精度を主張しながら照合しないツールは、97%を主張しても合計が一致しない明細書をすべてフラグ付けするツールよりも信頼性が低いです。
これらのツールはスキャンや画像ベースの銀行取引明細書PDFを処理できますか?
はい—ただし、同等ではありません。DocuClipper、Nanonets、Parseur、AirparserはすべてスキャンされたPDFのOCRをサポートしています。Docparserは上位プランでスキャンPDFをサポートしています。ImageToTable.aiはデジタルPDFとスキャンPDFの両方をネイティブに処理します。スキャン品質は重要です:300 DPI以上で最良の結果が得られます。かすれたインク、傾いたページ、低コントラストのスキャンは、どのツールでも精度を低下させます。
これらのツールのいずれかがQuickBooksと直接統合できますか?
DocuClipperはQuickBooks OnlineとQuickBooks Desktopに直接プッシュします。NanonetsはAPIとコネクタを介してQuickBooks、Xero、Sage、SAPに接続します。DocparserとParseurはZapierやMakeの自動化を通じてQuickBooksに到達できます—これは機能しますがミドルウェアが追加されます。Airparser、Affinda、ImageToTable.aiはExcel/CSVに出力するため、別途インポート手順が必要です。
銀行取引明細書コンバーターと銀行取引明細書抽出ツールの違いは何ですか?
コンバーターは形式変換に焦点を当てています:PDF→CSV/Excel、出力はページ上の内容のデジタルコピーです。抽出ツールはインテリジェンスを追加します:どの行が取引(ヘッダーやフッターではない)かを識別し、出金額と入金額を分離し、ページ間の累積残高の連続性を維持し、多くの場合、明細書に印刷された残高に対して合計を検証します。PDFをスプレッドシートに変換するだけでよいなら—どのスプレッドシートでも—コンバーターで十分です。手動で行ごとにクリーンアップせずに会計対応の出力が必要な場合は、抽出ツールが必要です。(基礎となる仕組みについては、銀行取引明細書抽出とは何かに関する入門記事をご覧ください。)
ChatGPTやClaudeで銀行取引明細書のデータを抽出できますか?
できます。実際、r/Bookkeepingやr/Accountingの複数のRedditスレッドで多くの人が利用していることが確認できます。汎用LLMは銀行取引明細書の1ページを読み取り、妥当な抽出結果を生成できます。ただし、限界は規模が大きくなると顕在化します。複数ページの明細書は手動での結合が必要になり、バッチ処理も照合チェックもなく、抽出のたびに別々のプロンプトセッションが必要で、ワークフローを継続できません。単発の作業(「今日中に3ページの明細書をExcelにしたい」)ならChatGPTやClaudeで十分です。しかし、複数のクライアントを抱える毎月の経理業務では、専用の抽出ツールの方がAPIベースのLLM呼び出しよりも速く、一貫性があり、1明細書あたりのコストも低くなります。データセキュリティの観点もあります。汎用LLMプロバイダーはアップロードされたコンテンツを学習に使用する可能性がありますが、文書抽出ツールは通常、顧客データを学習に使用しないという契約上の取り決めがあります。
無料の銀行取引明細書コンバーターは信頼できますか?
Tabula、BankStatementLab(月500件まで無料)、bankstatementconverter.com(1日1ページ、匿名利用可)などの無料コンバーターは、一般的な銀行のシンプルできれいなデジタルPDFには対応しています。ただし、制限は一貫しています。照合機能なし、スキャンPDF非対応(BankStatementLabを除く)、バッチ処理なし、会計ソフトで使える状態にするには手動での修正が必要です。たまに個人的に使う分には十分です。しかし、正確性と時間が重要視されるプロフェッショナルな経理業務では、有料ツールは最初の1ヶ月で修正作業の削減によってコストを回収できます。r/BookkeepingのあるRedditユーザーはこう言っています。「月39ドル払ってクリーンなデータを確認する方が、39ドル節約して列のずれを直すのに5時間費やすよりマシだ」と。