Extraction de Schedule K-1
Les cases sont la partie facile
Chaque K-1 comporte une vingtaine de cases numérotées, et après des années d'améliorations de l'OCR, intégrer ces cases dans une feuille de calcul est presque un problème résolu. Le travail qui continue de consommer la semaine d'un préparateur se trouve derrière elles. Le Schedule K-3, le montant à risque, les éléments codés de la Box 11, et une pile de lignes d'ajustement d'état contiennent les chiffres qui modifient réellement une déclaration, et ce sont précisément les valeurs qu'un outil d'extraction générique ignore par défaut.
Points clés à retenir
- Vingt cases sur chaque K-1, et intégrer ces cases dans une feuille de calcul est la partie qui fonctionne déjà.
- Les valeurs qui modifient réellement une déclaration se trouvent derrière les cases, sur le Schedule K-3, l'état à risque et les annexes d'état.
- Nommez la valeur souhaitée comme colonne et l'IA lit l'ensemble du dossier pour la trouver.
Les cases K-1 standard sont résolues. Le reste ne l'est pas.
L'extraction des cases standard fonctionne parce que chaque case est autonome. La case 1 pour le revenu d'entreprise ordinaire, la case 2 pour le revenu net de location immobilière, la case 5 pour les intérêts, la case 6a pour les dividendes ordinaires, ainsi que les pourcentages de bénéfices, de pertes et de capital figurent tous sur la face du formulaire avec une étiquette et un montant à côté. Un modèle de vision peut les lire sur un K-1 de société de personnes, un K-1 de société S, ou un K-1 de fiducie sans modèle, car l'étiquette porte le sens et la valeur se trouve à côté. C'est le travail que l'extraction des cases K-1 standard dans une feuille de calcul gère déjà bien. C'est aussi ce que la plupart des outils d'extraction de données K-1 annoncent, et sur la face du formulaire, ils le font correctement.
L'IRS a compté plus de 4,5 millions de déclarations de sociétés de personnes et 30,2 millions de partenaires pour l'année d'imposition 2023, et l'immobilier et l'activité locative représentaient à eux seuls 50,7 pour cent de ces sociétés de personnes. Le volume de K-1 en circulation n'est pas le problème. Le problème est la partie de chaque dossier qui n'arrive jamais sur la page de garde.
Cette partie a une forme. C'est la partie d'un dossier K-1 où la valeur dont vous avez besoin n'est pas étiquetée sur le formulaire, est déclarée comme un code au lieu d'un montant en dollars, est limitée par une règle qui dépend de faits que le formulaire ne contient pas, ou se trouve dans un état séparé qui réutilise les numéros de cases fédéraux pour des montants entièrement différents. Une fois que vous voyez ces éléments comme une catégorie, la raison pour laquelle l'extraction standard continue de les perdre devient évidente.
Les cinq éléments K-1 qui disparaissent silencieusement d'une feuille de calcul
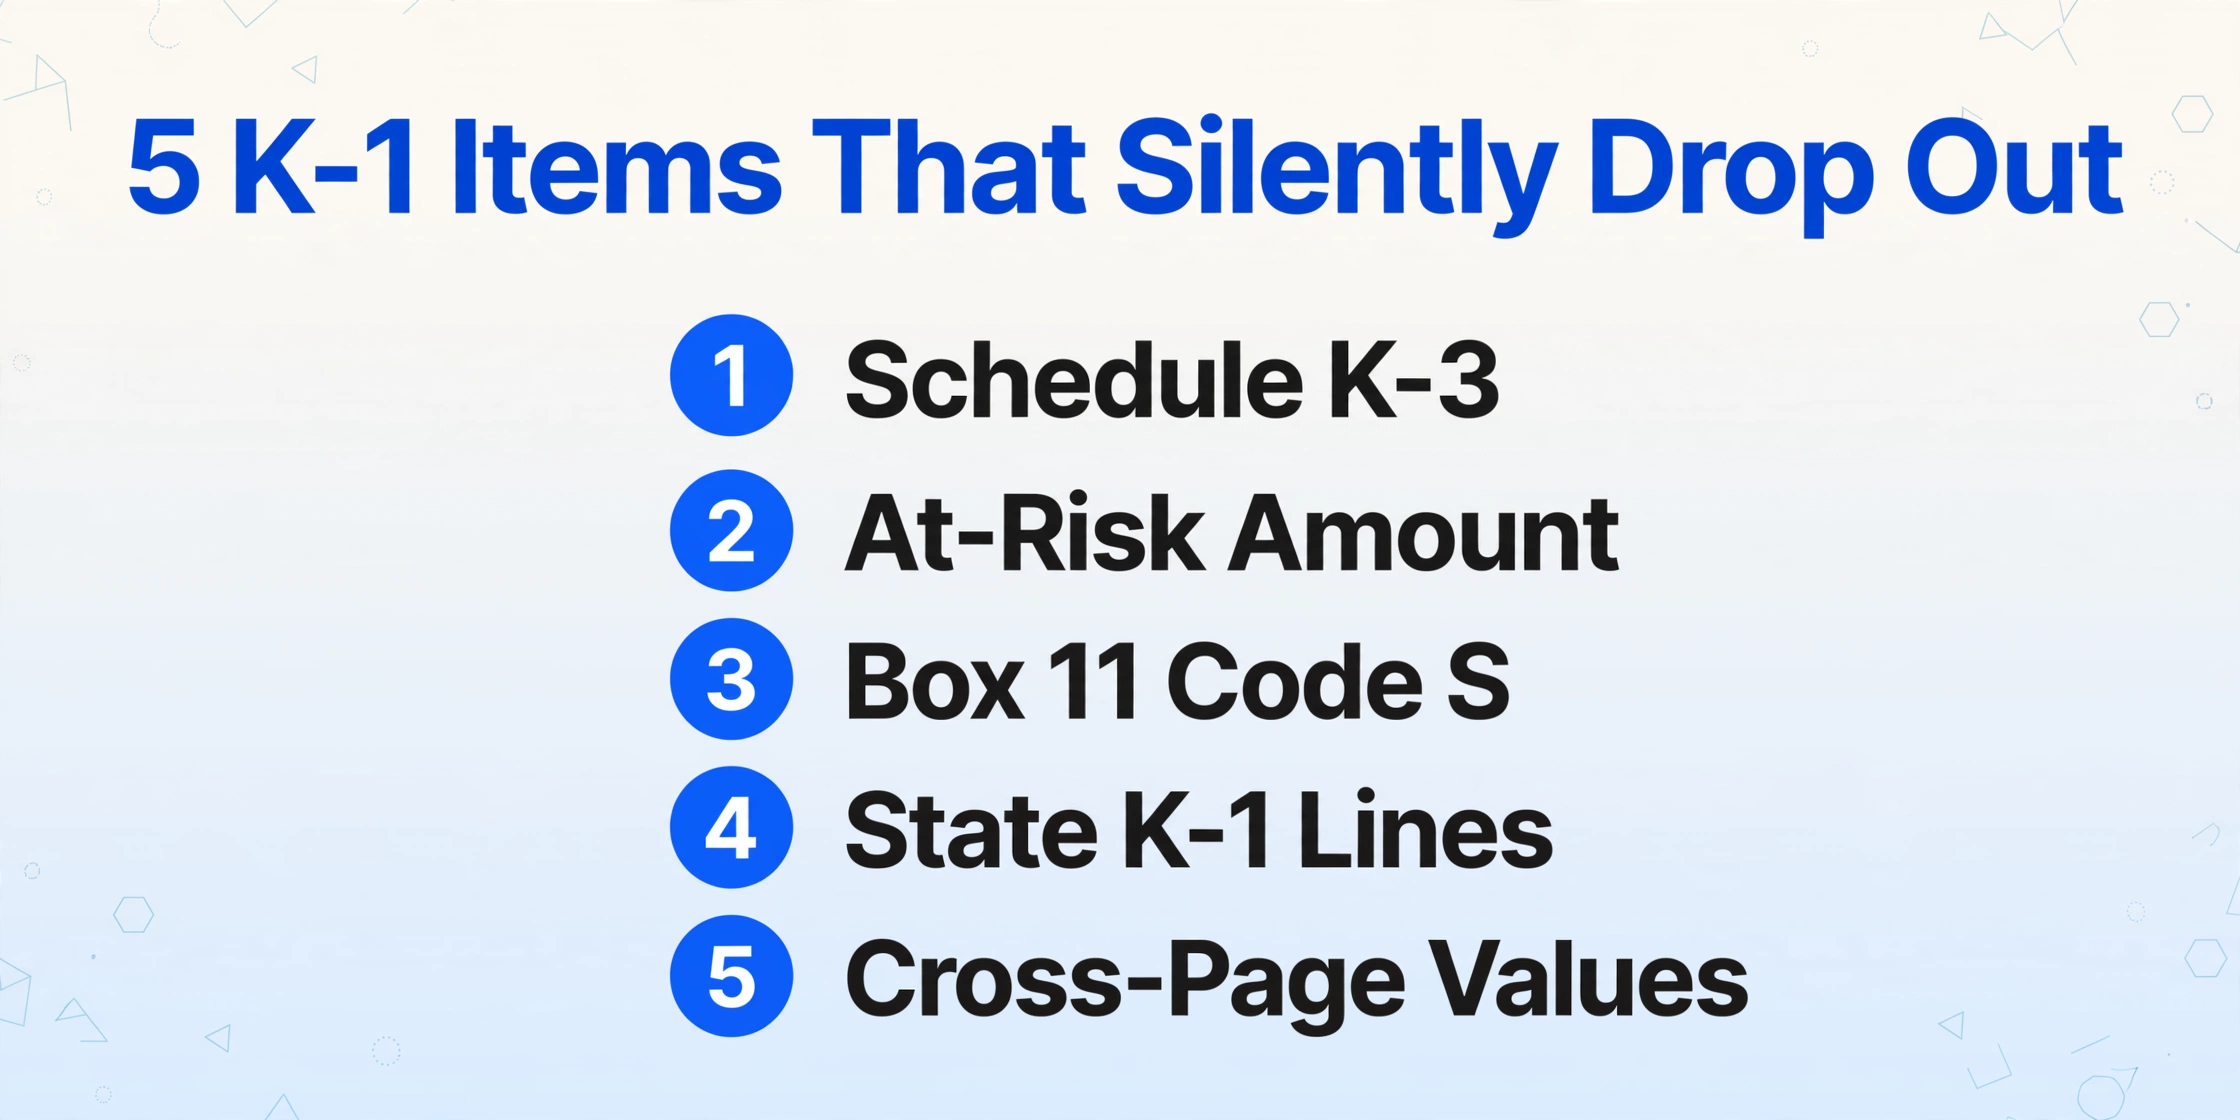
Ces cinq catégories représentent la majeure partie des retouches lors d'une saison chargée en sociétés de personnes, et aucune d'entre elles n'est capturée de manière fiable par un outil qui lit uniquement la page de garde.
1. Le Schedule K-3 et les formulaires étrangers qu'il déclenche
Le Schedule K-3 déclare les éléments internationaux d'une société de personnes, et il n'a aucun montant en dollars imprimé sur le K-1 qu'il accompagne. Il s'agit d'un annexe distincte en treize parties. La partie II contient les éléments de limitation du crédit pour impôt étranger, y compris une ligne USGI pour les intérêts sur titres du gouvernement américain. La partie VI contient les inclusions de sociétés étrangères contrôlées en vertu des articles 951(a) et 951A. La partie VII contient les données sur les sociétés étrangères passives. Les instructions de l'IRS indiquent que la partie VI alimente le Formulaire 5471, la partie VII alimente le Formulaire 8621, et la déclaration d'une société de personnes étrangère ou d'une succursale peut nécessiter le Formulaire 8865 et le Formulaire 8858. Un transfert de biens à une société étrangère peut exiger le Formulaire 926.
Pour une société de personnes nationale sans activité étrangère, une exigence de K-3 correctement constituée peut ne pas apparaître du tout. Mais l'exception de dépôt national est étroite : une demande d'un associé avant la date d'un mois, que l'IRS a fixée au 17 août 2026 pour les sociétés de personnes de l'année d'imposition 2025 déposant sur prolongation, peut faire basculer une déclaration dans une obligation de dépôt complète (Instructions pour les annexes K-2 et K-3 des sociétés de personnes). Lorsque cela se produit, le K-3 arrive en retard et chaque chiffre qui y figure doit être reporté quelque part dans la déclaration de l'associé.
2. Le montant à risque
Le montant à risque dont un associé a besoin n'est pas une case du K-1. En vertu de l' article 465, une perte n'est déductible qu'à hauteur du montant que l'associé pourrait réellement perdre, et ce montant exclut le financement sans recours et les montants protégés par une garantie ou un accord de stop-loss. La société de personnes est tenue de fournir un relevé distinct des revenus et dépenses pour chaque activité à risque, et la case 22 du K-1 est cochée lorsque plus d'une activité est en jeu. L'IRS associe cela au Formulaire 6198, Limitations des pertes à risque, qui rapproche la base et les montants à risque. Si votre feuille de calcul extraite s'arrête à la case 1, vous avez la perte mais pas le plafond qui s'y applique.
La base vient en premier, le montant à risque en deuxième, le passif en troisième, et la perte d'entreprise excédentaire en quatrième. Une perte qui dépasse la base externe peut encore être suspendue à l'étape du montant à risque, et ce montant suspendu est un report que l'année suivante doit reprendre. Lire la valeur sur un seul K-1 ne suffit pas pour la calculer.
3. Code S de la case 11 et le caractère de l'article 1231
La case 11 déclare les autres revenus et pertes par code de lettre, et la lettre détermine le traitement fiscal, pas le montant. Le code S, généralement écrit 11S dans les écrans de saisie des logiciels fiscaux, correspond aux gains ou pertes en capital hors portefeuille, soit le résultat net à court et à long terme de la cession de biens utilisés dans le cadre d'une activité commerciale ou professionnelle. Il ne relève pas de l'annexe E en tant que revenu ordinaire. Il est reporté à l'annexe D, et la règle de réexamen de l'article 1231 peut reclasser le gain net de l'article 1231 en revenu ordinaire à hauteur des pertes non récupérées des cinq années précédentes. Une extraction qui saisit le nombre dans la case 11 et ignore le code perd la seule information qui indique au préparateur où le nombre doit être reporté.
4. Lignes des K-1 d'État, y compris USGI
Un K-1 d'État réutilise les numéros de case fédéraux pour des montants différents, car les chiffres de l'État sont répartis. Plusieurs États déclarent également des lignes sans équivalent sur le K-1 fédéral. Les intérêts sur obligations du gouvernement américain, souvent abrégés en USGI, en sont l'exemple le plus clair : le gouvernement fédéral interdit aux États de taxer les intérêts sur les obligations américaines, de sorte que des États comme le Colorado, l'Oregon et le Nebraska prévoient une ligne de soustraction ou de déduction à cet effet sur leurs annexes de société de personnes. Si un lot mélange des K-1 fédéraux et d'État et que l'outil se base uniquement sur les numéros de case, les montants de l'État sont comptés deux fois dans les totaux fédéraux.
5. Valeurs nécessitant un travail sur plusieurs pages ou plusieurs années
Les composantes du revenu d'entreprise qualifié de l'article 199A, les allocations correctives de l'article 704(c), les ajustements de l'article 743(b) et les reports des années antérieures ont tous ce point commun : le nombre dont vous avez finalement besoin n'apparaît pas comme une valeur unique imprimée sur une seule page. Un préparateur le reconstitue à partir de l'état derrière le code, de la feuille de travail de l'année précédente ou d'une hypothèse fixe. Un outil d'extraction qui ne copie que ce qu'il peut voir renverra toujours une réponse partielle ici.
Pourquoi les outils d'extraction manquent ces éléments
Trois raisons structurelles expliquent cet écart, et aucune n'est liée à la qualité de numérisation. La première est que les codes et les montants sont dissociés. La Box 11 affiche une lettre ; le montant en dollars figure sur un relevé annexé, parfois à plusieurs pages de distance. Un outil qui lit le formulaire principal capture le code et ne renvoie aucune valeur.
La deuxième est le flux logiciel. Les praticiens rapportent que les données K-2 et K-3 ne se remplissent pas à partir du Schedule K complété dans les logiciels fiscaux courants, si bien que le préparateur les ressaisit manuellement dans les écrans de saisie K1. Un réviseur a décrit ainsi le premier K-3 qu'il a préparé : « J'ai complété mon premier la semaine dernière (1120S) et c'était horrible. Tout était saisi à la main. » Ce commentaire, issu du fil r/taxpros sur les K-2/K-3, est la même plainte qu'avec UltraTax CS, Lacerte, CCH Axcess et Drake : l'étape manuelle persiste parce que les données n'ont aucune source de flux.
La troisième est que certains champs sont souvent ignorés même par les produits d'extraction. Un utilisateur de longue date de l'automatisation des K-1 l'a résumé dans le fil r/taxpros sur l'automatisation : « Il exporte chaque champ de chaque K-1, sauf le QBI et l'USGI. » Les deux champs qui déterminent la déduction et la soustraction d'État étaient les deux que l'outil laissait de côté.
Comment extraire les données derrière les cases
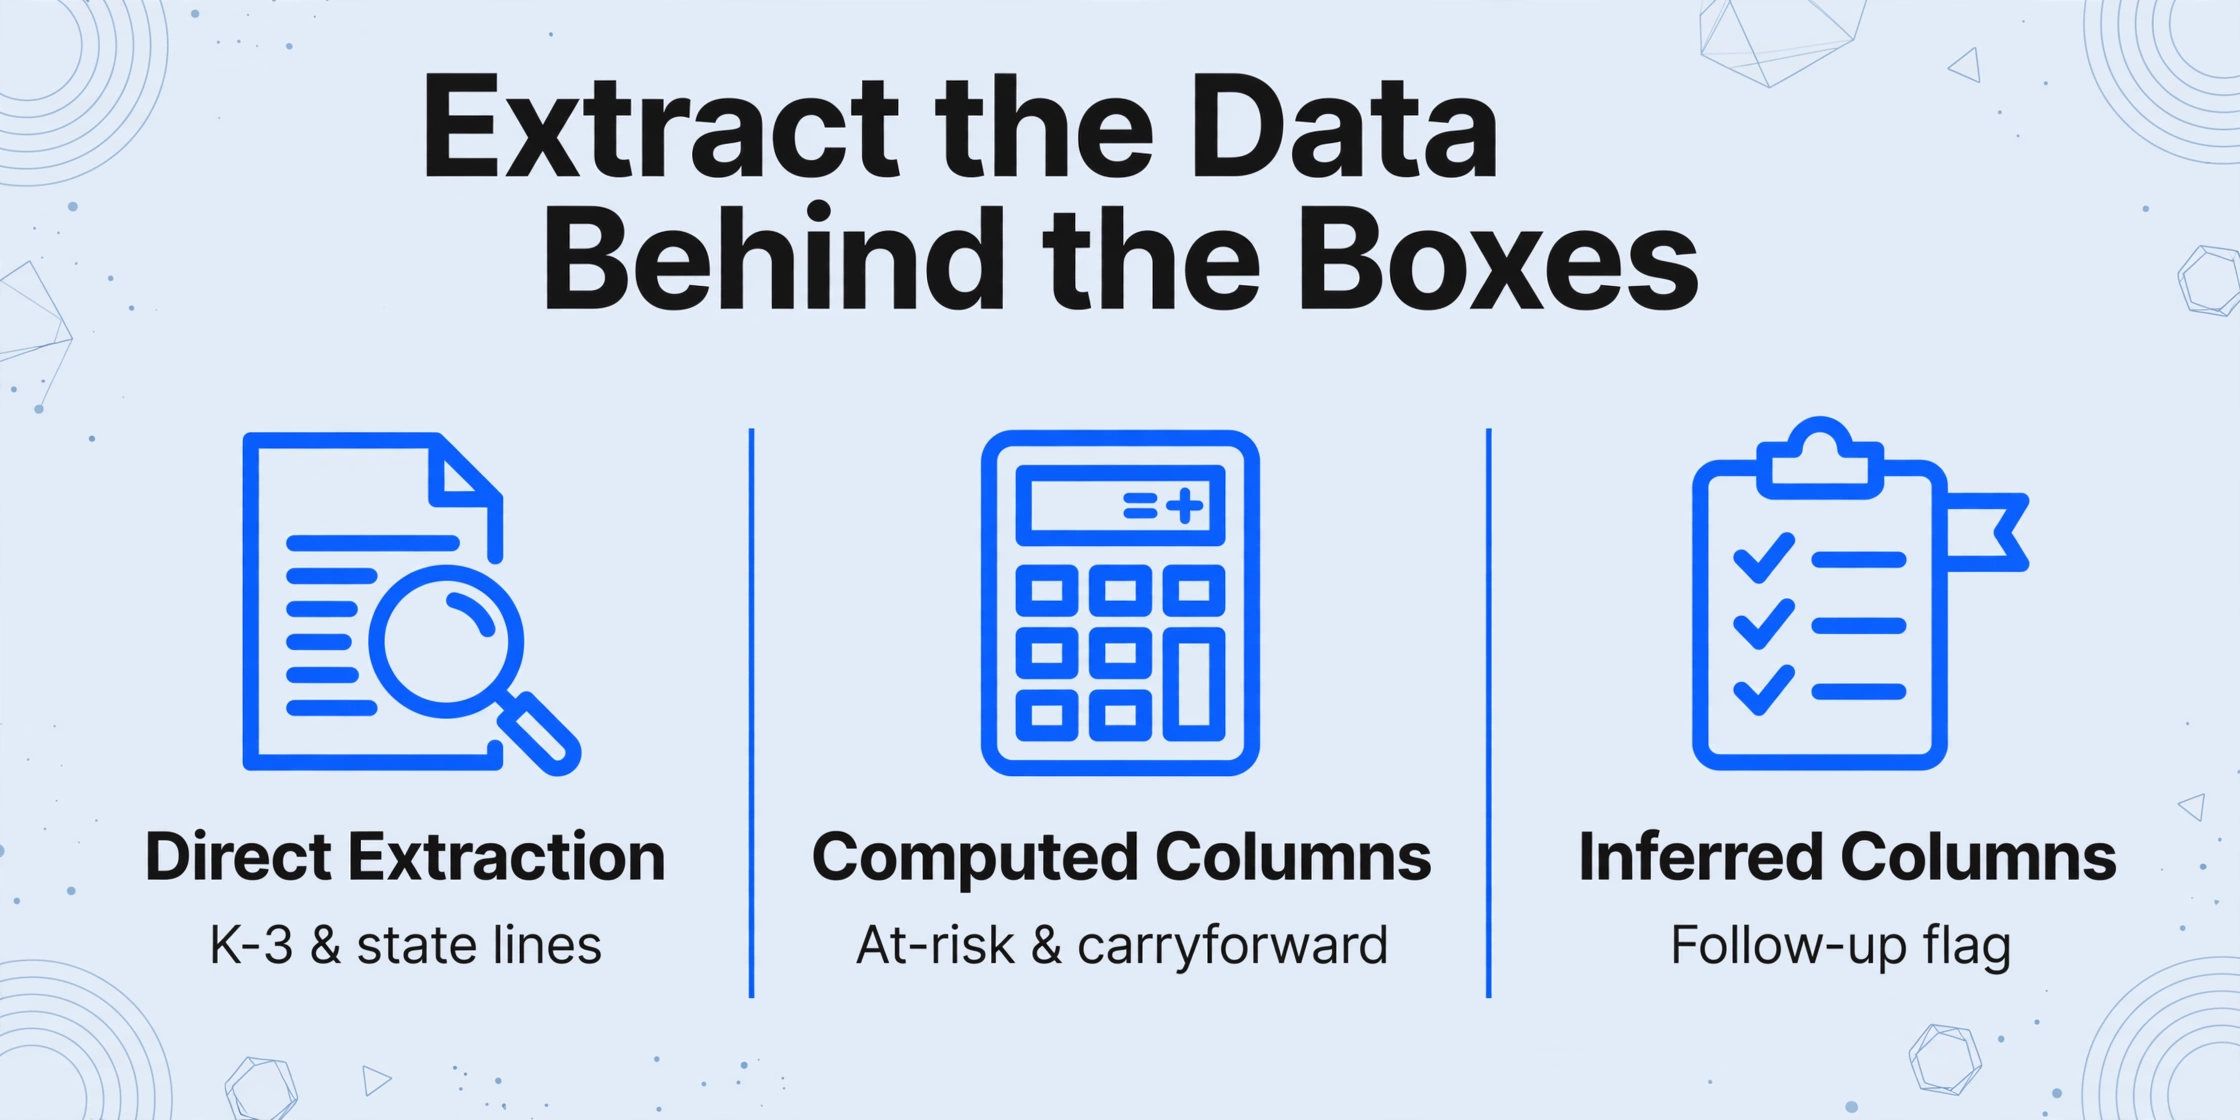
La solution est de cesser de considérer l'extraction comme « lire le formulaire » et de la considérer comme « décrire la valeur souhaitée ». C'est ce que fait l'Extraction de colonnes personnalisées : vous saisissez les noms de colonnes souhaités, et l'IA localise chaque valeur en comprenant ce qu'elle signifie, et non en correspondant à une position fixe. Vous n'êtes pas limité aux champs qui existent sous forme de cases. Un nom de colonne peut décrire une valeur dispersée sur plusieurs pages, une valeur calculée à partir d'autres valeurs, ou une valeur que l'IA doit inférer.
Les trois modes correspondent directement aux cinq catégories d'éléments manquants ci-dessus.
Extraction directe pour les lignes K-3 et les lignes d'État
Une colonne nommée K-3 Part II Line 5 USGI ou NY Allocated Income indique à l'IA de trouver cette ligne précise et de renvoyer le montant, même lorsqu'elle se trouve sur une annexe située plusieurs pages derrière le K-1. Comme le nom de la colonne porte l'instruction, un seul ensemble de noms fonctionne pour chaque type d'entité du lot. C'est ce mode qui récupère les valeurs des parties VI et VII du K-3 qui alimentent les formulaires 5471 et 8621, ainsi que les lignes de soustraction d'État que le formulaire fédéral ne montre jamais.
Colonnes calculées pour les calculs à risque et les reports
Une colonne calculée effectue l'arithmétique pendant l'extraction et renvoie le résultat sous forme de nouvelle colonne. Deductible Loss (Box 1 Loss - Prior-Year At-Risk Carryforward) renvoie le montant déductible plutôt que deux chiffres bruts que vous soustrairiez plus tard. Un paramètre fixe peut être intégré à la règle, de sorte qu'un taux d'imposition ou un report qui n'apparaît jamais sur le document entre quand même dans le calcul. C'est ainsi qu'un tableur peut contenir le plafond à risque, et pas seulement la perte.
Colonnes inférées pour l'indicateur de suivi
Une colonne inférée renvoie des informations que le document n'énonce pas explicitement. Définissez Follow-Up Needed (options: K-3 request, Form 5471, Form 8621, At-Risk Statement, None) et l'IA lit le dossier et classe ce que chaque ligne exige. Le tableau de sortie contient alors un indicateur de préparation à côté des chiffres, afin que la personne qui révise la déclaration voie quel client a besoin de quel formulaire avant le dépôt, au lieu de le découvrir à la fin de la saison.
Les fichiers sont traités en toute sécurité et ne sont pas conservés.
Le traitement par lots compte autant que le mode colonnes ici, car le problème des éléments manquants est un problème de volume. Lorsqu'un client détient des K-1 d'une douzaine d'entités, ou qu'un administrateur de fonds a des centaines de partenaires, l'extraction doit s'exécuter sur l'ensemble du lot et fusionner le tout dans un seul fichier Excel ou CSV. C'est là que le drapeau de suivi trouve tout son sens : la file de révision devient un filtre sur une colonne plutôt qu'une recherche page par page.
Ce que cet outil ne peut pas faire automatiquement
Certains détails du K-1 échappent réellement à ce qu'une passe d'extraction devrait résoudre seule, et il vaut la peine d'être direct à ce sujet. Les notes de bas de page narratives en sont le principal exemple. Lorsqu'un fonds dissimule un ajustement de l'article 743(b) ou une composante de revenu d'entreprise qualifié dans un paragraphe dense plutôt que dans un tableau, un nombre peut être lu, mais son sens peut être mal interprété. Traitez ces lignes comme des candidats à la révision, pas comme des données définitives.
Les K-1 modifiés et remplacés constituent un deuxième cas. Ils peuvent afficher à la fois une valeur d'origine et une valeur corrigée pour la même case, parfois avec un filigrane. L'extraction renvoie ce qu'elle lit, le préparateur doit donc encore confirmer que la valeur corrigée est celle qui a rempli la ligne. Les scans en basse résolution (moins de 150 dpi environ) en sont un troisième : des parenthèses peu visibles autour d'une perte peuvent être lues comme un nombre positif, et un signe moins compressé peut disparaître.
Enfin, cet outil n'importe pas directement dans CCH Axcess, UltraTax CS, Lacerte ou Drake. Il exporte en Excel, CSV ou JSON. L'intégration des données dans votre logiciel fiscal est une étape de mappage que vous ou votre cabinet contrôlez, ce qui constitue la limite honnête d'une couche d'extraction native pour tableurs.
Où vont les données extraites ensuite
Le résultat est un classeur structuré, et la façon de l'utiliser dépend de la taille de l'opération. Un préparateur indépendant place la colonne Suivi requis dans un filtre et traite les exceptions en premier. Un cabinet avec une saison K-1 plus chargée peut conserver le fichier extrait comme couche intermédiaire à partir de laquelle chaque déclaration est alimentée, ce qui correspond au schéma plus large décrit dans ce guide sur l'extraction de documents pour les comptables et dans l'argumentaire en faveur d'un logiciel d'extraction au sein des cabinets comptables.
Cette même couche intermédiaire est ce qui permet à un flux de travail saisonnier de tenir lorsque les K-1, W-2 et 1099 arrivent au cours des mêmes semaines. Si ce problème de collecte et d'acheminement de bout en bout est celui auquel vous faites face, l'approche de pipeline pour la saison fiscale est la lecture naturelle suivante.
Questions fréquemment posées
L'IA peut-elle extraire les données du Schedule K-3, ou uniquement les cases du K-1 ?
Elle peut extraire les lignes du K-3 à condition de les nommer. Au lieu de lire une mise en page fixe, l'IA suit un nom de colonne tel que « K-3 Part VI Subpart F Inclusion » ou « K-3 Part VII PFIC Section 1291 Amount » jusqu'à la bonne ligne du formulaire. La limite est que le K-3 est un document multipage distinct, il doit donc faire partie du même package téléchargé que le K-1 auquel il appartient.
Pourquoi ne puis-je pas simplement lire le montant à risque sur le K-1 ?
Parce qu'il n'y est pas imprimé. En vertu de l'article 465, le montant à risque dépend de la part de l'investissement que l'associé pourrait réellement perdre, ce qui exclut le financement sans recours et les montants garantis ou protégés contre les pertes. La société de personnes fournit un état séparé par activité, et l'associé le rapproche sur le Formulaire 6198. Vous pouvez extraire les composantes brutes et laisser une colonne calculée faire la soustraction, mais le plafond lui-même est un calcul, pas une case.
Comment gérez-vous les K-1 d'État qui réutilisent les numéros de cases fédéraux ?
Conservez les valeurs d'État et fédérales dans des colonnes séparées et ne laissez jamais un numéro de case identifier seul une valeur. Une colonne nommée « CA Allocated Interest » est sans ambiguïté ; une colonne nommée « Box 5 » ne l'est pas, car la Box 5 fédérale et une Box 5 d'État sont des montants différents par conception. Les colonnes nommées éliminent l'ambiguïté avant le début de l'extraction.
Cet outil se connecte-t-il à CCH Axcess, UltraTax CS, Lacerte ou Drake ?
Pas directement. Il produit des fichiers Excel, CSV ou JSON, et votre cabinet mappe ce fichier dans son logiciel fiscal en utilisant le chemin d'importation que vous utilisez déjà. C'est délibéré : une couche native de type tableur évite de vous verrouiller sur une seule plateforme de préparation fiscale et maintient les données extraites inspectables avant qu'elles n'atteignent la déclaration.
Puis-je extraire des K-1 en même temps que des W-2 et des 1099 dans un même lot ?
Oui. Les types de documents mixtes sont traités ensemble, et chaque ligne porte son type de document afin que vous puissiez filtrer le fichier consolidé. Cela est utile lorsqu'un seul dossier client s'appuie sur des sociétés de personnes, des revenus d'emploi et des relevés de courtage qui arrivent tous dans les mêmes quelques semaines.
Les cases n'ont jamais été la partie difficile d'un K-1. La partie difficile est la couche qui se trouve derrière elles, les parties K-3, le plafond à risque, les codes de lettres et les lignes d'État, et cette couche n'est invisible que jusqu'à ce que vous décidiez de la nommer comme colonne. Une fois qu'elle est une colonne, elle cesse d'être quelque chose qu'une déclaration oublie silencieusement.
Nommez la valeur K-1 dont vous avez besoin, y compris celles qui se trouvent derrière les cases, et laissez l'extraction la retourner comme colonne que vous pouvez examiner.
Testez-la sur un dossier K-1 de votre propre saison, idéalement un avec un K-3 et une annexe d'État jointe, et voyez si la colonne de suivi correspond à ce que votre processus d'examen aurait signalé à la main. Essayez sur vos propres K-1.