Comment traiter par lot les notes de frais d'équipe
dans Google Sheets en un après-midi
Selon une étude de 2015 de la GBTA Foundation, qui reste la référence la plus citée du secteur, une note de frais moyenne coûte 58 $ à traiter et prend 20 minutes entre la soumission et la finalisation. Traiter une note prend 20 minutes. En traiter trente ne prend pas 600 minutes ; cela prend la majeure partie d'une semaine, car les changements de format, les relances pour les reçus manquants et les suppositions de catégorisation s'accumulent à mesure que la session s'étire, et chaque note commence à prendre plus de temps que la précédente. À la clôture mensuelle, lorsque les comptes doivent être rendus sous quelques jours, vous n'avez pas une semaine à consacrer uniquement aux notes de frais.
L'écart 1 contre 30 : pourquoi un rapport prend 20 minutes et trente prennent une semaine
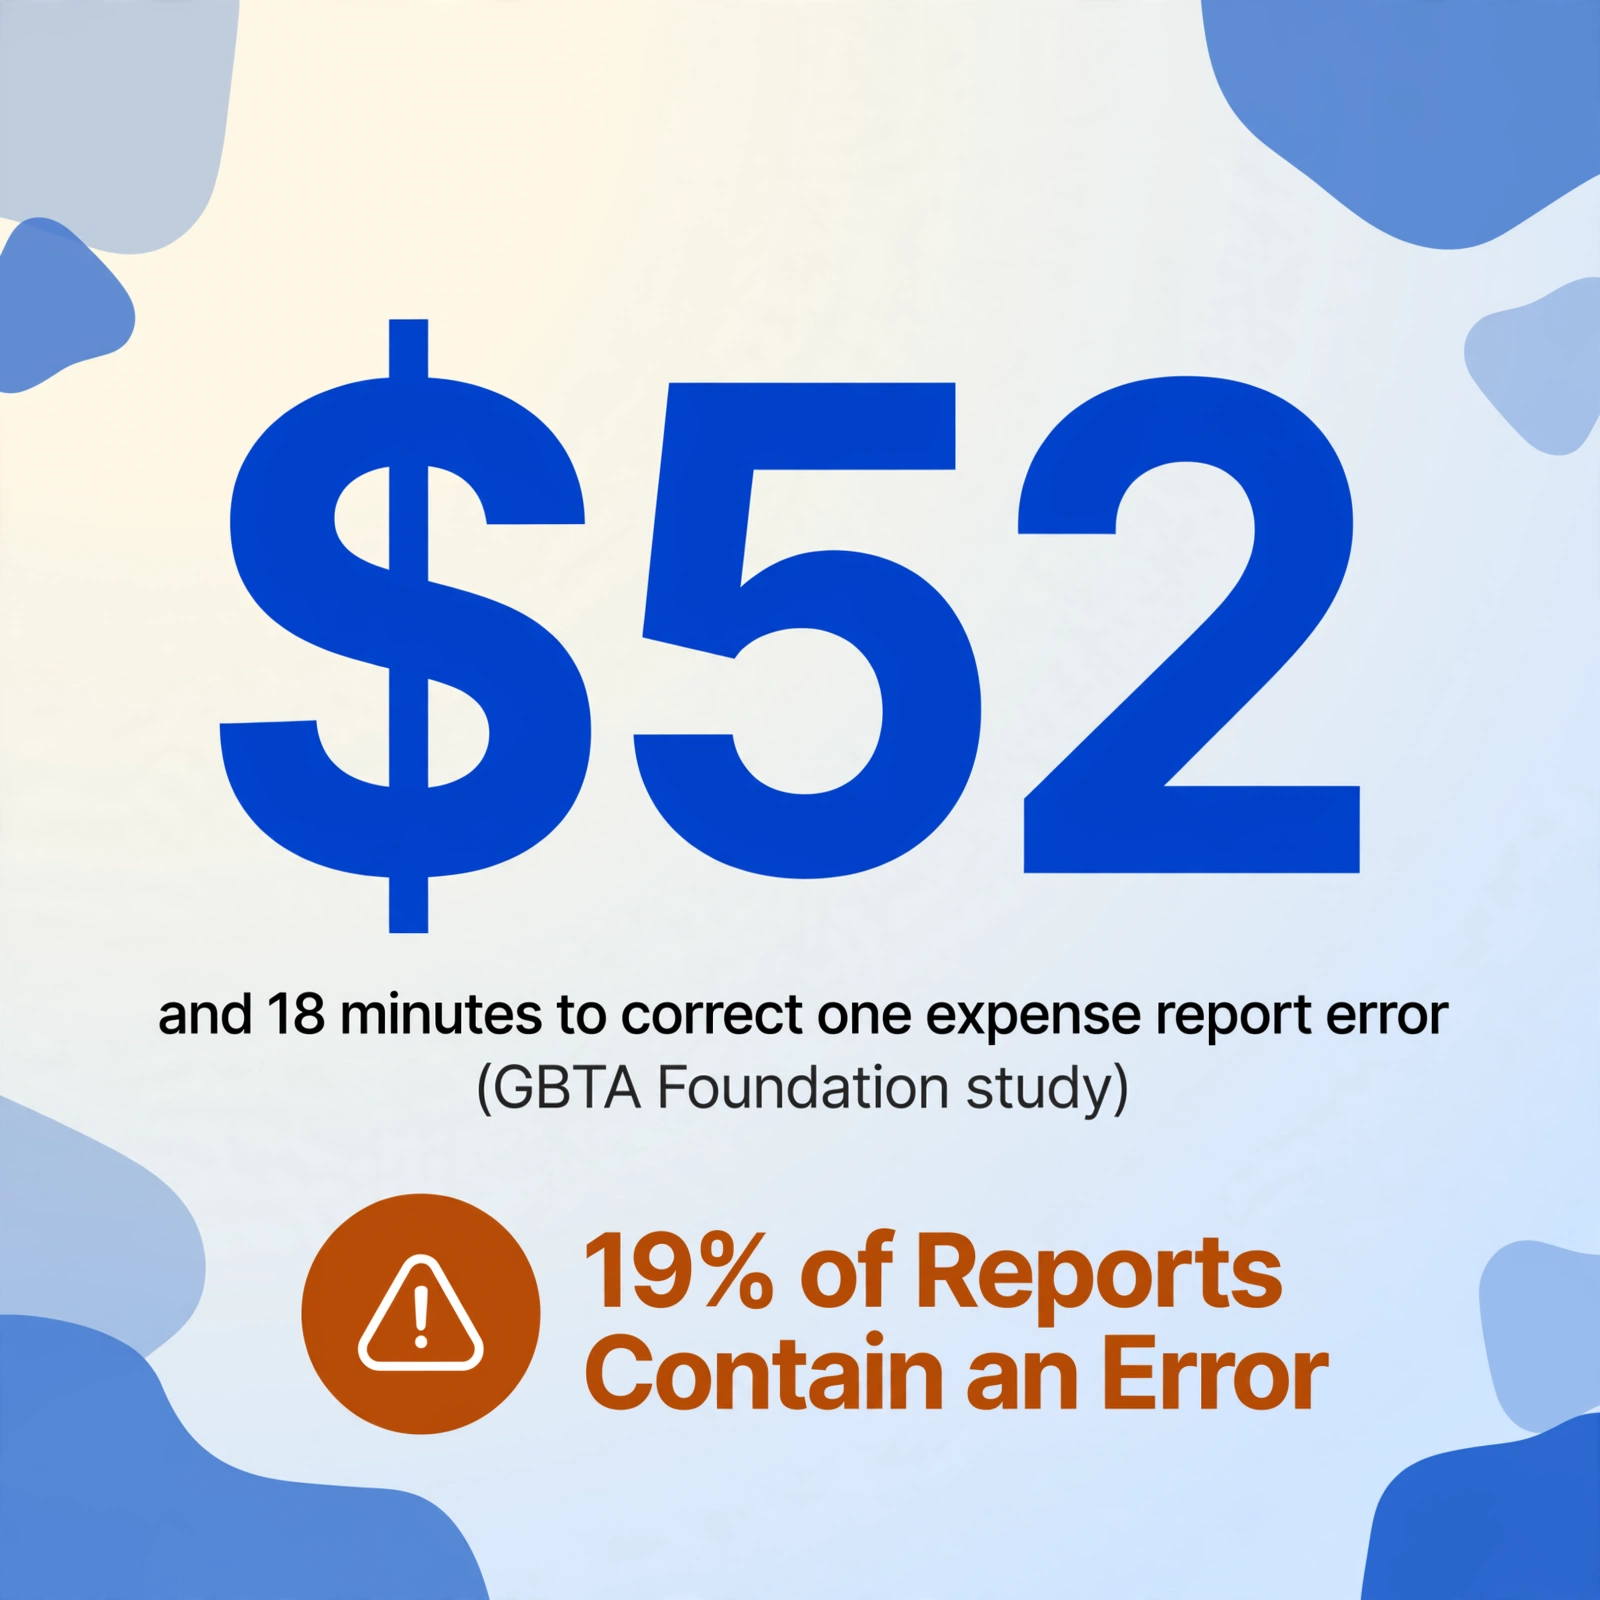
La même étude a révélé que 19 % des notes de frais contiennent des erreurs qui nécessitent 18 minutes supplémentaires et 52 $ chacune pour être corrigées (étude GBTA Foundation). Appliquez ces chiffres à une équipe de huit personnes soumettant chacune un rapport par mois : cela représente environ 5 heures de travail mensuel rien que pour le traitement des notes de frais. Pour un gestionnaire de bureau de petite entreprise responsable des livres comptables en fin de mois, les notes de frais ne sont qu'un poste sur une liste de clôture plus longue qui comprend le rapprochement bancaire, le vieillissement des comptes fournisseurs, la paie et la préparation des états financiers. Avec une clôture mensuelle médiane de 6,4 jours calendaires (APQC Open Standards Benchmarking), un détour de 5 heures pour les notes de frais grignote plus d'une matinée entière de temps de clôture.
Trois facteurs font que le traitement par lot des notes de frais évolue de manière non linéaire avec le volume, et aucun d'entre eux n'est la vitesse de frappe :
- Coût du changement de format. L'employé A soumet une photo d'un reçu de dîner d'un restaurant Toast POS. L'employé B envoie un PDF d'une facture d'hôtel avec des frais répartis sur trois nuits. L'employé C transmet une confirmation de réservation de vol sous forme de capture d'écran d'e-mail. Votre cerveau doit changer de contexte entre trois mises en page complètement différentes pour trouver les mêmes champs (date, montant, fournisseur, objet) — et ce coût de changement s'accumule à chaque rapport. Au rapport 15, vous faites des erreurs que vous ne feriez pas au rapport 3.
- Course aux informations manquantes. Environ une note de frais sur cinq contient des informations manquantes : un reçu, un objet professionnel ou un code de projet client. Avec un seul rapport, vous envoyez un e-mail à l'employé et vous obtenez la réponse en 5 minutes. Avec trente rapports et huit employés, vous gérez huit fils de relance parallèles, et l'horloge de clôture tourne.
- Dérive de catégorisation. Lorsque vous saisissez 30 rapports manuellement, votre propre catégorisation devient moins cohérente au fil de la session. Un « déjeuner d'équipe avec un client » à 9 h 15 est codé comme « Repas et divertissements ». La même dépense à 16 h 45 pourrait être codée comme « Réunion client » parce que votre attention faiblit. La feuille de calcul semble complète. Les totaux par catégorie ne sont pas fiables.
Le mur d'efficacité arrive en plein milieu d'un lot. Avant, vous êtes dans le « ce n'est pas si mal ». Après, chaque rapport supplémentaire prend plus de temps que le précédent, et le taux d'erreur grimpe. Le traitement par lot n'est pas un luxe en fin de mois ; c'est la différence entre clôturer à temps et clôturer en retard.
Ce qui casse à grande échelle : trois problèmes structurels
Les tâches individuelles du traitement des notes de frais sont simples. C'est le volume qui les rend structurellement instables. Voici les trois points de défaillance qui ne deviennent visibles que lorsque vous traitez les soumissions mensuelles de toute une équipe.
1. Formats mixtes provenant de plusieurs personnes
Un outil d'extraction de reçus individuels est optimisé pour un format à la fois — et la plupart le font bien. Le problème de fin de mois est différent : vous n'avez pas affaire à un seul format. Vous avez affaire aux habitudes de dépenses de huit employés, à différentes sources de reçus et à différents formats de rapports.
Un employé photographie des reçus papier de restaurants, de stations-service et de magasins de fournitures de bureau — chaque reçu provenant d'un système de point de vente différent avec sa propre mise en page. Un autre employé transmet toutes ses confirmations par e-mail en pièces jointes PDF — réservations d'hôtel, itinéraires de vol, renouvellements d'abonnements logiciels. Un troisième employé utilise une carte d'entreprise qui génère un relevé mensuel, et sa « note de frais » est un tableur avec des lignes et aucun reçu joint. Ces trois flux arrivent sur votre bureau comme une seule pile étiquetée « dépenses de fin de mois ».
La réponse technique à cela est le principe de conception fondamental derrière l'extraction par noms de colonnes : au lieu d'entraîner un modèle distinct pour chaque mise en page de reçu (l'approche utilisée par les outils OCR traditionnels qui exigent de dessiner des cadres autour des champs), vous définissez ce que vous voulez une seule fois — « Date », « Employé », « Fournisseur », « Montant », « Catégorie », « Objet professionnel » — et l'IA localise ces valeurs sur chaque document en comprenant ce qu'elles signifient, et non où elles se trouvent. Une date est une date, qu'elle soit dans le coin supérieur gauche d'un reçu de restaurant ou enfouie dans un e-mail de confirmation de vol. Un montant en dollars est un montant en dollars, qu'il soit précédé de « $ » ou de « Total : » ou de rien du tout. Cette indépendance du format est ce qui permet au traitement par lots de fonctionner malgré la diversité des formats des soumissions d'une vraie équipe.
2. Incohérence de catégorisation entre les notes de frais
Chaque employé catégorise ses propres dépenses différemment, et ce avant même que vous, la personne qui tient les comptes, n'ajoutiez votre propre interprétation par-dessus. Ce qu'un employé appelle « Fournitures de bureau », un autre l'appelle « Équipement ». Ce que l'un appelle « Réunion client », un autre l'appelle « Déjeuner d'équipe » — et vous avez besoin que les deux correspondent à « Repas et divertissements » dans votre compte de résultat.
Même au sein du lot d'une seule personne, la catégorisation dérive. Un repas à 12 $ avec un fournisseur à 9 h du matin est codé d'une certaine façon. Un repas à 14 $ avec un fournisseur à 4 h de l'après-midi est codé différemment, parce que la catégorisation est un processus cognitif, et non mécanique — et les processus cognitifs se dégradent au cours d'une session de saisie de plusieurs heures.
La solution consiste à séparer la logique de catégorisation de la session de saisie. Les colonnes inférées vous permettent de définir une colonne de catégorie une seule fois — par exemple, Catégorie (options : Repas/Transport/Fournitures de bureau/Logiciels/Voyages/Hébergement) — et l'IA l'applique uniformément à chaque note de frais du lot. La règle de catégorisation s'exécute de la même manière sur la note 1 que sur la note 30. Vous définissez la politique une fois ; l'outil l'applique de manière cohérente. Cela élimine entièrement la dérive de catégorisation, et cela signifie aussi que l'employé n'a pas besoin de catégoriser quoi que ce soit — le système s'en charge à partir du contenu des reçus.
3. La chronologie de la collecte : un filet sur 30 jours qui déferle en fin de mois
Les notes de frais n'arrivent pas en une pile bien rangée le premier du mois. Elles arrivent au compte-gouttes — une le 3, deux le 12, un afflux le 28 quand quelqu'un se rend compte qu'il n'a rien soumis de tout le mois. Si vous traitez chacune dès qu'elle arrive, vous changez de contexte entre la saisie des notes de frais et vos autres tâches de fin de mois. Si vous attendez qu'elles soient toutes arrivées, vous traitez 30 notes dans une fenêtre compressée — les deux derniers jours de la clôture — sans marge pour les erreurs.
Les règles de l'IRS sur le régime de remboursement de frais professionnels ajoutent une dimension de conformité à cette chronologie. En vertu de IRS Publication 463 et de la Treasury Regulation §1.62-2, les remboursements exonérés d'impôt exigent que les employés justifient leurs dépenses par des reçus et une documentation sur l'objet professionnel dans les 60 jours suivant la dépense. Quand la collecte est une relance manuelle, ce délai de 60 jours s'épuise pendant que les reçus restent dans les portefeuilles et les boîtes de réception. Et l'IRS considère que 60 jours constituent une « période raisonnable » — si vous dépassez ce délai, le remboursement peut être reclassé en salaires imposables. Le risque fiscal ne vient pas d'une erreur de calcul. Il vient d'un processus de collecte trop lent.
La restructuration consiste donc à collecter en continu et à traiter en un seul lot, au lieu de collecter en fin de mois et de traiter à ce moment-là. La suite de cet article montre comment la mettre en place.
Le processus par lots : collecter tout le mois, traiter une seule fois
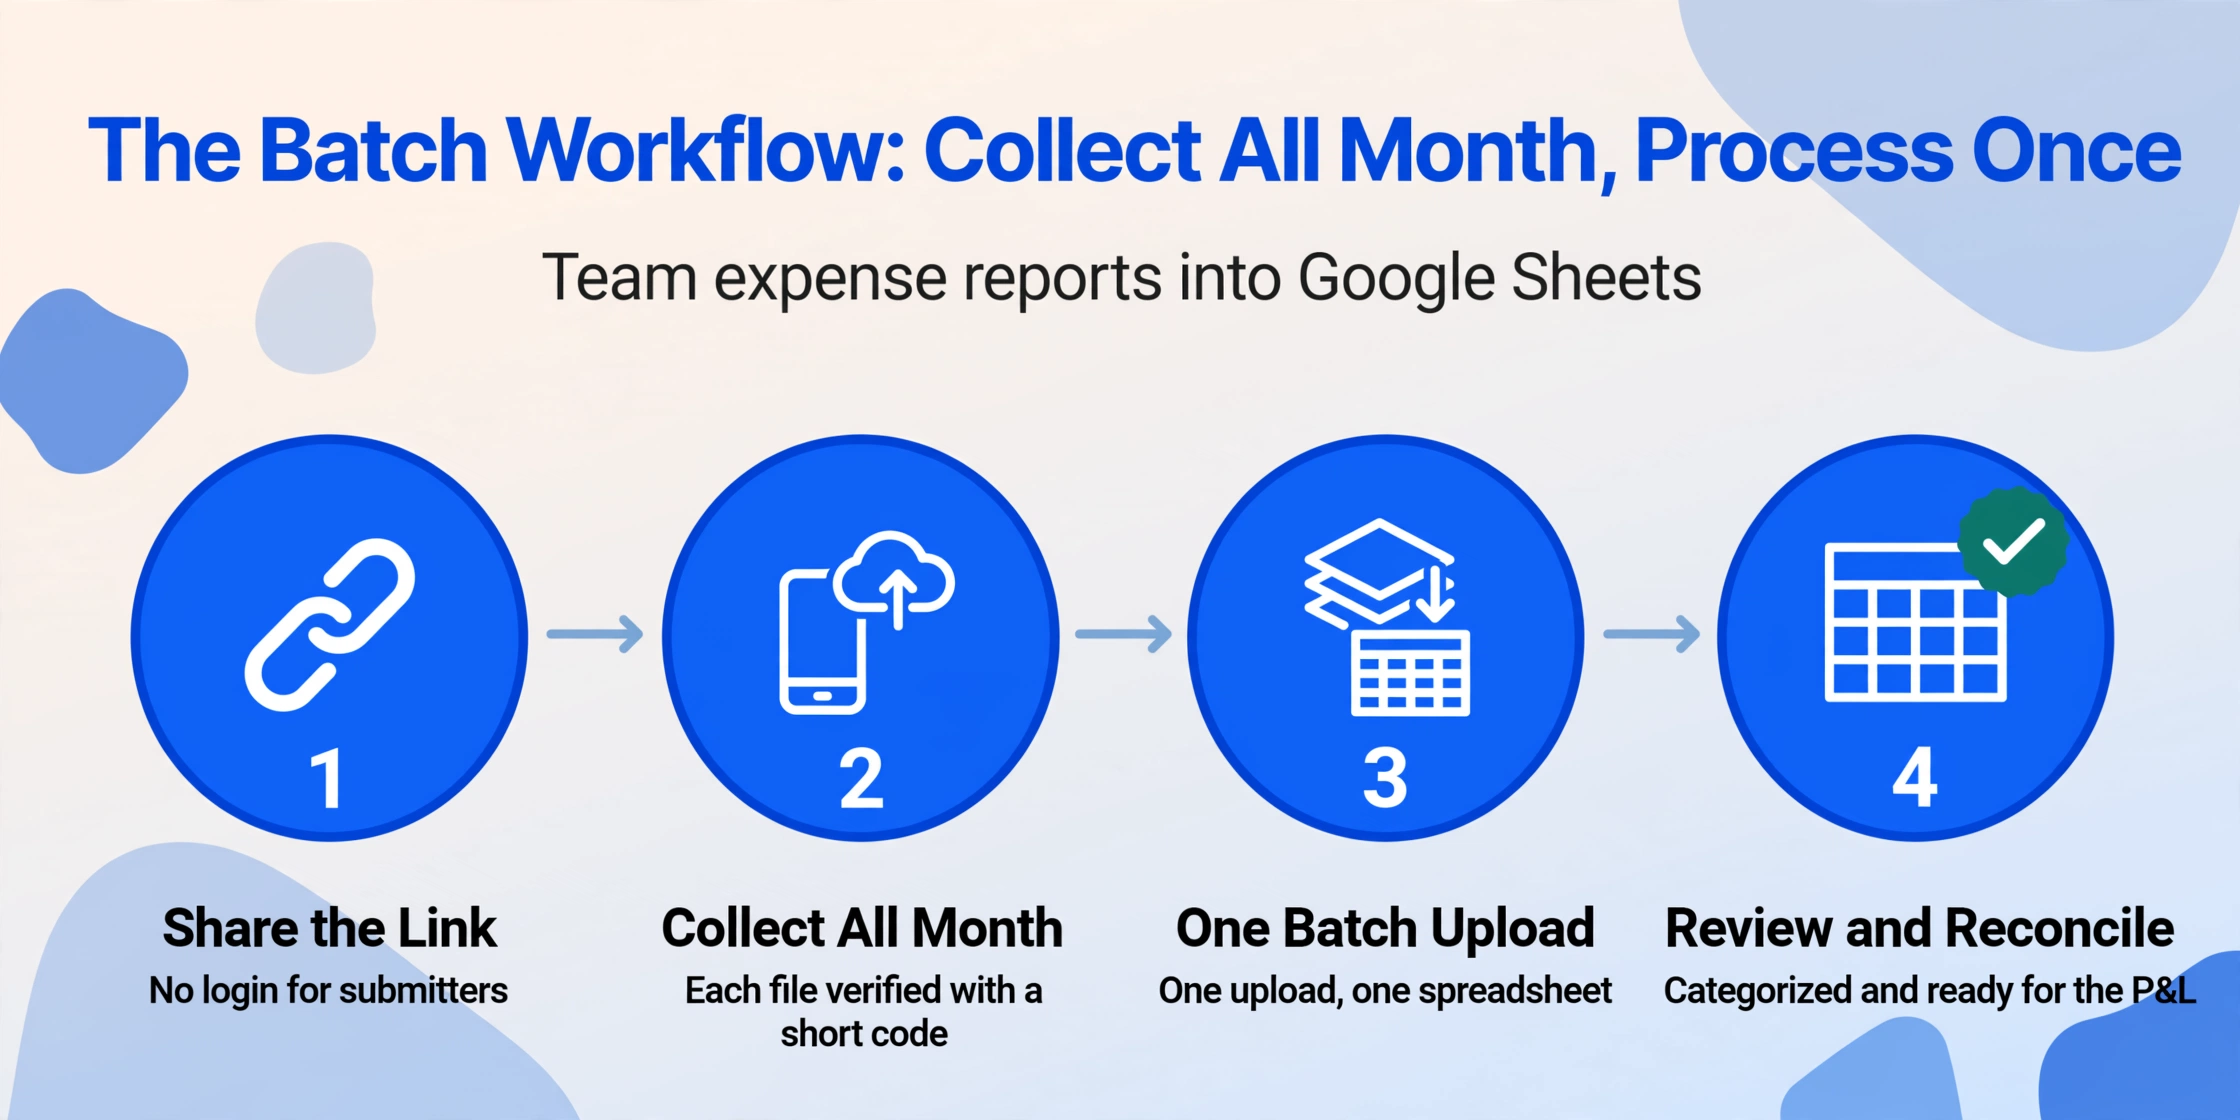
Le processus mensuel de notes de frais dans Google Sheets comporte trois phases, et la plus importante se déroule avant même la fin du mois. Voici comment le configurer dans la barre latérale.
Phase 1 : Le Lien de collecte — accumuler les soumissions tout le mois
Un Lien de collecte est une URL partageable qui permet à n'importe qui de télécharger des fichiers directement dans votre file de traitement — sans création de compte, sans connexion, sans téléchargement d'application pour l'expéditeur. Vous générez le lien une fois, vous le partagez avec votre équipe (par e-mail, dans Slack, dans le wiki d'équipe), et tout au long du mois, les employés téléversent leurs notes de frais et reçus au fur et à mesure.
Chaque soumission est vérifiée avec un code court avant le téléversement. Les fichiers arrivent dans la file de traitement de votre compte et y restent. Vous n'y touchez pas avant la fin du mois. Mais ils sont collectés — l'horloge de justification de l'IRS s'arrête, le problème du « j'ai perdu le reçu » disparaît, et votre pile de fin de mois est déjà assemblée avant la fin du mois.
C'est fondamentalement différent de demander aux employés d'envoyer des reçus par e-mail ou de les déposer dans un dossier partagé. L'e-mail disperse les soumissions dans les fils de discussion. Les dossiers partagés finissent avec des noms de fichiers incohérents, des photos en double et des fichiers déplacés ou renommés. Un Lien de collecte vous donne un point d'entrée unique avec une file propre. Pour un guide plus détaillé de ce processus, consultez notre guide de collecte des notes de frais des employés avec Lien de collecte et Sheets.
Phase 2 : La session de traitement par lots dans la barre latérale — un seul envoi, une seule feuille de calcul
La fin du mois arrive. Votre file d'attente contient 25 à 30 soumissions accumulées au cours du mois. Vous ouvrez maintenant la barre latérale du module complémentaire Google Sheets et traitez tout en une seule session. Pour un aperçu complet des capacités — types de champs pris en charge, formats et détails des plans — consultez la présentation du module complémentaire Google Sheets.
Contrairement aux lecteurs de reçus qui traitent un document à la fois et vous demandent de vérifier et confirmer chaque extraction avant de passer à la suivante, le téléversement par lots dans la barre latérale vous permet de sélectionner tous les fichiers de la file d'attente et de les traiter ensemble. Vous définissez la structure des colonnes une seule fois — Date, Employé, Fournisseur, Montant, Catégorie, Objet professionnel, Mode de paiement, Projet/Client — et l'IA applique cette structure à chaque fichier du lot. Les résultats sont fusionnés dans une seule feuille de calcul, avec une ligne par élément de dépense.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
La conception des colonnes est la décision architecturale qui détermine si votre production de fin de mois est utile ou simplement un autre type de désordre. Voici l'ensemble de colonnes recommandé pour un lot de notes de frais d'équipe :
| Colonne | Pourquoi c'est important en fin de mois | Note IRS / conformité |
|---|---|---|
| Date | Attribue la dépense à la bonne période comptable | Obligatoire pour la justification (IRS Pub 463) |
| Employé | Relie chaque dépense à la bonne personne pour le remboursement | Relie la dépense au participant au régime de remboursement de frais professionnels |
| Fournisseur | Identifie le bénéficiaire — première chose qu'un auditeur vérifie | IRS Pub 583 : les registres doivent identifier le bénéficiaire |
| Montant | La valeur du remboursement — assurez-vous qu'il s'agit du total final, pas d'un sous-total | Doit correspondre au total du reçu |
| Catégorie | Mappe les dépenses aux lignes du compte de résultat pour le reporting financier | Obligatoire pour la classification « ordinaire et nécessaire » |
| Objet professionnel | Explique pourquoi la dépense a été engagée | Régime de remboursement de frais professionnels IRS : doit indiquer le lien avec l'activité |
| Mode de paiement | Concilie avec les relevés bancaires et de carte de crédit | Appuie la preuve de paiement (reçu + relevé) |
| Projet / Client | Permet le suivi des coûts par projet et la facturation client | Varie selon le secteur ; prend en charge la comptabilité analytique par projet |
Vous n'ouvrez pas chaque fichier, ne vérifiez pas chaque champ et ne cliquez pas sur « suivant ». Vous sélectionnez tous les fichiers, cliquez sur traiter, et vous vous éloignez. L'outil parcourt la file d'attente. Une fois terminé, vous obtenez une seule feuille avec chaque dépense alignée dans les mêmes colonnes — quelle que soit la source : un relevé d'hôtel PDF, une photo de reçu de déjeuner ou une capture d'écran de confirmation de vol. Pour une présentation de la configuration du suivi partagé lui-même, consultez notre guide pour créer un suivi des dépenses d'équipe dans Google Sheets.
Concernant la précision : L'extraction de données sur reçus imprimés peut atteindre jusqu'à 99 % de précision pour des documents clairs et bien éclairés. Les pourboires manuscrits, le papier thermique fortement plié et les photos à très faible contraste réduiront ce chiffre, et ce sont les fichiers pour lesquels il faut s'attendre à des corrections. Si un lot repose sur des écritures manuscrites ou des scans médiocres, augmentez le niveau de traitement du compte avant de le soumettre. Le niveau Standard couvre la plupart des reçus imprimés ; les niveaux Advanced et Premium utilisent un modèle de vision plus puissant, adapté aux écritures manuscrites denses et aux mises en page complexes. Le niveau est fixé lors de la soumission du lot, donc un mois avec principalement des reçus numériques propres au niveau Standard et un lot désordonné au niveau Premium ne modifie pas le réglage pour tout le reste. Pour le lot lui-même, traitez tout, parcourez la sortie pour repérer les lacunes évidentes comme les cellules vides dans la colonne Montant, et corrigez les quelques lignes qui nécessitent une attention plutôt que de vérifier chaque ligne. Un lot de 30 rapports nécessite généralement quelques corrections. Les mêmes 30 rapports saisis à la main répartissent leurs erreurs sur toute la feuille et doivent être relus cellule par cellule.
Post-traitement : révision, catégorisation, rapprochement
L'extraction par lot produit une seule feuille de calcul. L'étape de post-traitement transforme cette feuille en livrable de fin de mois — catégorisée, rapprochée et prête pour le compte de résultat.
Catégorisation avec colonnes inférées : définissez les règles une fois
La catégorisation manuelle est le plus grand risque de cohérence dans le traitement des dépenses par lot. Même au sein d'une seule session de lot, votre propre jugement varie — c'est pourquoi les services comptables utilisent des codes de plan comptable standardisés plutôt que des catégories en texte libre.
Les colonnes inférées résolvent le problème de cohérence de catégorisation au niveau de l'extraction. Au lieu d'extraire les données de dépenses puis de les catégoriser ensuite, vous définissez une colonne de catégorie dans le cadre de l'extraction elle-même — par exemple :
Catégorie (options : Repas et divertissements / Voyages et hébergement / Fournitures de bureau / Logiciels et abonnements / Transport et indemnités kilométriques / Cadeaux clients / Autre)L'IA lit chaque reçu, comprend ce qui a été acheté et attribue la catégorie appropriée — et elle applique la même logique de jugement au reçu 1 qu'au reçu 30. Vous définissez le schéma de catégories une seule fois. L'outil l'applique uniformément. C'est la différence entre une feuille de calcul avec des colonnes de catégories cohérentes et une où « Déjeuner — 14,50 $ » se retrouve comme « Repas » à la ligne 3 et « Événement d'équipe » à la ligne 22.
Si vous avez besoin que les dépenses correspondent à une structure de plan comptable spécifique, vous pouvez étendre l'approche avec des colonnes calculées — par exemple, une règle qui fait correspondre « Repas et divertissements » au code comptable 6050, « Voyages et hébergement » au 6100, et ainsi de suite. La feuille de calcul de sortie arrive avec à la fois la catégorie lisible par l'humain et le code du système comptable.
L'analyse d'anomalies en 10 minutes
Avant de remettre la feuille de calcul à votre comptable ou de l'intégrer à votre compte de résultat, effectuez une passe de vérification structurée : une analyse ciblée des anomalies que le traitement par lots rend structurellement probables, et non une revue ligne par ligne.
- Triez par montant, vérifiez les extrêmes. Les valeurs les plus élevées et les plus faibles révèlent les erreurs de lot les plus courantes : un séjour à l'hôtel de 1 200 $ extrait à 12,00 $ parce que l'IA a mal lu une virgule, ou une dépense de 0,00 $ qui était en réalité une photo de reçu vierge.
- Filtrez les cellules vides dans les colonnes critiques. Un fournisseur ou un montant vide signifie que l'extraction a échoué sur ce champ. Dans un lot de 30 rapports, deux ou trois cas sont normaux. Corrigez-les manuellement ; ne relancez pas le lot.
- Recherchez les dépenses en double. Triez par date et par montant. Deux lignes avec le même fournisseur, la même date et un montant identique sont presque certainement la même dépense soumise deux fois — une fois en photo et une fois en transfert d'e-mail. Signalez-les et supprimez-les, ou notez-le pour l'employé.
- Vérifiez les affectations de catégories sur les éléments limites. Une collation de station-service codée en « Repas et divertissements » est probablement correcte. Un plein de station-service codé en « Repas » est erroné et nécessite une correction rapide. Parcourez la colonne Catégorie pour repérer les incohérences évidentes — cela prend 60 secondes.
- Vérifiez le nombre de lignes. Si vous attendiez 28 éléments de dépense et que la feuille de calcul en contient 31, trois dépenses ont peut-être été réparties sur deux lignes chacune (généralement des reçus multilignes). Si vous en avez 22, certains fichiers ont peut-être été illisibles ou vides.
Cette passe de vérification prend environ 10 minutes pour un lot de 30 rapports, contre près d'une heure pour relire les mêmes données saisies à la main. L'analyse fonctionne parce que les cinq vérifications ci-dessus ciblent les modes de défaillance que l'extraction par lots produit réellement : vous cherchez donc là où se trouvent les erreurs au lieu de lire chaque ligne.
1 contre 30 : les chiffres réels derrière le traitement manuel et par lots
L'écart d'efficacité entre le traitement d'un rapport de dépenses et de trente n'est pas théorique. Voici comment les chiffres se décomposent lorsque vous comparez la saisie manuelle dans Google Sheets à un flux de travail par lots utilisant le module complémentaire de la barre latérale :
| Indicateur | 1 rapport | 30 rapports (manuel) | 30 rapports (module par lots) |
|---|---|---|---|
| Temps de traitement | ~20 minutes | ~10 heures (avec coût de changement de contexte) | ~5 minutes d'extraction + 10 minutes de vérification |
| Changement de format | Aucun — un seul format | Se cumule : chaque nouveau format ajoute une charge cognitive | Aucun — l'IA gère la diversité des formats de manière transparente |
| Cohérence des catégories | Sans objet | Dérive au fil des sessions ; le jugement manuel varie | Uniforme — les colonnes inférées appliquent la même règle aux 30 rapports |
| Relance des reçus manquants | ~5 minutes par élément manquant | Une heure ou plus de relances auprès de 8 employés | Réduite — les reçus sont collectés en continu via le Lien de collecte |
| Taux d'erreur | 19 % des rapports manuels contiennent une erreur (GBTA) | Plus élevé, et les erreurs se propagent dans la feuille | Concentré dans les fichiers sources de mauvaise qualité, la vérification peut donc les cibler |
| Coût (à 25 $/heure de main-d'œuvre) | ~8,33 $ | ~250,00 $ | Coût d'extraction uniquement, plus une courte passe de vérification |
| Impact sur la clôture mensuelle | Minimal | Prolonge le calendrier de clôture | S'intègre dans un après-midi |
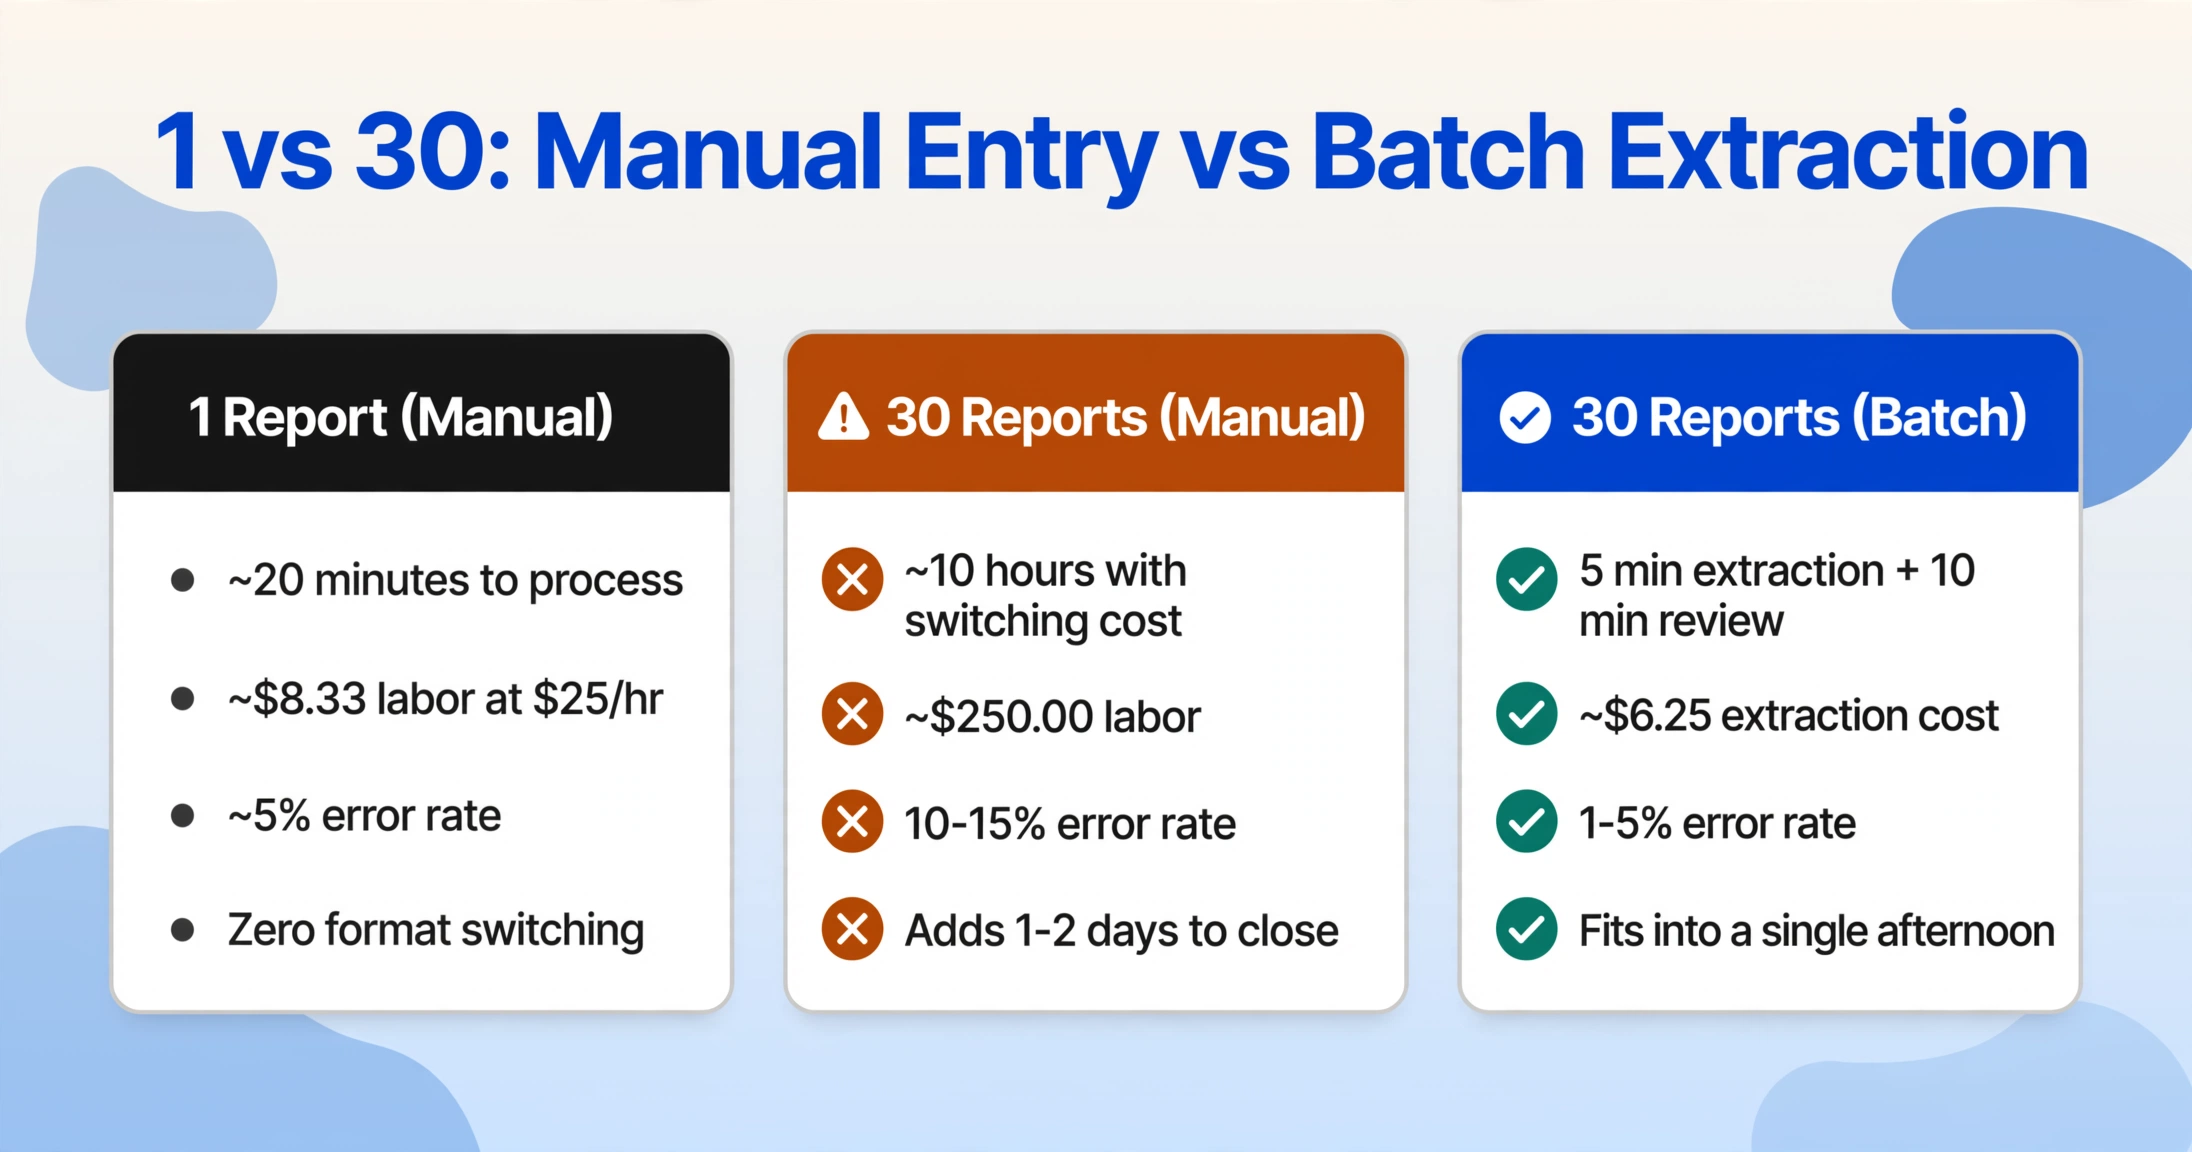
La colonne du taux d'erreur est le chiffre le plus parlant de ce tableau. La saisie manuelle de 30 rapports produit des erreurs réparties aléatoirement : un chiffre inversé à la ligne 7, une mauvaise catégorie à la ligne 19, un montant doublé à la ligne 26. Les trouver exige de relire chaque cellule. Les erreurs d'extraction par lots sont au contraire concentrées dans les fichiers sources de mauvaise qualité : papier thermique délavé, reçus fortement pliés, photos prises dans un mauvais éclairage. Vous savez où chercher, ce qui rend la vérification plus rapide et plus fiable.
Les règles de l'IRS en matière de régime de remboursement de frais professionnels imposent un délai à cette comparaison : selon l'IRS Publication 463 et la Treasury Regulation §1.62-2, les remboursements doivent être justifiés dans les 60 jours suivant la dépense. Un processus manuel de 10 heures signifie que vous pourriez ne pas remarquer un reçu manquant avant le jour 55, ne vous laissant aucun délai pour le récupérer avant la fermeture de la fenêtre. Un traitement par lots qui traite tout en un après-midi au jour 30 vous donne 30 jours de marge pour toute documentation manquante.
Questions fréquentes
Le module complémentaire Google Sheets peut-il traiter des notes de frais dans différents formats — PDF, photos, captures d'écran — dans le même lot ?
Oui. Le module complémentaire utilise l'extraction par nom de colonne, qui identifie les données par leur signification plutôt que par leur mise en page ou leur format. Une photo de reçu de dîner prise avec un téléphone, un relevé d'hôtel PDF et une capture d'écran de confirmation de vol produisent tous des lignes dans la même feuille de calcul de sortie, avec les données dans les mêmes colonnes — car l'IA comprend que « montant total » signifie la même chose, qu'il apparaisse sur un reçu Square POS ou sur un relevé Marriott.
Comment mes employés soumettent-ils leurs notes de frais avant la fin du mois ?
Via un Lien de collecte — une URL partageable que vous générez une fois et distribuez à l'équipe. Les employés ouvrent le lien, saisissent un code de vérification et téléversent directement leurs reçus ou notes de frais. Les fichiers arrivent dans votre file d'attente. Aucune installation d'application, aucune création de compte, aucune connexion requise pour le soumissionnaire. C'est le mécanisme de réception qui rend possible la collecte continue — et c'est le sujet de notre guide complet sur les flux de travail avec Lien de collecte.
Quelle est la précision de l'extraction par lot par rapport à la saisie manuelle des données ?
Pour les reçus imprimés clairs et bien éclairés, la précision de l'extraction peut atteindre jusqu'à 99 %. Les montants manuscrits, le papier thermique fortement décoloré et les photos en très basse résolution réduisent cette précision, et le niveau de traitement Advanced ou Premium est le levier pour un lot rempli de tels documents. La différence par rapport à la saisie manuelle réside moins dans le taux d'erreur absolu que dans l'endroit où les erreurs se produisent. Les erreurs de saisie manuelle sont réparties aléatoirement dans la feuille et nécessitent une relecture complète. Les erreurs d'extraction par lot se concentrent dans les fichiers sources de mauvaise qualité, de sorte que votre passe de vérification peut cibler spécifiquement ces fichiers. Un lot de 30 nécessite généralement quelques corrections, et non une revue cellule par cellule.
Le module complémentaire gère-t-il la catégorisation, ou dois-je catégoriser chaque dépense ensuite ?
Le module complémentaire gère la catégorisation pendant l'extraction grâce aux colonnes inférées. Vous définissez une colonne de catégorie avec vos options préférées — l'IA lit chaque reçu et attribue automatiquement la catégorie appropriée. La même règle de catégorisation est appliquée à chaque dépense du lot, éliminant l'incohérence qui affecte la catégorisation manuelle sur de grands volumes. Vous pouvez examiner et corriger tout élément mal catégorisé lors de l'analyse post-traitement.
Que se passe-t-il si deux employés soumettent la même dépense — le traitement par lot peut-il détecter les doublons ?
L'outil ne signale pas automatiquement les doublons pendant l'extraction, mais l'analyse post-traitement les détecte de manière fiable : triez la sortie par Date et Montant, et deux lignes avec le même fournisseur, la même date et un montant identique sont presque certainement la même dépense soumise sous deux angles. La correction prend 10 secondes — supprimez la ligne en double. C'est l'un des éléments de l'analyse d'anomalies étape par étape décrite ci-dessus.
Est-ce conforme à l'IRS pour les remboursements de frais des employés dans le cadre d'un régime de remboursement de frais professionnels ?
Oui. Selon l'IRS Publication 463 et la Revenue Ruling 2003-106, les reçus électroniques et les rapports de frais électroniques sont explicitement conformes pour la justification dans le cadre d'un régime de remboursement de frais professionnels — à condition qu'ils capturent les éléments requis : montant, date, heure, lieu et objet professionnel. La structure de colonnes recommandée dans cet article inclut les cinq champs obligatoires. La fenêtre de justification de 60 jours rend le flux de traitement par lots particulièrement pertinent : la collecte continue des reçus via un Lien de collecte signifie que les employés justifient leurs dépenses dans les jours qui suivent, et non des semaines plus tard.
Puis-je configurer la feuille une seule fois et la réutiliser chaque mois ?
Oui. Le module complémentaire Google Sheets mémorise votre configuration de colonnes, vous configurez donc une seule fois le schéma de colonnes de votre rapport de frais — Date, Employé, Fournisseur, Montant, Catégorie, Objet professionnel, Mode de paiement, Projet — et vous le réutilisez chaque mois. Le Lien de collecte persiste également d'un mois à l'autre. La configuration initiale prend environ 15 minutes. À chaque fin de mois suivante, vous ouvrez la feuille, ouvrez la barre latérale, traitez les soumissions en lot depuis la file d'attente, et exécutez la passe de vérification de 10 minutes. Le flux de travail s'accélère avec la répétition.
Collectez les notes de frais tout le mois. Traitez-les toutes en un après-midi. Restez dans Google Sheets pendant tout le processus.