Extracción de registros médicos con una
página de origen en cada dato
Una producción de registros médicos de 3.000 páginas rara vez falla porque nadie pueda leer 3.000 páginas. Falla a nivel de fila. Un informe de alta está fechado el 15 de mayo y describe una estancia hospitalaria que comenzó el 10 de mayo. La nota de ingreso, el informe de alta y la factura detallada llevan tres fechas distintas para el mismo encuentro. La persona que construyó la hoja de cálculo registró el número de página del visor de PDF, llega una producción complementaria con 40 páginas insertadas al principio, y ahora cada cita del archivo apunta al documento equivocado. La tabla todavía parece terminada. Ya no se puede usar.
Esta es una guía sobre la tabla que subyace a una cronología médica: las columnas que necesita, los puntos donde pierde precisión en silencio y los pasos que todavía corresponden a una persona. La tabla es la evidencia a partir de la cual se escribe la cronología, y tiene que sobrevivir a una impugnación página por página antes de que alguien redacte una sola frase.
Puntos clave
- Una producción de 3.000 páginas no falla porque nadie pueda leerla, sino porque una fila pierde su número de página.
- 40 páginas insertadas al principio de una producción complementaria bastan para que cada cita de página del PDF apunte al documento equivocado.
- Coloque la página de origen en su propia columna y fije los sellos de página impresos antes de la extracción, para que cada fila se remonte a una página que un tribunal pueda consultar.
Dónde se rompe una producción de historiales médicos
La procedencia es lo primero que falla en una producción que llega a miles de páginas. El expediente de un hospital no es un solo documento. Acumula entradas de médicos, enfermeras, técnicos, codificadores y una oficina de facturación, cada uno escribiendo en un momento distinto. Las condiciones federales de participación hospitalaria hacen que esa fragmentación sea estructural: las entradas deben ser legibles, completas, fechadas, con hora y autenticadas por la persona que prestó o evaluó el servicio (42 CFR 482.24(c)(1)). Un solo ingreso puede producir una historia clínica y examen físico de ingreso, notas de evolución, notas de enfermería, un informe quirúrgico, un informe de alta y una factura, cada uno con su propia lógica de fechas.
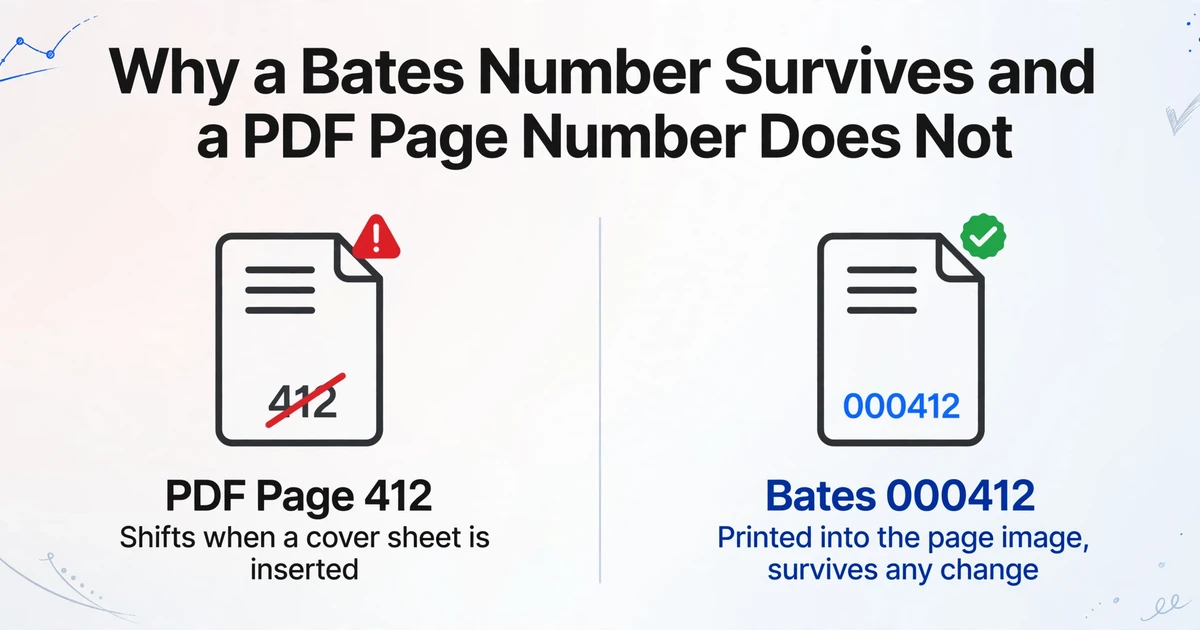
La identidad de la página se mueve. La paginación del visor de PDF pertenece al archivo actual, no a la producción. Inserte una hoja de portada o elimine un duplicado y cada número de página del visor posterior a ese punto se desplaza; divida un archivo de 4.000 páginas en un PDF por centro y la numeración se reinicia en cada archivo. Un número Bates sobrevive porque está impreso en la imagen de la página. Una cita registrada como "página 412 del PDF" no.
La fecha en la página a menudo no es la fecha de servicio. Un informe de alta fechado el 15 de mayo puede describir una estancia del 10 al 14 de mayo. La fecha impresa puede ser la fecha de dictado, la fecha de firma o la fecha de impresión. Si la columna se llama "Fecha" y el modelo toma la fecha más prominente de la página, el ingreso desaparece de la cronología y el alta cae en el día equivocado.
Un encuentro se convierte en tres filas, o en ninguna. El mismo ingreso se documenta en la nota de ingreso, se resume en el informe de alta y se factura en una factura detallada. Las solicitudes de historiales superpuestas también producen páginas duplicadas. Un revisor que trabajaba con un informe de 800 páginas en r/paralegal lo dijo sin rodeos: "so many duplicates. It's completely confusing" (r/paralegal). A las mil páginas, el revisor deja de conciliar porque la siguiente página siempre está esperando.
El trabajo también se reparte entre distintos roles, y en los traspasos es donde se pierde la página. La oficina de gestión de información de salud del proveedor produce y certifica el historial, y puede paginarlo o no. Un asistente jurídico de litigios lo inventaría, lo sella si la otra parte no lo hizo y construye la tabla de primera pasada. Una consultora de enfermería legal lo lee en busca de significado clínico, vacíos y contradicciones. Un asociado o el abogado usa el resultado en una demanda o en un esquema de deposición, y asume la responsabilidad profesional por lo que dice. Las facturas detalladas a menudo llegan de una oficina de facturación aparte, con sus propias fechas y números de página.
Las herramientas de resumen hacen que la pérdida sea más difícil de ver. Como señaló un debate en r/legaltech, "tienden a perder el contexto longitudinal, las visitas repetidas y las contradicciones que solo aparecen cuando se amplía la perspectiva" (r/legaltech). Una fila estructurada por cada evento documentado, cada una vinculada a su página de origen, le permite ampliar la perspectiva después sin perder la página subyacente.
Un resumen puede estar equivocado de una manera que un lector nota. Una tabla puede estar equivocada de una manera que parece organizada.
Qué necesita la tabla antes de que alguien escriba una cronología
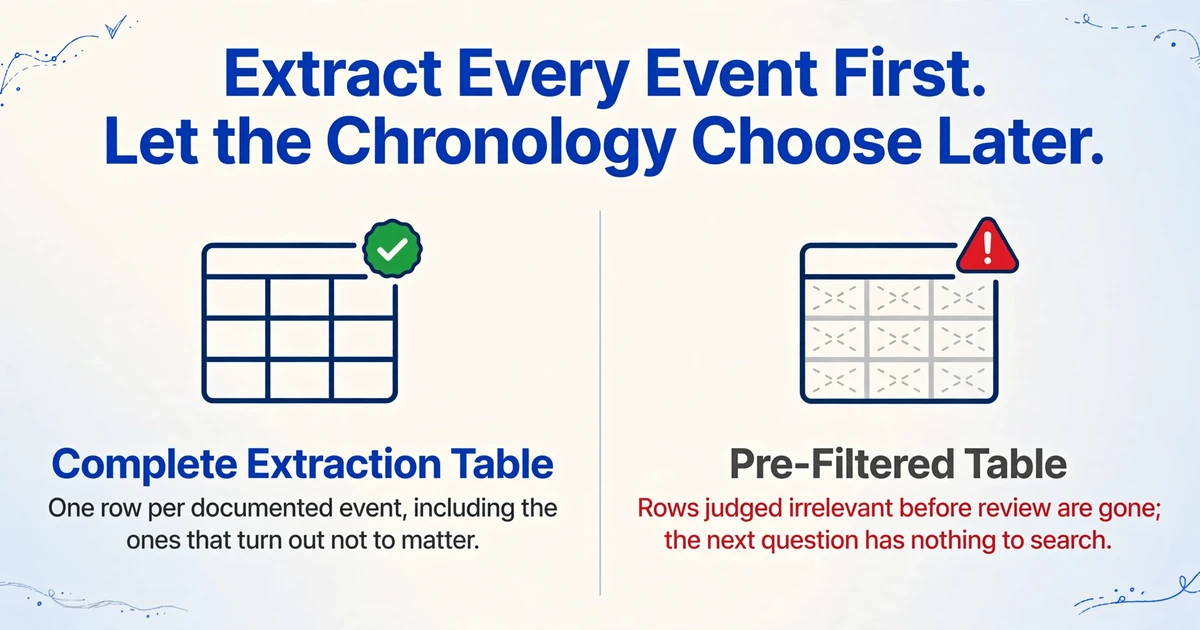
Una cronología médica es una narración fechada de los eventos que importan al caso, con una cita para cada entrada. La tabla que la sustenta es un objeto distinto: una fila por cada evento documentado, incluidos los eventos que resultan no importar, cada uno con suficiente procedencia para ser verificado. Mantener ambas separadas evita que el paso de extracción decida silenciosamente qué evidencia existe.
La selección pertenece a la cronología. Una tabla que contiene solo los eventos que alguien ya juzgó relevantes borra el registro de lo que se omitió, y una pregunta posterior sobre un síntoma o un seguimiento no realizado no tiene nada que buscar. La tabla debe ser completa y mecánica. La cronología debe ser selectiva y argumentada.
| Columna | Qué va en ella | Por qué existe |
|---|---|---|
| Fecha de servicio | La fecha en que ocurrió la atención, como AAAA-MM-DD | La clave de ordenación de la tabla, y el valor que más se confunde con la fecha del documento |
| Proveedor | El clínico o departamento que redactó la entrada | Muestra quién sabía qué, y cuándo |
| Centro | El hospital, la clínica, el centro de imagen o el laboratorio que lo produjo | Evita que registros parecidos se lean como un solo episodio de atención |
| Tipo de documento | Nota de ingreso, informe de alta, informe quirúrgico, informe de imagen, factura detallada | Muestra cuánto peso tiene la entrada y si resume otras entradas |
| Evento o hallazgo | Un hecho, en lenguaje neutro, sin adjetivos | La sustancia que después se convierte en una línea de la cronología o no |
| Página de origen | El número Bates o el número de página impreso donde aparece el hecho | La cita. Sin ella, la fila es una afirmación |
| Texto citado | Las palabras exactas de la página, breves, incluidas abreviaturas y errores | Detecta la deriva por paráfrasis y permite que un segundo revisor verifique en segundos |
| Marca | GAP, CONFLICT, LATE ENTRY, DUPLICATE, o en blanco | Señala lo que la tabla no puede resolver y una persona debe hacerlo |
La regla de la fecha es lo que hace utilizable la tabla. Extraiga la fecha en que ocurrió la atención, no la fecha impresa en la parte superior de la página. Un informe de alta que abarca cinco días debe producir entradas en los días en que ocurrieron los eventos, o una fila cuyo texto del evento indique el rango y cuya fecha de servicio sea la fecha de ingreso. Lo que no debe hacer es poner toda la estancia en la fecha del dictado.
La columna de texto citado es la segunda salvaguarda. "Patient improved" y "patient ambulated with assistance" son hechos clínicos diferentes. Un texto citado breve y exacto ancla la fila a lo que dice el registro, en lugar de a lo que recuerda el revisor.
| Fecha de servicio | Proveedor | Tipo de documento | Evento o hallazgo | Página de origen | Marca |
|---|---|---|---|---|---|
| 2026-05-10 | Médico de urgencias | Nota de ingreso | Ingresado tras colisión, dolor cervical calificado 7/10 | HOSP-A-000412 | |
| 2026-05-10 | Médico tratante | Informe de alta | Resume la estancia hospitalaria del 10 al 14 de mayo | HOSP-A-001208 | CONFLICT: la fecha impresa 2026-05-15 es la fecha del dictado |
| 2026-05-10 | Oficina de facturación | Estado de cuenta detallado | Cargos del centro por la estancia hospitalaria | BILL-000033 | DUPLICATE: misma estancia que las filas clínicas; el rango de fechas difiere |
| 2026-06-02 | Ortopedista | Nota de consulta | Se ordenó resonancia magnética lumbar | CLINIC-B-000087 | GAP: no hay informe en la producción |
Estructura de fila ilustrativa. Los nombres de los centros son marcadores de posición, no un caso real.
Esa última fila separa "ordenado" de "realizado". Una orden es un plan; un informe es un resultado. Fusionar ambos crea un historial de tratamiento que nunca ocurrió. La misma regla se aplica a las derivaciones, las recetas escritas frente a las surtidas, y los procedimientos programados frente a los completados.
Corrija la identidad de página antes de que comience la extracción
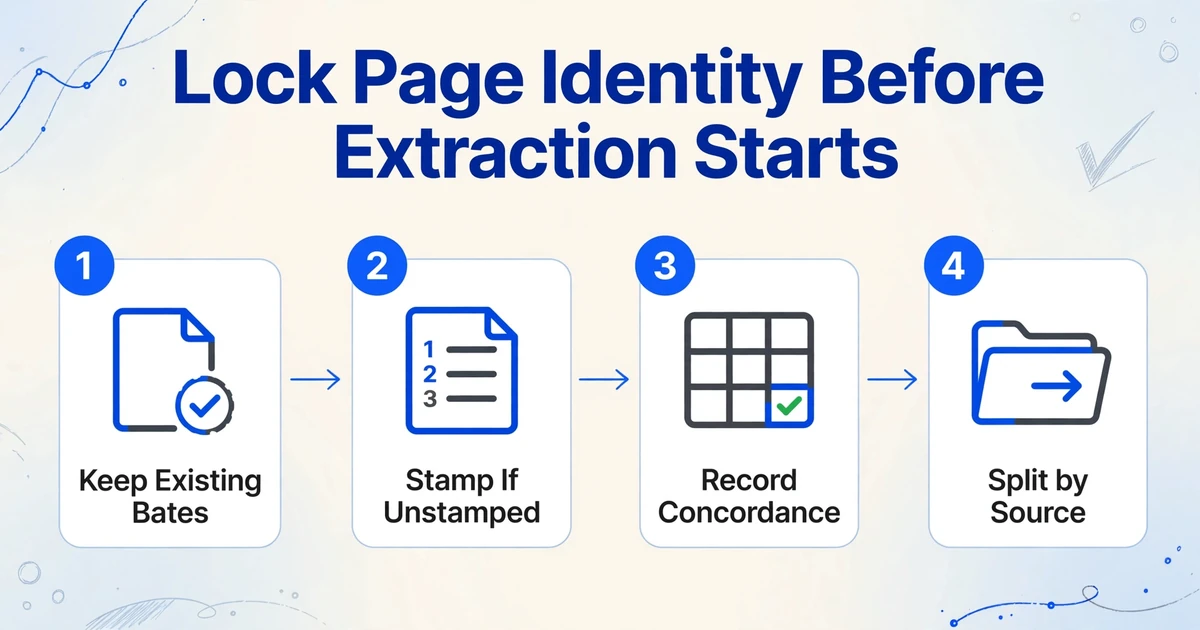
Los números Bates, los identificadores de página estampados en una producción, son la única identidad de página que sobrevive a una producción complementaria. Si la parte productora ya estampó las páginas, conserve sus números y no vuelva a estampar, porque cada escrito del caso citará los suyos. Si las páginas no están estampadas, estampelas antes de la extracción con un prefijo corto por origen y una secuencia con ceros a la izquierda, y aplique el número a la imagen misma.
Una tabla de concordancia es la segunda mitad de la solución. Mantenga una fila por archivo producido: origen, Bates inicial, Bates final, fecha de recepción, número de páginas y una nota sobre lo que falta. La tabla de eventos apunta a los números Bates; la tabla de concordancia indica qué archivo los contiene. Cuando llegue una producción complementaria, agregue filas a la tabla de concordancia y las citas anteriores seguirán funcionando.
Divida la producción por origen antes de cargarla. Un solo PDF de 3,000 páginas le da un único dominio de falla: un escaneo rotado o una sección duplicada son difíciles de aislar, y cada fila posterior hereda el problema. Un archivo por centro o por rango Bates mantiene el lote revisable y evita que una regla de fusión arrastre dos centros al mismo grupo. Los detalles de cómo dividir un PDF muy grande, y qué hacer con OCR localmente frente a enviarlo a un servicio, se tratan en OCR en un PDF de 7,000 páginas.
El número de página es la parte de una fila que cuesta más reconstruir después.
Defina las columnas una vez y ejecute toda la producción a través de ellas
Una columna definida una vez se aplica a cada página del lote, lo que convierte 3.000 páginas en una sola tabla en lugar de 3.000 búsquedas separadas. Este es el mecanismo detrás de Extracción de Columnas Personalizadas: usted escribe los encabezados que desea, como fecha de servicio, proveedor, centro, tipo de documento, evento o hallazgo, página de origen y texto citado, y la IA localiza los valores coincidentes por su significado. Un informe de alta de un hospital y una nota de consulta de una clínica pueden tener estructuras completamente distintas y aun así quedar en las mismas columnas.
El procesamiento por lotes es la segunda mitad. Usted carga el conjunto y la salida es un solo libro con una fila por cada página o archivo cargado, usando los nombres de sus columnas como encabezados. Un asistente jurídico puede entonces ordenar por fecha de servicio en todos los centros a la vez, que es lo primero que necesita una cronología y lo último que puede darle una carpeta de PDF.
La fusión de varias páginas es lo que más cuidado requiere aquí. Une las páginas que pertenecen a un mismo documento lógico en una sola fila, usando una regla de agrupación: iniciar un nuevo grupo cuando cambia una columna supervisada, coincidir por un número de referencia compartido o agrupar cada número fijo de páginas. Para una producción en la que cada página es un documento separado, déjela desactivada. Para un informe de alta, un informe quirúrgico o un informe de imagen de varias páginas, actívela con una regla de agrupación vinculada al identificador del documento. Agrupar por fecha fusionará dos visitas no relacionadas que ocurrieron el mismo día.
Cuando un grupo contiene valores en conflicto, la regla decide si conservar el primero, conservar el último, concatenarlos o dividir las filas. En una producción médica, dividir suele ser la opción honesta, porque el conflicto en sí es evidencia y debe llegar a un revisor como dos filas en lugar de un solo valor suavizado.
Los archivos se procesan de forma segura y no se almacenan.
Revise las filas que sostienen el caso, no las 3.000
El muestreo funciona cuando la muestra se elige por consecuencia y no por número de páginas. Leer el 10 por ciento al azar le indica la calidad promedio de la extracción. No le indica si la fecha de la cirugía, el primer tratamiento tras la colisión o el medicamento suspendido son correctos, y esas son las filas que un experto de la parte contraria sacará.
El Modo de revisión con verificación de cuadro delimitador está diseñado para esta comprobación. Pase el cursor o haga clic en cualquier celda extraída y la imagen original resalta la región de la que provino el valor. Lo inverso también funciona: haga clic en una región localizada de la página y se selecciona la celda correspondiente de la tabla. Si un revisor edita un campo, un clic muestra el valor original de la IA y lo restaura. La anotación puede ejecutarse a demanda para una sola página o automáticamente después del procesamiento.
Úselo en las filas que tienen peso: la primera nota de cada proveedor y centro, todo estudio de imagen y procedimiento, toda fecha que ancle la causalidad o un plazo de prescripción, toda fila marcada CONFLICT o DUPLICATE, y la primera y la última página de cada rango Bates. Esta última detecta errores de rango que una comprobación en medio de un documento pasará por alto.
Aquí es donde recae la obligación profesional. La Opinión Formal 512 de la ABA aplica los deberes de competencia, confidencialidad y supervisión a la IA generativa, y espera que un abogado entienda la herramienta, proteja lo que se introduce en ella y verifique lo que sale (ABA Formal Opinion 512). Una comprobación documentada a nivel de página es la forma en que un despacho demuestra que la verificación se realizó. Los modos de fallo que debe buscar se tratan en por qué la IA alucina en la extracción de documentos legales y en esta rutina de verificación puntual posterior a la extracción.
La tabla también debe seguir siendo producible. Cuando se usa un resumen, un gráfico o un cálculo para probar el contenido de registros voluminosos, la parte que lo ofrece debe poner a disposición los originales o duplicados subyacentes para su examen o copia (Federal Rule of Evidence 1006). Una tabla cuya columna de página de origen no pueda seguirse hasta una página de la producción incumple ese requisito antes de que alguien discuta sobre la medicina.
Una cita que no puede seguirse hasta la página es una nota, no una prueba.
Lo que esta tabla no hace
La tabla es la base de una cronología, y el límite entre ambas es donde reside la mayor parte del trabajo restante. Varias tareas quedan en manos del equipo legal.
No redacta la cronología ni decide qué es relevante. Elegir qué filas se convierten en entradas de la cronología y redactarlas en un lenguaje neutral que un experto pueda adoptar es un juicio legal y clínico.
No deduplica el mismo encuentro entre documentos. La nota de ingreso y el informe de alta producirán ambas filas. La herramienta puede agrupar páginas de un documento, pero no reconocerá que dos documentos describen una misma estancia hospitalaria. La detección de duplicados es una tarea de revisión, y la columna Flag existe para registrarla.
No compara campos entre documentos ni hace aritmética de fechas como juicio. No decidirá que el rango de la factura contradice el informe de alta, ni calculará un intervalo de tratamiento para indicarle si ese intervalo importa clínicamente. Una columna calculada puede sumar cargos dentro de las líneas de un documento; el razonamiento entre documentos es suyo.
No asigna números Bates ni garantiza una página legible. La identidad de la página es un dato de entrada. El reconocimiento es sólido en texto impreso y tablas impresas, y el nivel de procesamiento superior ayuda con escritura manuscrita densa y diseños complejos, pero ningún modelo recupera una página que era ilegible cuando se escaneó. Volver a solicitar al custodio es a veces la solución correcta, y la marca GAP registra por qué.
El límite de cumplimiento es aparte. El manejo de información de salud protegida depende de la autorización del despacho, del alcance mínimo necesario y de un acuerdo de asociado comercial con cualquier proveedor que toque los datos. La herramienta de extracción procesa el documento; no exime al despacho de sus obligaciones. Los requisitos se detallan en esta guía sobre HIPAA y extracción de documentos médicos.
Los estados de cuenta hospitalarios detallados necesitan su propio lote. Son documentos financieros con convenciones distintas de fecha de servicio, que se extraen mejor con el enfoque de factura médica a Excel y luego se unen a la tabla clínica por fecha y centro, en lugar de fusionarse en ella.
Una secuencia viable para una producción de 3.000 páginas
Ejecute el trabajo en este orden y la tabla se mantiene auditable en cada traspaso. El orden importa porque los dos errores costosos, volver a estampar páginas y volver a teclear filas, provienen de hacer primero un paso posterior.
Inventario antes de leer
Enumere cada fuente productora con su rango de fechas, número de páginas, rango Bates y fecha de recepción. Luego enumere los registros que la producción referencia pero no contiene. Esa lista de faltantes se convierte después en filas GAP. Responsable: paralegal.
Fije la identidad de las páginas
Conserve los números Bates de la parte productora si existen. Estampe un prefijo y una secuencia si no existen. Registre la tabla de concordancia. Hágalo antes de extraer una sola fila. Responsable: paralegal o soporte de litigios.
Congele las columnas con el abogado
Acuerde las ocho columnas antes de procesar. Cambiar una definición después de que existan 2.000 filas significa reprocesar el lote. Responsable: el paralegal redacta, el abogado aprueba.
Agrupe por fuente, con la fusión desactivada por defecto
Un lote por centro o rango Bates. Active Multi-Page Merge solo para documentos que realmente abarquen varias páginas, y agrupe por un identificador de documento. Responsable: paralegal.
Revise según las consecuencias
Verifique las filas ancla con verificación de cuadro delimitador y luego trabaje las marcas CONFLICT y DUPLICATE. Registre quién revisó qué rango. Esto requiere tiempo de calendario, no tiempo libre. Responsable: consultora de enfermería legal y paralegal, con aprobación del abogado.
Construya la cronología a partir de la tabla
Ordene por fecha, seleccione los eventos que importan a la teoría del caso, redacte la narrativa neutral y traslade la cita a cada fila de la cronología. Cuando lleguen nuevos registros, agregue filas y vuelva a ordenar. Responsable: consultora de enfermería legal o asociado.
La pasada automática no es el riesgo del cronograma. A 5 o 10 segundos por página, el procesamiento se mide en horas incluso para una producción grande. La revisión y el seguimiento de los registros faltantes deciden si la tabla está lista, y ambos dependen de que la identidad de las páginas sea correcta antes de que se ejecute el primer lote.
Un despacho que ya extrae otros documentos del caso reconocerá la forma. La cronología del caso construida a partir de hilos de correo electrónico sigue la misma lógica: leer una vez, registrar cada evento como una fila, citar la fuente y luego ordenar. Los registros médicos añaden dos restricciones que el correo electrónico no tiene: una identidad de página que debe sobrevivir a la reproducción complementaria y un vocabulario clínico que un revisor debe interpretar.
Los equipos que procesan informes de imagen e informes de alta en un entorno clínico o de investigación trabajan con mecánicas de lote similares pero con un grano de salida distinto; ese flujo de trabajo se trata en extracción de datos clínicos por lotes para investigación. La versión para litigios es más estrecha a propósito: cada fila necesita una página a la que un tribunal pueda remitirse.
Preguntas frecuentes
¿Puede la IA extraer datos de registros médicos escaneados?
Sí, para registros mecanografiados y gran parte del material manuscrito, porque la extracción lee la imagen de la página en lugar de depender de una capa de texto. La calidad va en función de la calidad del escaneo. Un PDF digital limpio es un trabajo distinto al de un fax de tercera generación, y una página ilegible para una persona no se volverá fiable porque un modelo la haya leído.
¿Cómo mantengo una cita de página en cada fila?
Conviértala en una columna. Solicite el número Bates o el número de página impreso como campo, conserve la numeración de la parte productora y verifique una muestra de filas con el resaltado de cuadro delimitador para confirmar que el valor proviene de la página que la fila indica. La herramienta lee el número; no lo asigna.
¿Cuál es la diferencia entre una cronología médica y una tabla de extracción de registros médicos?
La tabla es una fila por evento documentado con procedencia. La cronología es una narración seleccionada y fechada de los eventos que importan, construida a partir de esas filas. La tabla es completa y mecánica; la cronología es selectiva y argumentada.
¿Puede un informe de alta que abarca cuatro páginas convertirse en una sola fila?
Sí, con la fusión de varias páginas configurada para agrupar las páginas por un identificador de documento. En una producción en la que cada página es un documento separado, deje la fusión desactivada, o visitas no relacionadas que comparten una fecha pueden plegarse en una sola fila.
¿La tabla detecta cuándo dos documentos describen la misma visita?
No. Puede fusionar páginas de un documento y puede arrastrar una marca que usted establezca, pero reconocer que una nota de ingreso y un informe de alta describen una misma estancia hospitalaria es un juicio de revisión. Trate la detección de duplicados como un paso humano y regístrelo en la columna Flag.
¿Es seguro subir información de salud protegida?
Solo bajo la configuración de cumplimiento de la propia firma: un acuerdo de asociado comercial firmado cuando se requiera, una autorización para la divulgación y un alcance limitado a lo que el asunto necesite. La herramienta de extracción es una parte de esa cadena, no un sustituto de ella.
La cronología es el argumento. La tabla es la evidencia. Construya primero la evidencia, con un número de página en cada fila, y el argumento tendrá algo sobre lo que sostenerse.
Una producción que llegó como 3,000 páginas debe salir del paso de extracción como una sola tabla ordenable, con una cita en cada fila y una lista breve de conflictos que una persona aún debe resolver. Es un entregable más pequeño que una cronología terminada, y es el que hace defendible la cronología.
Vea cómo se ve su propia producción como una sola tabla citada