ドイツの給与明細書(Lohnabrechnung)をExcelに
総支給額(Brutto)、手取り額(Netto)、すべての控除を抽出
ドイツの給与明細書には、総支給額、賃金税、連帯付加税、教会税、健康保険、年金保険、失業保険、介護保険、税級など、少なくとも15の個別ラベル付きフィールドが3つのブロックに分かれて記載されています。人事部からLohnabrechnungをPDFで受け取っている場合(ドイツのほとんどの従業員がそうですが)、給与履歴を追跡したい、税理士用のデータを準備したい、またはチーム従業員の給与を監査したい場合、毎月同じ作業に直面します:PDFを開き、略語や参照行の中から各フィールドを見つけ、スプレッドシートに入力し、それを繰り返す。給与明細書1枚なら3分の手間です。しかし、20人の従業員の1年分の給与明細書——240枚——となると、1つの入力ミスが分析全体を狂わせるデータ入力に丸1日かかります。
重要なポイント
- 50%:ドイツの給与明細書のすべての行をExcelにコピーすると、控除額をこれだけ過大計上することになります。控除行の半分は雇用主負担分(参照額)であり、給与から差し引かれる金額ではないからです。
- テンプレートベースのOCRは、すべてのフィールドがページ上の固定位置にあることを前提としています。しかし、DATEV、Lexware、Personioのドイツの給与明細書では、同じ15の必須フィールドがまったく異なるレイアウトで配置されているため、ある雇用主の形式でトレーニングされたテンプレートは、他の形式では機能しません。
- ImageToTable.aiはピクセル座標ではなくフィールドの意味を読み取るため、再設定するテンプレートなしで、DATEV、Lexware、Personioの給与明細書全体で同じ列名を正確に抽出でき、計算列がすべての行で控除率を自動的に計算します。
ドイツの給与明細書の内容 — 総支給額と手取り額だけではない
ドイツの給与明細書は、雇用主や給与ソフトウェアによってLohnabrechnung、Gehaltsabrechnung、Entgeltabrechnungと呼ばれますが、プロバイダーごとに正確なレイアウトは異なるものの、予測可能な3つのブロック構造に従っています。抽出を試みる前に、単一の密集した表としてではなく、ブロックとして読むことが最初に必要なスキルです。
ブロック1 — ヘッダーと識別情報。雇用主名と住所、従業員名、Personal-Nr.(人事番号)、Geburtsdatum(生年月日)、Steuer-ID(税識別番号)、SV-Nummer(社会保険番号)、Steuerklasse(税級I〜VI)、Kinderfreibetrag(児童手当の数)、Konfession(宗教的所属 — EVはプロテスタント、RKはカトリック、またはなしの場合はダッシュ)、Krankenkasse(健康保険基金名)、およびAbrechnungszeitraum(給与期間、通常は暦月)。
ブロック2 — 収入と控除。ここでお金が動きます。収入側:GehaltまたはGrundgehalt(基本給)、さらにÜberstunden(残業手当)、Zuschläge(シフト/週末/祝日割増)、Urlaubsgeld(休暇手当)、WeihnachtsgeldまたはSonderzahlung(クリスマスボーナスまたは一時金)、geldwerter Vorteil(社用車などの現物支給の課税対象利益)、およびVL AG(資本形成給付への雇用主拠出)。次に控除側:Lohnsteuer(賃金税、主な所得税源泉徴収)、Solidaritätszuschlag(連帯付加税、Lohnsteuerの5.5%、現在は高所得者のみ)、Kirchensteuer(教会税、Lohnsteuerの8〜9%)、および4つの社会保険料 — Krankenversicherung(KV、健康保険)、Rentenversicherung(RV、年金保険)、Arbeitslosenversicherung(AV、失業保険)、およびPflegeversicherung(PV、介護保険)。
ブロック3 — 合計と支払い。最終行にはGesamtbrutto(総支給額)、すべての控除の合計、NettoverdienstまたはAuszahlungsbetrag(銀行口座に振り込まれる手取り額)、および場合によっては年初来の累計額が表示されます。
よくある落とし穴:多くの給与明細書には、健康保険、年金保険、失業保険、介護保険の雇用主負担分も記載されています。これらはページ上では追加の控除のように見えますが、あなたの給与から差し引かれるお金ではありません。雇用主が支払った金額を示す情報項目です。一方、労災保険(Unfallversicherung)の保険料は全額雇用主が負担するため、従業員の給与明細書には記載されないことがよくあります。控除のように見える行をすべて無差別にスプレッドシートにコピーすると、実際の控除額を約50%過大に見積もることになります。これは最も一般的な抽出エラーであり、以下のセクションでその回避方法を説明します。
§108 GewO(営業法第108条)の枠組み:雇用主があなたに示すべきもの、そしてあなたが抽出できるもの
ドイツの営業法(§108 Gewerbeordnung)第108条は、すべての雇用主に対し、給与支払いのたびに従業員に給与明細書をテキスト形式で提供することを義務付けています。法律は最低限の内容を規定しています:Abrechnungszeitraum(給与計算期間)、Zusammensetzung des Arbeitsentgelts(報酬の構成 — 割増金、手当、その他の報酬の種類と金額を含む)、Art und Höhe der Abzüge(控除の種類と金額)、およびAbschlagszahlungenまたはVorschüsse(前払金)です。
また、この法律にはELStAMシステム(Elektronische Lohnsteuerabzugsmerkmale)が組み込まれています。これは、雇用主が税務当局から取得してあなたの税級、児童手当、教会税のステータスを設定するための電子賃金税控除特徴です。結婚、出産、または副業の開始によりあなたのSteuerklasse(税級)が変更された場合、その変更はELStAMを通じて伝達され、次回の給与明細書に反映されます。総支給額が変わらなくても手取り額が変動することがあり、その理由は給与明細書のヘッダーブロックに記載されています。
この法的枠組みは抽出において何を意味するのでしょうか? 3つのポイントがあります:
第一に、項目は概念としては標準化されていますが、レイアウトは標準化されていません。ドイツのすべての雇用主は、同じカテゴリーの情報をあなたに示さなければなりません。しかし、DATEV LODASが画面上でそれらの項目を配置する方法は、Lexware lohn+gehaltの配置方法とは異なり、Personio Payroll、SVS lohn+gehalt、またはWISO lohn+gehaltを使用する小規模雇用主からの紙の給与明細書ともまた異なります。テンプレートベースの抽出 — ある給与明細書のレイアウト上で「Nettogehalt(手取り額)」の周りに枠を描く方法 — は、別の雇用主から給与明細書を受け取ったり、現在の雇用主が給与計算ソフトウェアを変更したりした瞬間に機能しなくなります。
第二に、従業員負担分と雇用主負担分の区分は法律で定義されています。BMASを通じて管理されるドイツの社会保険制度は、各社会保険料を雇用主と従業員でおおむね50/50に分割します。PwCおよびOECDによって確認された2026年の保険料率では、健康保険の総保険料率は総支給額の14.6%に加えて、保険者固有のZusatzbeitrag(追加保険料)が平均約1.7%であり、従業員は約8.15%を負担し、雇用主が残りを負担します。年金保険は18.6%(各9.3%)、失業保険は2.6%(各1.3%)、介護保険は子供が1人いる親の場合は3.6%、23歳以上で子供のいない従業員の場合は4.0%(各側が半分を負担し、子供のいない場合の追加負担は従業員が負担します)。これらの保険料率は、2026年に引き上げられた保険料算定上限額(Beitragsbemessungsgrenzen)に達するまで適用されます — 西部州では年金保険/失業保険で年間約96,600ユーロ、健康保険ではそれより高くなります。抽出する際に、どの行が従業員負担分の控除で、どの行が雇用主負担分の参考金額かを知ることで、50%の過大計上エラーを防ぐことができます。
第三に、雇用主は給与明細書を6年間保管する義務があります — ただし、従業員も自身のコピーを保管すべきです。§108 GewO(営業法第108条)および一般的な保管義務に基づき、以前の雇用主に不足している給与明細書を請求できます。その際、給与計算システムからのPDFエクスポートを受け取る可能性が高いでしょう。5年間で2回転職した場合、現在3つの異なるレイアウトの給与明細書を持っているかもしれません。それが、この記事が解決しようとしている抽出の課題です。
テンプレートベースのOCRがドイツの給与明細書で失敗する理由 — 代わりに機能する方法
文書データ抽出の標準的なアプローチであるテンプレートベースのOCRは、固定された文書レイアウトを前提としています。1つのサンプル上のフィールドの周りにバウンディングボックスを描いてシステムをトレーニングします:「Nettogehaltは座標(x=140, y=320)にあります。」その後、システムは後続のすべての文書でそれらの正確なピクセル位置のテキストを探します。これは、IRSが正確なフィールド位置を義務付けている米国のW-2のような標準化されたフォームでは機能します。
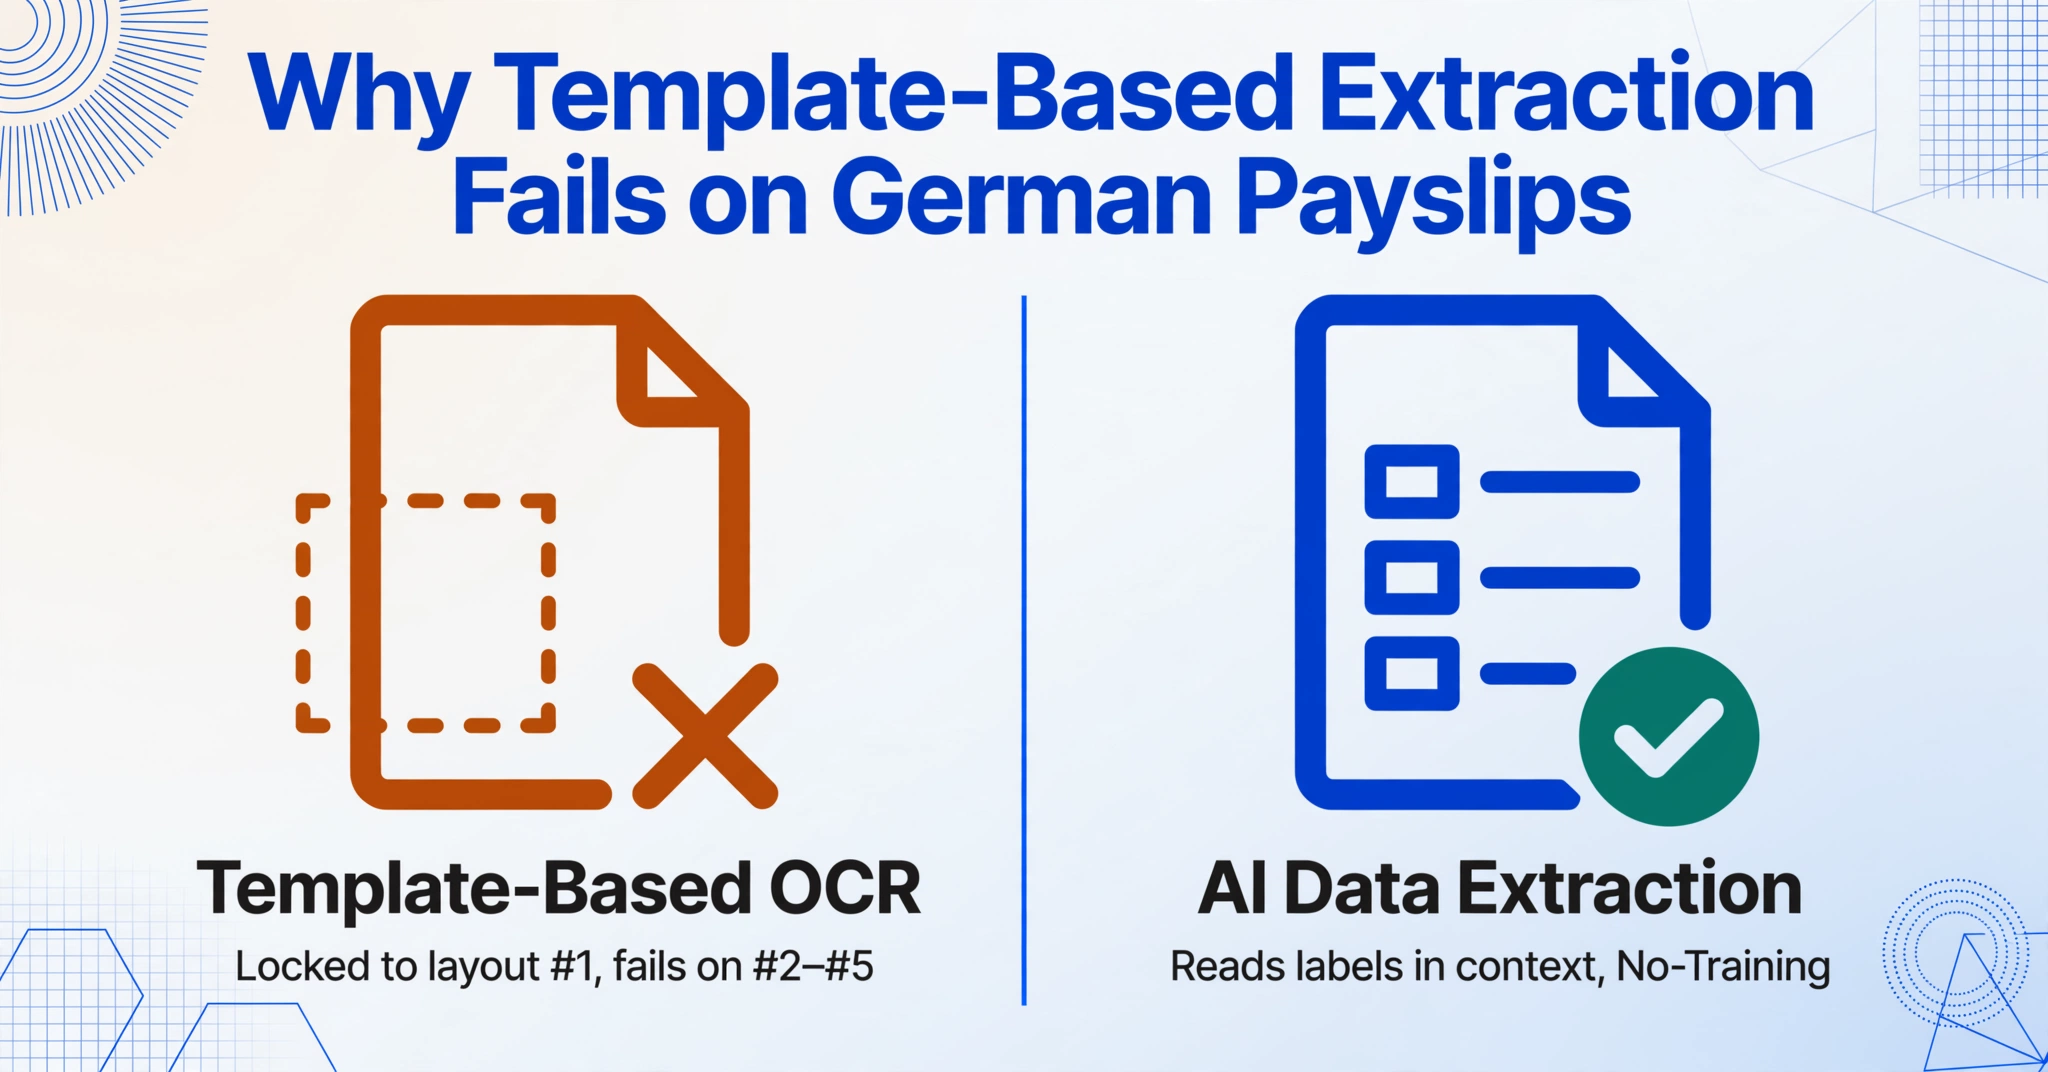
ドイツの給与明細書は、その正反対です。中規模のGmbHからのDATEV LODAS給与明細書は、従業員識別子ブロックを左上に配置し、控除項目を収入行の下に2列で、手取り額を右下に配置します。小規模企業からのLexware lohn+gehalt給与明細書は、収入と控除を単一の縦リストとして、下部に合計を表示する場合があります。Personio Payroll PDFは、異なる列幅の表形式レイアウトにすべてのフィールドを埋め込む場合があります。ADDISON Lohnを使用するHandwerksbetriebからの古い紙の給与明細書は、まったく異なる略語を使用する場合があります — Lohnsteuerの代わりにLSt、Sozialversicherungの代わりにSV。5人の異なる雇用主からの5人の従業員は、5つの異なるレイアウトを意味します。レイアウト#1でトレーニングされたテンプレートは、レイアウト#2から#5では失敗します。
AIベースの抽出はこれを別の方法で解決します。ピクセル座標を照合する代わりに、ビジョン言語モデルは人間と同じように文書を読み取ります:各テキストが文脈で何を意味するかを理解することによって。あなたは列名を定義します — 「Bruttogehalt」「Lohnsteuer」「Krankenversicherung」「Steuerklasse」などの必要なデータフィールド — するとAIは、フィールドの意味(収入セクションの上部近くの総支給額の数字)を認識して、ページ上の位置ではなく、各文書の対応する値を特定します。これがカスタム列抽出です:必要なフィールド名を入力すると、AIがレイアウトに関係なく各フィールドをページ上の正しい数字に一致させます。
このアプローチは、実際のドイツの給与明細書の多様性を実践的に処理します。DATEVの給与明細書は健康保険を「KV-Beitrag (AN-Anteil)」と表示し、Lexwareの給与明細書は「Krankenversicherung Arbeitnehmer」、Personioの給与明細書は「Health Insurance (Employee Share)」と表示するかもしれません — システムがこれら3つすべてが同じ概念(従業員側の健康保険拠出金)を指していると理解すれば、1つの統合された列が得られます。同じ列名が、再構成なしで3つのレイアウトすべてで機能します。これが、1つのレイアウトで機能するテンプレートと、任意のレイアウトで機能する抽出の違いです。
これは、訂正や臨時の給与明細書にも当てはまります。ボーナスの計算ミスによるKorrekturabrechnung(訂正給与明細書)や、税級の更新が遅れた場合のNachberechnung(遡及調整)が発行された場合、これらの書類は通常の月次給与明細書にはない追加の訂正行や参照フィールドを含む、変更されたレイアウトを使用することがよくあります。固定テンプレートでは、予期しない位置にあるフィールドを見つけることができません。セマンティック抽出は、「Bruttogehalt」の意味が変わっていないため適応できます。ページ上の位置が変わっただけです。
ステップバイステップ:給与明細書PDFから構造化Excelへ
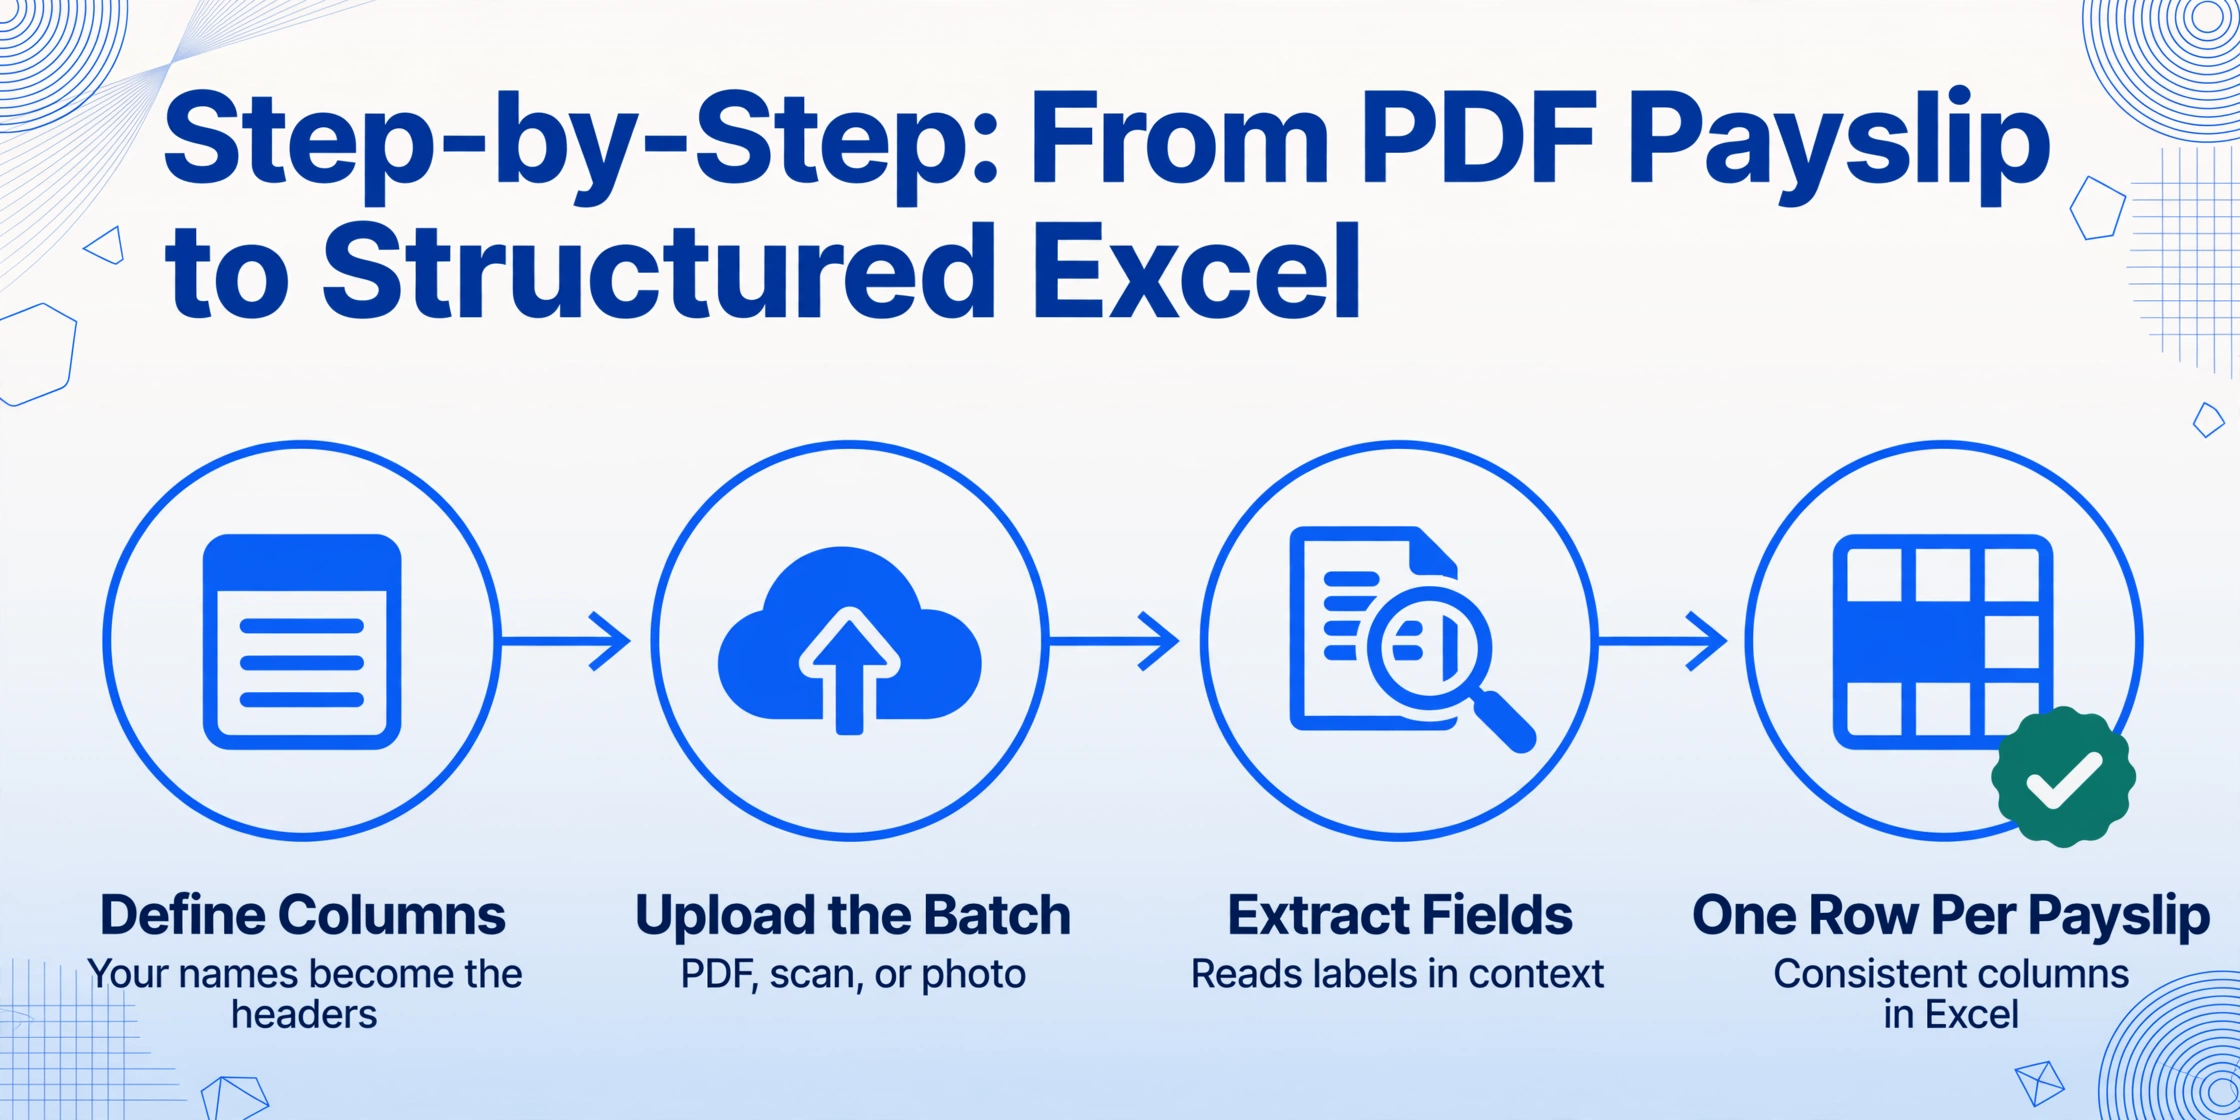
このワークフローは、ドイツの給与明細書PDFの束(現在の雇用主からの月次書類、以前の仕事からのアーカイブファイル、スキャンした紙のコピー、またはそれらの混合)があり、給与明細書ごとに1行、一貫した列を持つ1つのExcelファイルが必要であることを前提としています。
ステップ1:抽出列を定義します。入力した列名が、出力スプレッドシートのヘッダーになります。包括的なドイツの給与明細書抽出には、以下から始めてください:
| 列名 | ドイツの給与明細書のラベル | 内容 |
|---|---|---|
| Abrechnungszeitraum | Abrechnungszeitraum / Abrechnungsmonat | 給与計算期間(月/年) |
| Personal-Nr. | Personal-Nr. / Arbeitnehmer-Nr. | 従業員番号 |
| Steuerklasse | StKl. / Steuerklasse | 税級(I〜VI) |
| Bruttogehalt (EUR) | Brutto / Gesamtbrutto / Steuer-Brutto | 控除前の総支給額 |
| Lohnsteuer (EUR) | LSt / Lohnsteuer | 天引きされた賃金税 |
| Solidaritätszuschlag (EUR) | SolZ / Solidaritätszuschlag | 連帯付加税(該当する場合) |
| Kirchensteuer (EUR) | KiSt / Kirchensteuer | 教会税(該当する場合) |
| Krankenversicherung AN (EUR) | KV / KV-Beitrag (AN-Anteil) | 従業員の健康保険負担分 |
| Rentenversicherung AN (EUR) | RV / RV-Beitrag (AN-Anteil) | 従業員の年金保険負担分 |
| Arbeitslosenversicherung AN (EUR) | AV / AV-Beitrag (AN-Anteil) | 従業員の失業保険負担分 |
| Pflegeversicherung AN (EUR) | PV / PV-Beitrag (AN-Anteil) | 従業員の介護保険負担分 |
| Nettogehalt (EUR) | Netto / Auszahlungsbetrag / Nettoverdienst | 銀行口座に振り込まれる手取り額 |
| Krankenkasse | Krankenkasse / KK | 健康保険組合名(例:TK、AOK、Barmer) |
各社会保険列の「AN」という接尾辞に注目してください。ANはArbeitnehmer(従業員)を意味します。列名にこれを追加することで、雇用主側の参考値ではなく、従業員側の金額を具体的に求めていることをAIに伝えられます。これはドイツの給与明細書の抽出における最も重要な命名規則です。従業員の控除と雇用主負担分の参考額を混同してしまう50%の過大計上を防ぎます。
ステップ2: 即時分析のための計算列を追加する。 生のフィールドを取得したら、抽出中に結果を計算する列を定義できます。後でExcelで数式を実行する必要はありません。例えば:
- 控除率(%) = (すべての控除の合計)÷ 総支給額 × 100 — 実効控除率が1つの数値で得られます。これは、ほとんどの人が月ごとの給与明細書を比較する際に実際に使用する方法です。
- 手取り・総支給比率 = 手取り額 ÷ 総支給額 — 手取り比率です。ドイツ人はこれを口語的に「Netto vom Brutto」と呼び、求人を評価する際にほとんどの人が最初に尋ねる数字です。
- SV-Gesamt AN (EUR) = KV + RV + AV + PV — 従業員の社会保険負担の合計で、約21%の総支給額ベンチマークとの比較に役立ちます。
これが計算列の機能です。生の数値を抽出してからExcelで数式を作成する代わりに、計算を列名として一度定義すれば、AIが抽出中に計算を実行します。完成したスプレッドシートが得られます。出発点ではなく。
ステップ3: すべての給与明細書を一度にアップロードします。 PDFをアップロードエリアにドラッグしてください — 過去12か月分の月次給与明細書、訂正給与明細書、異なるレイアウトの前職の給与明細書、何年も前のスキャンした紙のコピーなど。AIが各書類を個別に読み取り、どの給与ソフトウェアがどのPDFを生成したかに関係なく、同じ列セットに入力します。
ファイルは安全に処理され、保存されません。
ステップ4: Excelにエクスポートします。 出力は1つの構造化されたスプレッドシートです — 給与明細書ごとに1行、指定した名前の列、分析、税務申告の準備、または税理士との共有に適した一貫した形式のすべての金額が含まれます。計算列を含めた場合、控除率と手取り・総支給比率はすべての行ですでに計算されています。
エッジケースへの対応:変動給、修正、複数勤務先の給与明細書
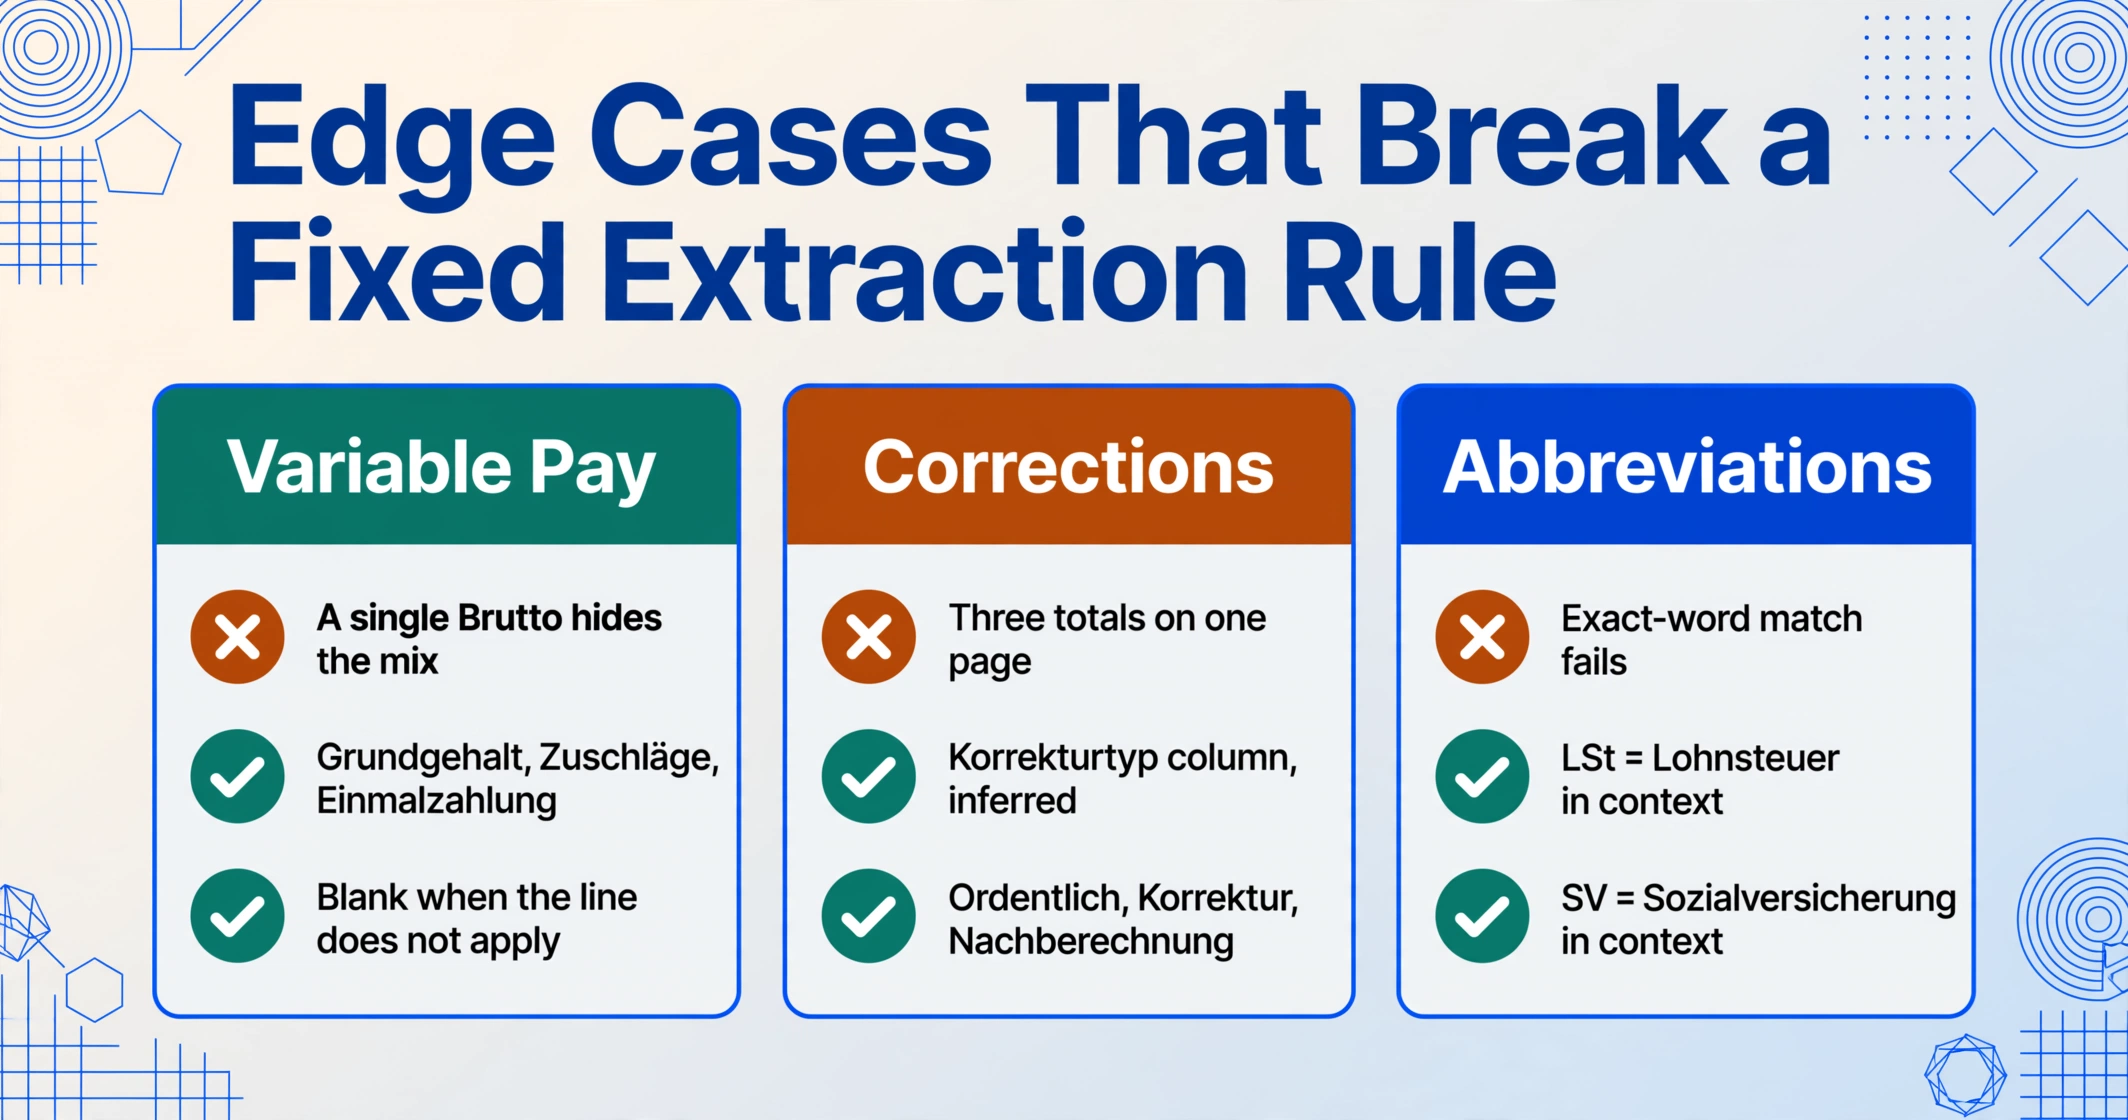
ドイツの給与計算には、単純に「すべての給与明細書から同じ5つの項目を抽出する」という方法では対応できない、繰り返し発生するエッジケースがいくつかあります。それぞれに独自の列戦略が必要です。
変動収入 — 残業代、ボーナス、現物給付。 11月の給与明細書には、Weihnachtsgeld(クリスマスボーナス)が別の収入項目として記載されている場合があります。夏の給与明細書にはUrlaubsgeld(休暇手当)が表示されることもあります。夜勤をした月の給与明細書には、§3b EStGに基づき一部非課税となるZuschläge(割増手当)が含まれることがあります。「総支給額」だけを抽出すると合計額は得られますが、基本給とボーナスの内訳はわかりません。解決策は、「Grundgehalt (EUR)」「Zuschläge (EUR)」「Einmalzahlung (EUR)」「Geldwerter Vorteil (EUR)」という個別の列を追加することです。該当しない月は空白のままにし、該当する月は追跡可能な詳細情報を得られます。
Korrekturabrechnung(修正計算書)とNachberechnung(追徴計算書)。 修正用の給与明細書は、前月の給与計算エントリを調整するものです — ボーナスの見落とし、残業時間の過少計上、税級の変更が遅れた場合などです。これらの書類には、元の金額、修正差額、新しい合計がすべて1ページに表示されることがよくあります。単一の「手取り額」フィールドを探すテンプレートベースのシステムでは、誤った数値を取得したり、文書自体をスキップしたりする可能性があります。セマンティック抽出は、修正コンテキストを読み取ることでこれを処理します。「Korrekturtyp」列(推論値:ordentlich、Korrektur、Nachberechnung)を推論列を使用して追加できます — AIがコンテンツに基づいて文書タイプを分類します — そして、監査証跡用に元の値を保持しながら、修正後の金額を個別の列として抽出します。
税級VIと副業の給与明細書。 副業(月額€538を超えるMinijobまたは通常のNebenjob)をお持ちの場合、その給与明細書は税級VI — 最も高い源泉徴収税率の税級 — を使用します。副業の給与明細書は、税級I〜Vの本業の給与明細書とは異なる控除パターンになります。複数の仕事や年度をまたいで給与明細書を比較する場合、税級の列は、同じ総支給額でも手取り額がまったく異なる理由を理解するための重要なコンテキストになります。
Jahresmeldung(年間報告書)と年度末の書類。 1月または2月に、多くのドイツの雇用主は12月または1月の給与明細書とともにJahresmeldung(年間社会保険報告書)を発行します。これは給与明細書ではなく、暦年の社会保険料総額の要約であり、健康保険に提出されます。給与明細書の項目のように見える年初来のSV合計が含まれていますが、目的は報告用です。抽出ワークフローでは、これらを13か月目の給与明細書として扱うのではなく、別の文書タイプとして識別する必要があります。
複数月の給与明細ダッシュボード作成:実際の疑問に答える給与追跡
一貫したExcel形式で12か月分または24か月分の給与明細データが揃えば、その活用方法は単なる記録管理を超えて広がります。以下は、r/Finanzenなどのフォーラムでドイツのプロフェッショナルが頻繁に挙げる3つの活用例です。
給与交渉の準備。 雇用主に対して、過去2年間の実際の手取り額の推移を示したい場合、税級の段階的上昇(kalte Progression)、社会保険料の上限引き上げ、変動ボーナス支給の純効果を考慮する必要があります。月ごとに1行、基本給と各ボーナス種別の列、そして手取り・総支給比率の計算列を備えたスプレッドシートがあれば、会話の起点となる単一の数値が得られます:「総支給額は安定しているにもかかわらず、BBGの引き上げとZusatzbeitragの調整により、手取り比率は18か月で58%から54%に低下しました。」これは感情ではなく、定量化された主張です。
確定申告(Steuererklärung)の準備。 年間のLohnsteuerbescheinigung(賃金税証明書、ドイツ版W-2)には、賃金税、連帯付加税、教会税、社会保険料の年間合計が示されています。しかし、税務署(Finanzamt)が特定の月について質問する可能性があり、同じ形式で月次内訳を用意しておけば、年間合計と月次データを数分で照合できます。フリーランサーや複数の収入源(selbstständige Nebentätigkeit)を持つ従業員にとっては、所得税申告(Einkommensteuererklärung)のために雇用収入と自営収入を分離する必要があるため、これは不可欠です。
ビザ申請とローン申請。 ドイツの移民当局(Ausländerbehörde)や銀行(住宅ローンの申請時)は、収入証明として直近3〜6か月分の給与明細を定期的に要求します。給与明細がメールの添付ファイル、6か月でアーカイブされる人事ポータル、フォルダに保存したPDFに散在している場合、その都度1時間かけて探し出すことになります。雇用開始以来のすべての給与明細を1つのスプレッドシートにまとめ(必要に応じて再度PDFに抽出可能)、繰り返し発生する面倒な作業を30秒のタスクに変えられます。
ここで説明する抽出ワークフローは、これら3つの活用例すべてのフロントエンドです。データがExcelに取り込まれれば—クリーンで構造化され、各フィールドが元のPDF上の正確な位置にトレース可能—その後の作業はデータ入力ではなく分析になります。
FAQ: ドイツ給与明細書のデータ抽出
AI抽出は手書きの給与明細書や写真撮影された紙のコピーでも機能しますか?
はい、適切な入力品質があれば可能です。AIモデルは画像からテキストを読み取るため、印刷された給与明細書を明るく撮影した写真は、元のPDFとほぼ同様に機能します。給与明細書への手書きの注釈(手書きで修正された残業時間や人事からの手書きメモなど)も抽出できますが、手書き文字の精度は印刷されたテキストよりも本質的に低く、特に複雑なドイツ語の複合語では顕著です。主要な印刷フィールド(総支給額、賃金税、社会保険料)については、鮮明な写真での精度はPDFと同等です。余白に走り書きされた人事メモについては、精度は低下しますが、実用的な結果が期待できます。
このツールは、雇用主負担分(Arbeitgeberanteil)と従業員負担分(Arbeitnehmeranteil)を区別できますか?
部分的に可能です。AIはラベルを文脈に沿って読み取ります。「AG-Anteil」や「Arbeitgeberanteil」と明示的に記載された行は、「AN-Anteil」や「Arbeitnehmeranteil」と区別できます。ただし、最も信頼性の高い方法は、前述の列名戦略です。列名に「AN」を含めること(例:「Krankenversicherung AN (EUR)」)で、AIに従業員負担分を具体的に抽出するよう指示できます。給与明細書が従業員負担分と雇用主負担分を別々に表示していない場合(一部のコンパクトなレイアウトでは、合計の保険料率のみが記載されています)、AIはそれらを分割できません。その情報が単にページ上に存在しないからです。そのような場合は、合計額を抽出し、手動で確認する必要があることをメモしてください。
このツールは、ドイツの主要な給与計算プロバイダーすべての給与明細書で動作しますか?
はい、DATEV LODAS、Lexware lohn+gehalt、Personio Payroll、SVS lohn+gehalt、WISO lohn+gehalt、ADDISON Lohnに対応しています。これは、抽出がテンプレートベースではなく意味論的に行われるためです。同じ列名セット(総支給額、賃金税、KV ANなど)を使用すれば、PDFを生成したソフトウェアに関係なく、正しい値を見つけ出します。プロバイダーごとにレイアウト固有の設定を構成する必要はありません。唯一の注意点は、給与明細書が非常に標準的でない略語を使用している場合です。例えば、小規模な手工業事業所が独自のラベルを考案するニッチな給与計算ツールを使用している場合、AIの確信度が低下する可能性があります。実際には、標準的なフィールド(Brutto、Netto、LSt、KV、RV、AV、PV、StKl)は、すべての主要プロバイダーで安定しています。
ドイツの給与明細書の抽出精度はどの程度ですか?
印刷され、はっきりと読み取れるPDFの給与明細書の場合、主要な数値フィールド(EUR単位の金額、税級、給与計算期間)は通常95%以上の精度に達します。つまり、ほとんどのフィールドが最初のパスで正しく抽出されます。精度が低下する領域は、印刷された給与明細書への手書きの修正、数字がぼやけるほど圧縮されたまたは低解像度のスキャン、控除行が密集した珍しい複数列レイアウトの給与明細書です。正直なアドバイス:最初の抽出結果は常に元のPDFと照合して確認してください。特に、照合の基準となる手取り額の合計は重要です。フィールドが誤って抽出された場合は、出力で修正でき、同じ給与明細書やバッチ内の他のフィールドには影響しません。
複数の従業員の給与明細書を一括処理できますか?
はい。すべての従業員のすべての給与明細書を1つのバッチでアップロードできます。10人の従業員×12か月分=120枚のPDFをまとめてアップロード。出力は1つのExcelファイルで、各行が1枚の給与明細書に対応します。個人番号または従業員名列により、各行を正しい従業員に追跡できます。このワークフローは、複数従業員の給与明細書アーカイブを管理するHRチームや給与計算サービスプロバイダーにとっての中核的なユースケースです。列名は一度定義すると、バッチ全体に適用されます。
特定の給与明細書にフィールドがない場合はどうなりますか?
その行のセルは空白のままになります。たとえば、「教会税(EUR)」列を定義し、従業員が徴税教会に登録されていない場合、AIはゼロを入力したり推測したりせず、そのセルを正しく空白のままにします。これは期待される動作です。教会税列の空白セルは実際には情報を伝えています(この従業員は教会税を支払っていない)。