Dos personas procesaron el mismo archivo.
El que estaba al lado nunca se tocó
Cuando el equipo exportó el lote, una factura ya se había extraído dos veces, así que la hoja de cálculo contenía dos filas para la misma cuenta, y el archivo que estaba junto a ella nunca fue reclamado por nadie. La duplicación y la brecha no provinieron de un modelo de extracción defectuoso. Provinieron de dos personas dividiendo una cola compartida a mano. APQC, la organización sin fines de lucro de evaluación comparativa, encuentra que sus trabajadores del conocimiento encuestados dedican en promedio unas 2.0 horas por semana a recrear información y trabajo que ya existe en la organización (APQC, 2024). Dentro de un lote de extracción, esa recreación tiene una forma muy específica: un documento trabajado dos veces, otro trabajado nunca.
Conclusiones clave
- Dos personas procesaron la misma factura mientras el archivo que estaba junto a ella nunca se abrió, y ninguna de las dos hizo algo descuidado.
- El lote tiene fugas en cuatro lugares, y ninguno de ellos es el modelo de extracción: una división acordada en el chat, un estado finalizado mantenido en memoria, un retrabajo re-subido como trabajo nuevo y un alcance que nadie puede definir.
- La cobertura deja de ser una lista de asistencia por chat y se convierte en una sola lectura de la lista del lote, donde un archivo sin estado finalizado es un archivo que nadie ha reclamado.
El mismo archivo, procesado dos veces, y un archivo que nadie reclamó
Un lote de documentos funciona correctamente cuando cada archivo se procesa exactamente una vez. El fallo tiene dos direcciones. El trabajo duplicado es el lado alto: dos miembros del equipo toman cada uno la misma factura, la procesan mediante extracción, y aparecen dos filas en la tabla exportada donde debería haber una. Un archivo huérfano es el lado bajo: un documento queda sin tocar porque cada persona asumió que otra lo tomaría, y solo se nota en la liquidación cuando el estado de cuenta del proveedor no coincide.
Las personas que viven esto describen el momento sin dramatismo. Un desarrollador en r/cscareerquestions escribió sobre hacer un trabajo que un compañero ya había terminado: "El compañero interviene diciendo que ya está completado" (r/cscareerquestions, 2023). La magnitud del problema tampoco es difícil de encontrar: la investigación Anatomy of Work de Asana sitúa el tiempo anual de trabajo duplicado del trabajador del conocimiento promedio en aproximadamente 209 horas, frente a 103 horas en reuniones innecesarias y 352 horas hablando sobre el trabajo (Índice Anatomy of Work de Asana).
Una forma útil de ver esto es una donde la detección de duplicados a nivel contable y el trabajo duplicado a nivel de procesamiento son animales distintos. Detectar facturas duplicadas en el paso de AP, cotejar una factura de proveedor que entró dos veces al sistema, es un problema propio con sus propias salvaguardas (nuestra guía sobre detección de facturas duplicadas). Lo que cubre este artículo es la otra capa: el mismo archivo subido que pasa por las manos de dos compañeros, o por las manos de nadie, antes de llegar al libro mayor.
Un lote compartido es una cola donde cada archivo necesita exactamente un propietario y un estado finalizado registrado. El trabajo duplicado y los archivos huérfanos son la misma enfermedad: la cola no tiene ninguno de los dos.
Cómo debería verse el flujo de trabajo dividido
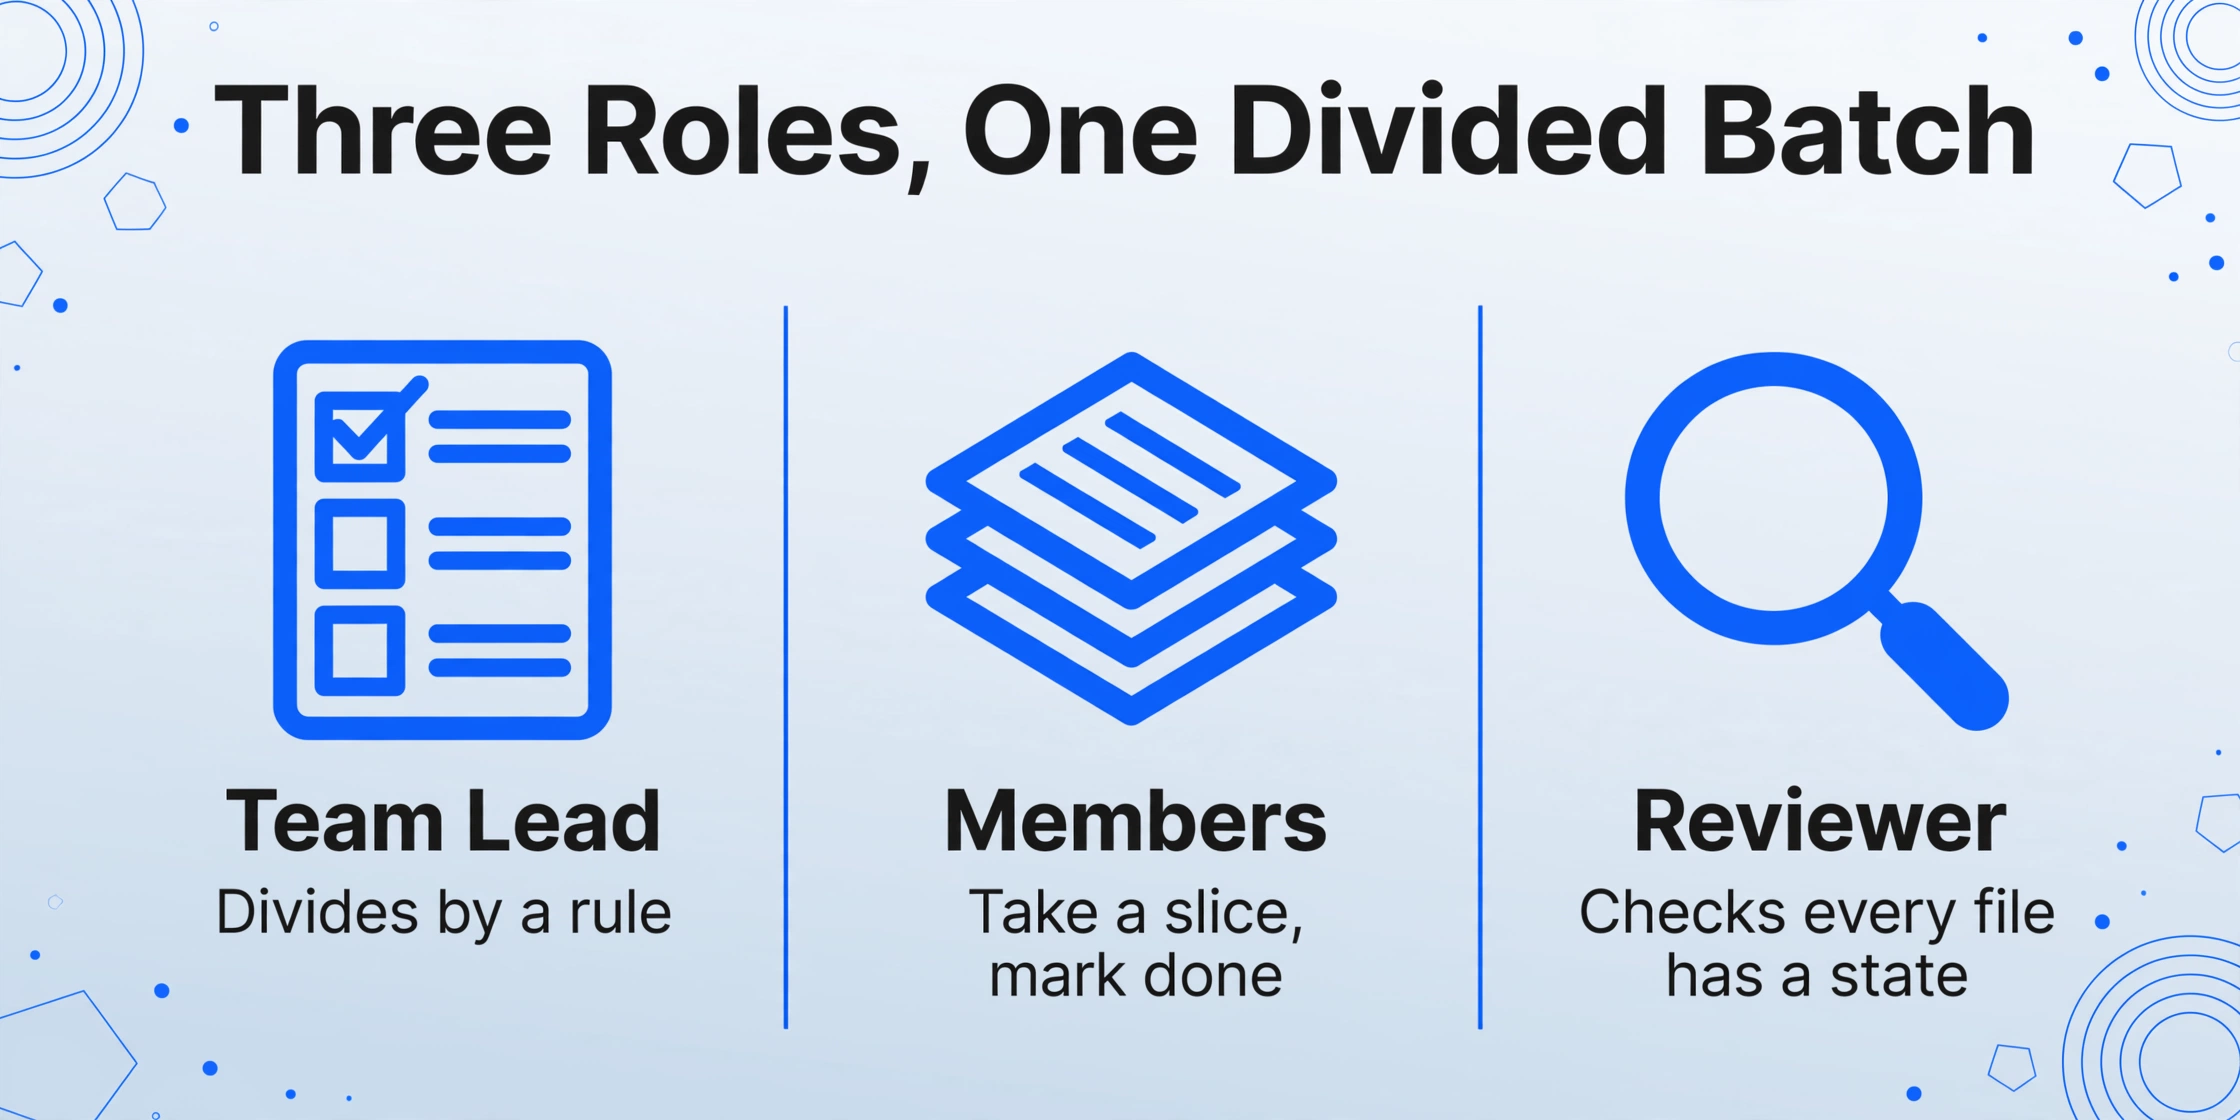
Tres roles llevan un lote dividido, y cada uno tiene una relación diferente con la cola.
| Rol | Lo que realmente hacen | Lo que tienen |
|---|---|---|
| Líder de equipo | Define las columnas de salida, divide el lote según una regla documentada, verifica la finalización antes de la exportación | La lista maestra de lo que hay en el lote y quién debía tomar qué |
| Miembros | Toman una parte, suben cada documento, revisan los valores extraídos, marcan el trabajo como hecho | Su pila local de "hecho" y el hilo de chat donde se anuncian los avances |
| Revisor | Detecta archivos que dos personas tocaron, encuentra archivos que nadie tocó, verifica antes de la exportación | Una estimación de la cobertura, formada preguntando a las personas en lugar de consultar una lista |
El ritmo saludable no es complicado. El líder divide según una regla que cualquiera puede repetir (los primeros cincuenta por orden de llegada, o un proveedor por persona, o una región por miembro). Los miembros trabajan sus partes. El revisor toma la lista maestra, verifica que cada elemento tenga un estado finalizado y solo entonces exporta. La mecánica es la parte fácil.
La parte difícil es dónde vive el "hecho". Ahora mismo suele vivir en un hilo de chat como una serie de mensajes, y en la memoria del líder como un recuento en curso. Ninguno de los dos se puede consultar a las 11 p. m. la noche antes del cierre. La verdad contable de un lote dividido es que el rastreador de hojas de cálculo contiene el texto, el gestor de tareas contiene las asignaciones y la herramienta de extracción contiene los documentos y su estado de procesamiento, y ninguno de esos tres se comunica con los demás. Un especialista en cuentas por cobrar en r/Accounting describió la misma estructura colapsando a su alrededor: "Estoy al límite" (r/Accounting, 2025).
La guía completa para construir esta estructura de forma limpia está en nuestro recorrido separado sobre cómo dividir un lote de documentos entre un equipo. Ese artículo cubre la construcción. Este trata sobre dónde una construcción razonable aún tiene fugas: los cuatro lugares donde un lote dividido se rompe incluso cuando todos tienen buenas intenciones.
Cuatro lugares donde la división se rompe
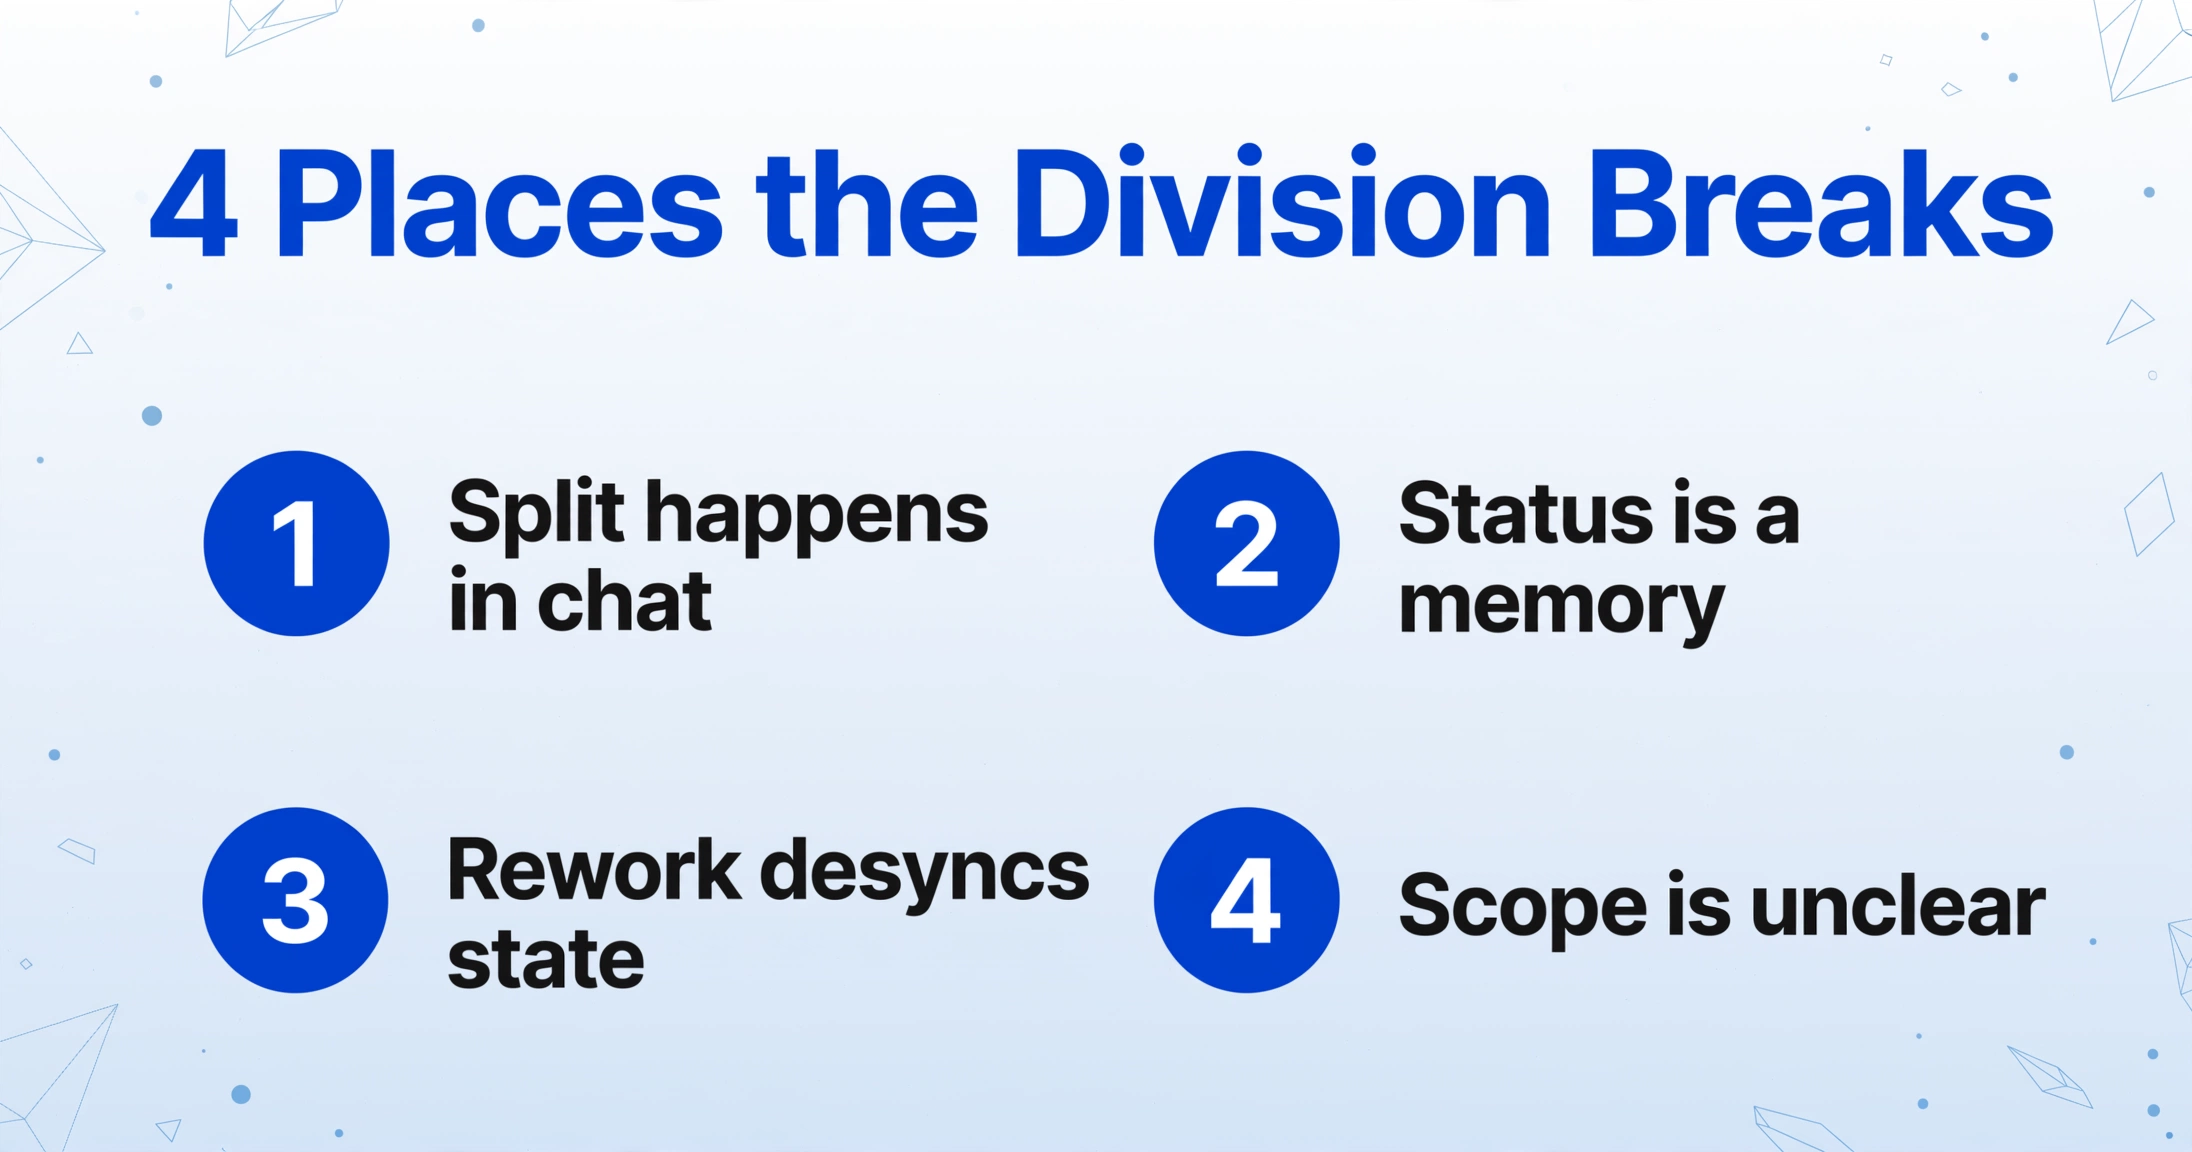
Ninguno de estos fallos requiere malas intenciones o una herramienta defectuosa. Son estructurales, y cada uno se corresponde con una operación específica que el equipo realiza manualmente.
Observe lo que los cuatro tienen en común: son fallos de coordinación, no de extracción. Un modelo más rápido o más inteligente no aborda ninguno de ellos, porque el cuello de botella no es la lectura de documentos, sino el seguimiento de quién es dueño de cada documento. La solución debe cambiar la estructura de la cola, no la calidad del OCR.
La Configuración de Equipo que Corresponde a Cada Paso Roto
La respuesta del lado del producto es el espacio de trabajo de equipo: una estructura de cuenta compartida en ImageToTable.ai donde un plan de equipo cubre a un conjunto de miembros con un límite de miembros configurado, los miembros se unen con un código que el propietario comparte, y el procesamiento de todos se descuenta de un grupo de créditos compartido. Es un único espacio de trabajo, no una pila de cuentas personales. Tres de sus ajustes se alinean con tres de los cuatro pasos rotos mencionados arriba.
Una cuenta compartida en lugar de inicios de sesión personales responde a la ruptura del alcance de membresía. Cuando todos los miembros trabajan en los mismos lotes bajo la misma cuenta de equipo, "quién puede tocar qué" deja de ser una decisión subjetiva basada en qué inicio de sesión es dueño del archivo. Nadie necesita enrutar un archivo a través de su cuota personal, y nadie vuelve a ejecutar trabajo finalizado por precaución porque no puede saber qué cuenta lo cubre.
La vista de lote compartida responde a la ruptura del estado-como-memoria. En un espacio de trabajo de equipo, cada miembro abre la misma lista de lotes, y cada archivo en ella lleva su propio estado de procesamiento, visible para todo el equipo. Esa es la visibilidad de WIP que prescribe Kanban: cada archivo con un estado es una tarea activa que todos pueden ver. La pregunta de cobertura del revisor, "¿alguien lo obtuvo todo?", deja de ser una lista de verificación por chat y se convierte en una lectura de la lista de lotes, donde un archivo sin estado finalizado es un archivo sin dueño todavía.
Una única tabla exportada responde a la ruptura de la desincronización por retrabajo. El trabajo finalizado de cada miembro se integra en una tabla de resultados con las mismas columnas, de modo que cuando un archivo se retrabaja y se vuelve a exportar, el revisor ve las filas del mismo documento lado a lado en lugar de descubrir el duplicado en la liquidación. La salida a continuación es la vista con la que trabaja cada miembro: suba el documento, defina las columnas, y el lote rastrea el estado de cada archivo en un solo lugar.
Los archivos se procesan de forma segura y no se almacenan.
Un límite honesto del lado del producto: las herramientas anteriores hacen visible la cobertura, pero no asignan archivos a personas. La regla de división, la decisión de "tú te encargas de la A a la M", sigue perteneciendo al líder de equipo, y el revisor sigue decidiendo si una fila finalizada es lo suficientemente buena para enviarse. Esa es la división correcta de responsabilidades, y vale la pena ser precisos al respecto (si es nuevo en ejecutar un lote completo a través de la extracción, el tutorial de lote de documentos a Excel comienza un nivel antes).
Lo que un lote compartido aún no resuelve
El límite de esta configuración merece la misma honestidad que sus fortalezas. Convierte la cobertura en una lista visible; no hace que la lista se mantenga sola.
Dos miembros aún pueden decidir tomar el mismo archivo dentro del mismo minuto. La vista de estado compartida hace que la colisión sea visible poco después de que ocurra, y la superficie de exportación única facilita detectarla, pero nada bloquea un archivo para una persona en el instante en que alguien lo abre. El hábito más sólido sigue siendo las asignaciones hechas de antemano por un líder, respaldadas por la vista compartida como segunda verificación.
La concurrencia también es un techo gestionado, no uno infinito. El plan de equipo establece el lote y la capacidad de procesamiento de forma centralizada, y el producto ejecuta un modelo de concurrencia estricto y aceptado bajo ese techo. Entre procesos de procesamiento separados, la verificación de capacidad compartida tiene un límite flexible conocido: bajo carga máxima puede otorgar brevemente uno o dos espacios más de los que el plan permite nominalmente, y luego se autocorrige en el siguiente ciclo. No afirmamos una concurrencia libre de conflictos, porque no es cierta, y un equipo que planifique un cierre de lanzamiento ajustado debe tener en cuenta ese margen en lugar de asumir que el flujo de trabajo es ilimitado.
El criterio del revisor es lo último que no se automatiza. La lista del lote dice "finalizado". Decidir si "finalizado" es lo suficientemente preciso para alimentar el registro sigue siendo una persona que compara una fila con un documento, y ese criterio es intencional.
Contratiempos en el procesamiento de lotes de equipo: preguntas frecuentes
¿Cómo sabemos si dos personas procesaron el mismo archivo?
En un espacio de trabajo de equipo, cada archivo del lote tiene un estado que todos los miembros pueden ver, por lo que una segunda persona que abra un archivo ya finalizado lo verá de inmediato en lugar de adivinar. La tabla de resultados exportados es la segunda verificación: un documento que se procesó dos veces muestra dos filas con el mismo archivo de origen, y el revisor lo resuelve antes de la exportación en lugar de hacerlo en la liquidación.
¿Qué pasa si un archivo queda en el lote sin que nadie lo reclame?
El estado es el localizador. Un archivo que nunca se procesó simplemente nunca llega a un estado finalizado, y el revisor lee la lista del lote para detectar cualquier archivo sin uno. Esa lectura es la verificación de cobertura. Se convierte en un escaneo de la cola en lugar de un recuerdo de quién dijo qué en el chat.
¿Cada miembro del equipo necesita su propio plan de pago?
No. El espacio de trabajo de equipo permite que un plan de equipo cubra a varios miembros. Los miembros se unen con el código que comparte el propietario, trabajan en los mismos lotes en la misma cuenta y usan el mismo grupo de créditos compartido, por lo que el equipo no compra una suscripción por persona.
¿Puede la herramienta asignar archivos a personas automáticamente?
Expone el estado de cada archivo a todos y consolida los resultados en una sola tabla, pero la regla de división en sí permanece en el proceso del equipo, y el líder es quien define las partes. La herramienta hace que el resultado de la división sea visible y corregible; no reemplaza la división.
¿Hay un límite en cuántos archivos puede procesar el equipo a la vez?
Sí. El plan de equipo establece la capacidad de procesamiento de forma centralizada, y ese límite es donde se gestiona la concurrencia. Bajo carga máxima, la verificación de capacidad compartida puede emitir brevemente uno o dos espacios de más entre procesos antes de autocorregirse; el margen existe a propósito, así que planifique las ventanas de lanzamiento con margen normal en lugar de al límite absoluto.
El cambio es de estructura, no de esfuerzo. Un equipo que rastrea la cobertura preguntando "¿alguien se perdió algo?" espera a que el estado de cuenta del proveedor responda. Un equipo que ve una columna de estado por archivo responde la misma pregunta con una sola lectura, y puede detectar tanto el duplicado como el huérfano mientras aún son baratos de corregir. Configure el espacio de trabajo compartido, divida por adelantado y deje que la lista del lote sea la memoria: la construcción paso a paso de esa estructura comienza exactamente donde termina este artículo.