화물 운송장 검증이 물류팀이 생각하는 것보다
더 많은 비용이 드는 이유
일반적인 제품 청구서에는 청구 항목이 네 줄입니다. 하지만 화물 운송장은 단순한 LTL 운송이라도 8~12개 항목이 포함됩니다. 기본 운임. 견적 발행 이후 변경된 지수를 기준으로 산출된 유류 할증료. 각각 해당 운송사 고유 코드로 청구되는 3~5개의 부가 요금(리프트게이트, 주거지 배송, 실내 배송, 체류료, 예약 수수료). 픽업과 청구 사이에 등급이 변경되었을 수 있는 화물 등급. 운송장을 다 읽고 나면 단순히 대금을 확인하는 것이 아니라 계약 스프레드시트, 운임 확인서 이메일, 지난주 화요일에 업데이트된 유류 할증료 표, NMFC 등급 조회 결과를 대조해 복합 문서를 감사하는 셈입니다. 대부분의 물류팀은 이 교차 검증 작업을 월말 마감에 쫓기며 Excel에서 수동으로 수행합니다. 그리고 업계 데이터에 따르면 이러한 운송장의 5~10%에는 아무도 발견하지 못하는 초과 청구가 최소 하나 이상 포함되어 있습니다.
핵심 요점
- AP팀은 화물 운송장 검증에 주당 15~20시간을 소비하지만, 그 시간 중 거의 대부분은 실제로 계약 대비 청구 항목 검증에 사용되지 않습니다.
- 화물 운송장의 5~10%에는 초과 청구가 포함되어 있으며, 수천 개의 청구 항목에 대한 라인별 검증이 3일 마감 기한 아래에서는 구조적으로 불가능하기 때문에 이러한 오류는 매월 계속 발생합니다.
- ImageToTable.ai는 화물 운송장 데이터를 10초 만에 추출합니다 — 기존 10분이 걸리던 작업을 — 시간 예산이 뒤집히면 팀은 더 이상 금액 기준으로 분류하지 않고 기본적으로 라인별 검증을 수행하여, 이전에 놓치던 $30,000~$80,000 상당의 회수 가능한 초과 청구를 잡아냅니다.
화물 운송장은 더 긴 제품 청구서가 아닙니다 — 근본적으로 다른 문서입니다
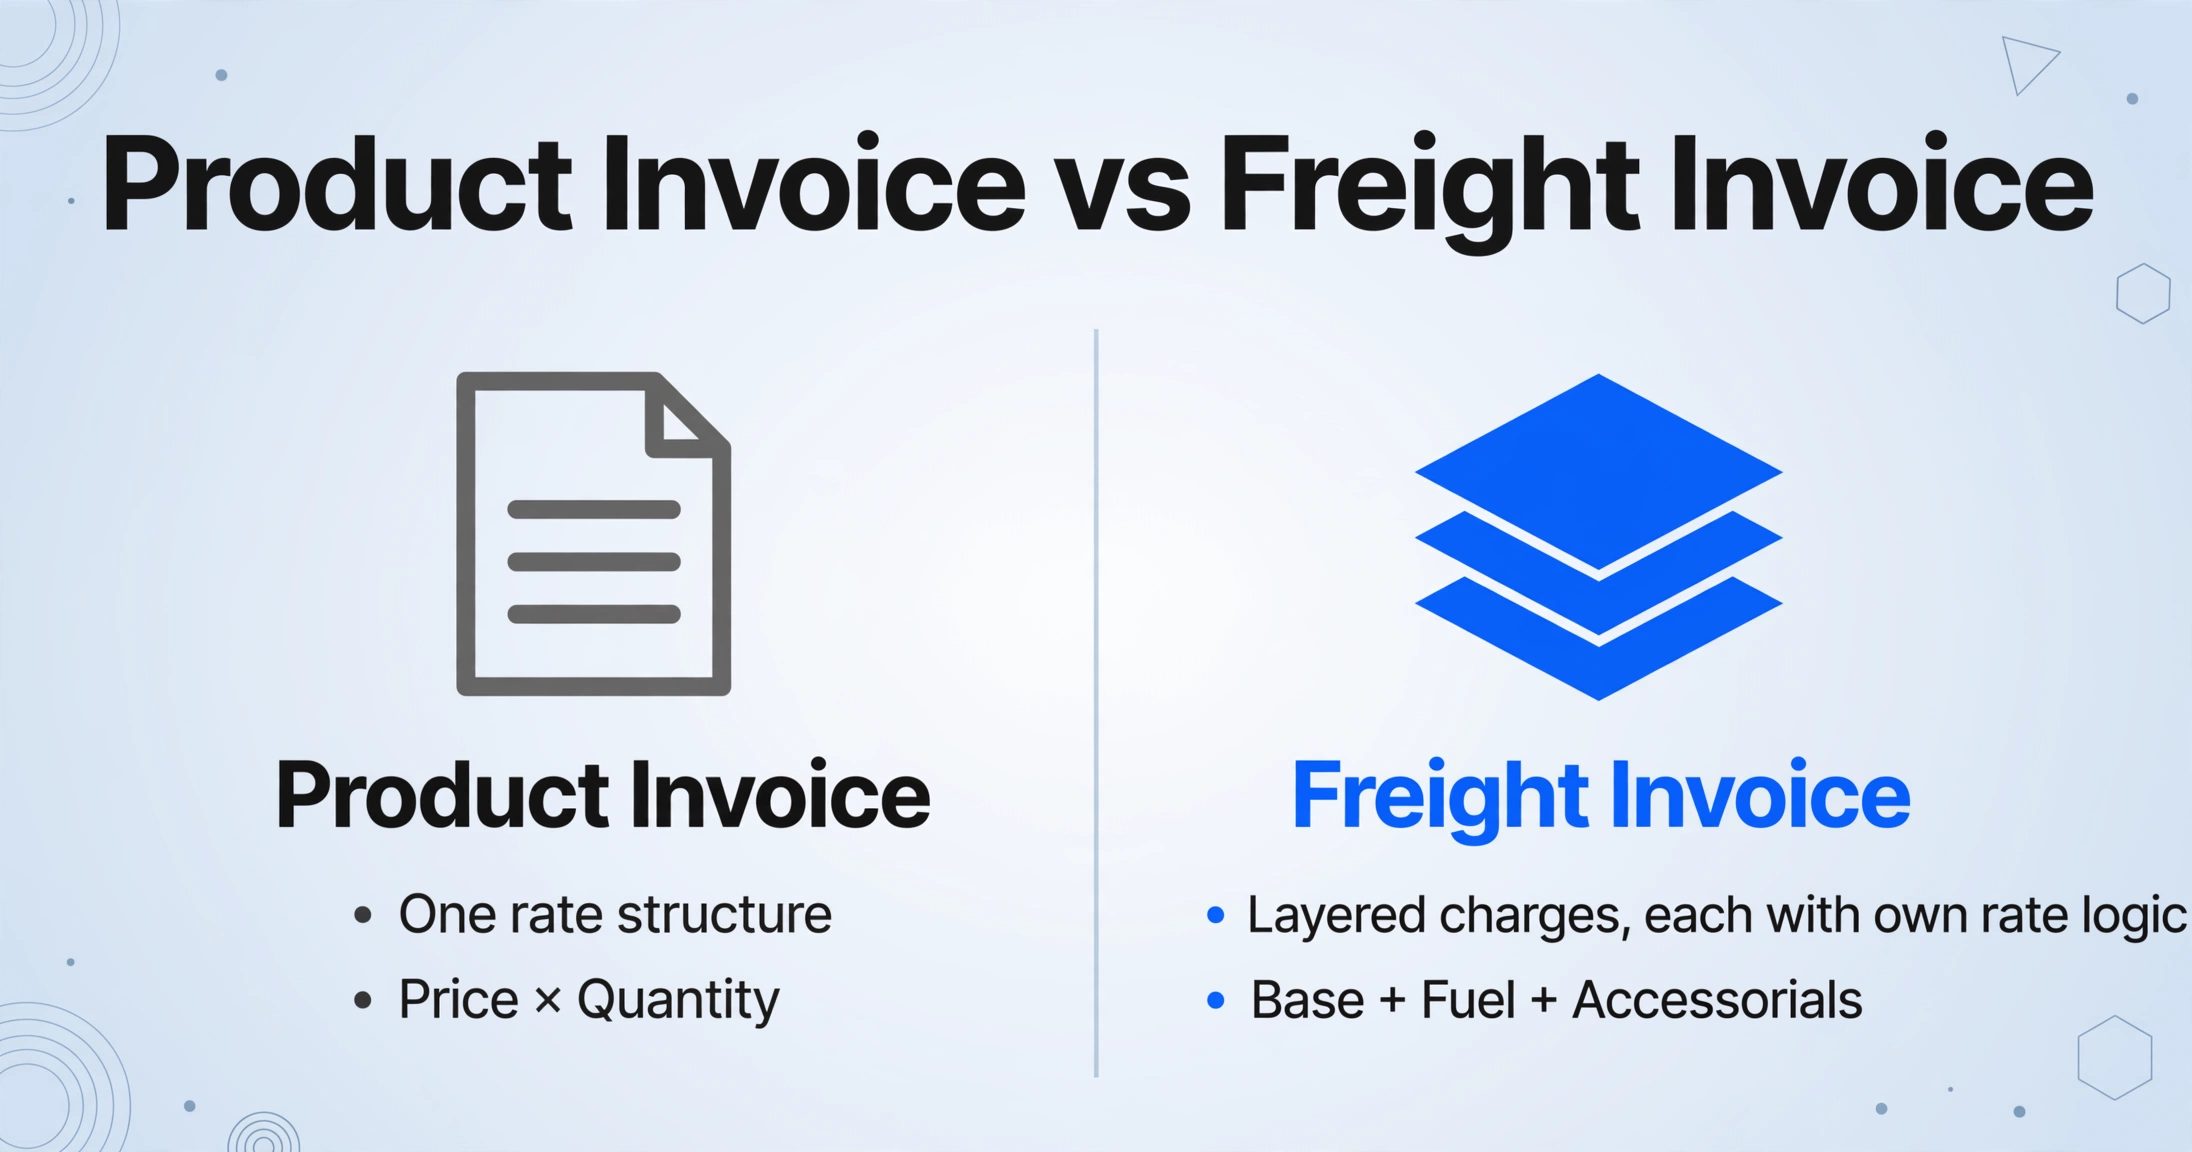
화물 운송장 조정이 일반적인 AP 업무보다 훨씬 많은 시간을 소요하는 이유를 가장 간단히 이해하는 방법은 실제로 조정하는 대상의 수를 세어보는 것입니다. 제품 청구서는 예측 가능한 구조를 따릅니다: 품목 설명, 단가, 수량, 라인 합계, 소계, 세금, 총계. 청구서에는 하나의 요율 구조(합의된 단가), 하나의 할인 등급, 관할 구역별 하나의 세율이 있습니다. 50개 라인 항목이 있는 다중 페이지 제품 청구서도 결국 50개 행에 걸쳐 단 한 가지 — 가격 × 수량 — 을 조정하는 것입니다.
화물 운송장에는 각각 고유한 요율 로직으로 운영되는 계층적 요금이 있습니다. 기본 화물 운임은 출발지-목적지 구간, 중량 분기점, 화물 등급에 따라 결정되는 계약 요율표에서 계산됩니다 — 단 한 달러 금액에 도달하기 전에 이미 세 가지 변수가 있습니다. 유류 할증료는 해당 기본 운임의 일정 비율이지만, 그 비율 자체는 갤런당 $3.00, $3.50, $4.00에 서로 다른 분기점이 있을 수 있는 운송사별 할증료표를 통해 적용되는 미국 에너지정보청(EIA)의 주간 디젤 가격 지수의 함수입니다. 부가 요금 — 대기 시간, 리프트게이트, 주거 지역 배송, 제한 구역 접근, 재배송 — 은 각각 고유한 발생 조건, 고유한 요율, 그리고 많은 경우 고유한 이의 제기 기간이 있습니다. 픽업 후 청구 전에 적용된 NMFC 등급 수정은 그 이전의 모든 계산을 변경합니다.
제품 청구서 조정에서는 여러 행에 걸쳐 하나의 계산을 검증합니다. 화물 운송장에서는 단일 행에서 서로 다른 세 가지에서 다섯 가지 유형의 계산을 검증하며 — 각 유형은 서로 다른 원본 문서를 참조합니다. 검증 작업량은 라인 항목 수에 비례하여 증가하지 않습니다. 라인 항목당 교차 참조하는 요율 체계의 수에 비례하여 증가합니다.
부가 요금만 해도 구조적 비대칭성을 잘 보여줍니다. Nuvocargo의 화물 비용 분석 산업 데이터에 따르면, 부가 요금은 일반적인 화물 운송장에 8-15%를 추가하며, 청구서의 25-40%에는 유류 할증료 외에 최소한 하나의 부가 요금이 포함됩니다. 여러 화주로부터 화물을 통합하는 LTL 프로그램에서는 그 비율이 청구서의 40-60%까지 올라갑니다. 이러한 부가 요금을 청구하는 동일한 운송사들도 동일한 서비스에 대해 서로 다른 내부 코드를 사용합니다. 한 운송사는 트럭 대기 비용을 "detention"이라고 부릅니다. 다른 운송사는 "per diem"이라고 부릅니다. 세 번째 운송사는 대기 시간이 포함될 수도 있고 포함되지 않을 수도 있는 "appointment fee"에 이를 흡수합니다. AP 담당자는 동일한 근본 사건에 대해 세 가지 다른 라인 항목 라벨을 보고, 감사 로직을 적용하기 전에 그것들이 비교 가능하다는 것을 인식해야 합니다.
이것이 제품 청구서 AP 자동화가 설계상 메우지 못한 구조적 격차입니다. "단가"를 PO 라인 항목과 대조하는 표준 청구서 OCR 도구는 현재 분기 23주차의 EIA 디젤 지수를 참조하는 유류 할증료를 처리하는 방법을 모릅니다. 이 도구는 단일 요율 체계를 위해 만들어졌습니다. 화물 운송장은 다섯 가지 체계로 운영됩니다.
캐리어 포털이 문제를 해결하지 못하는 이유 — 오히려 분산시킬 뿐입니다
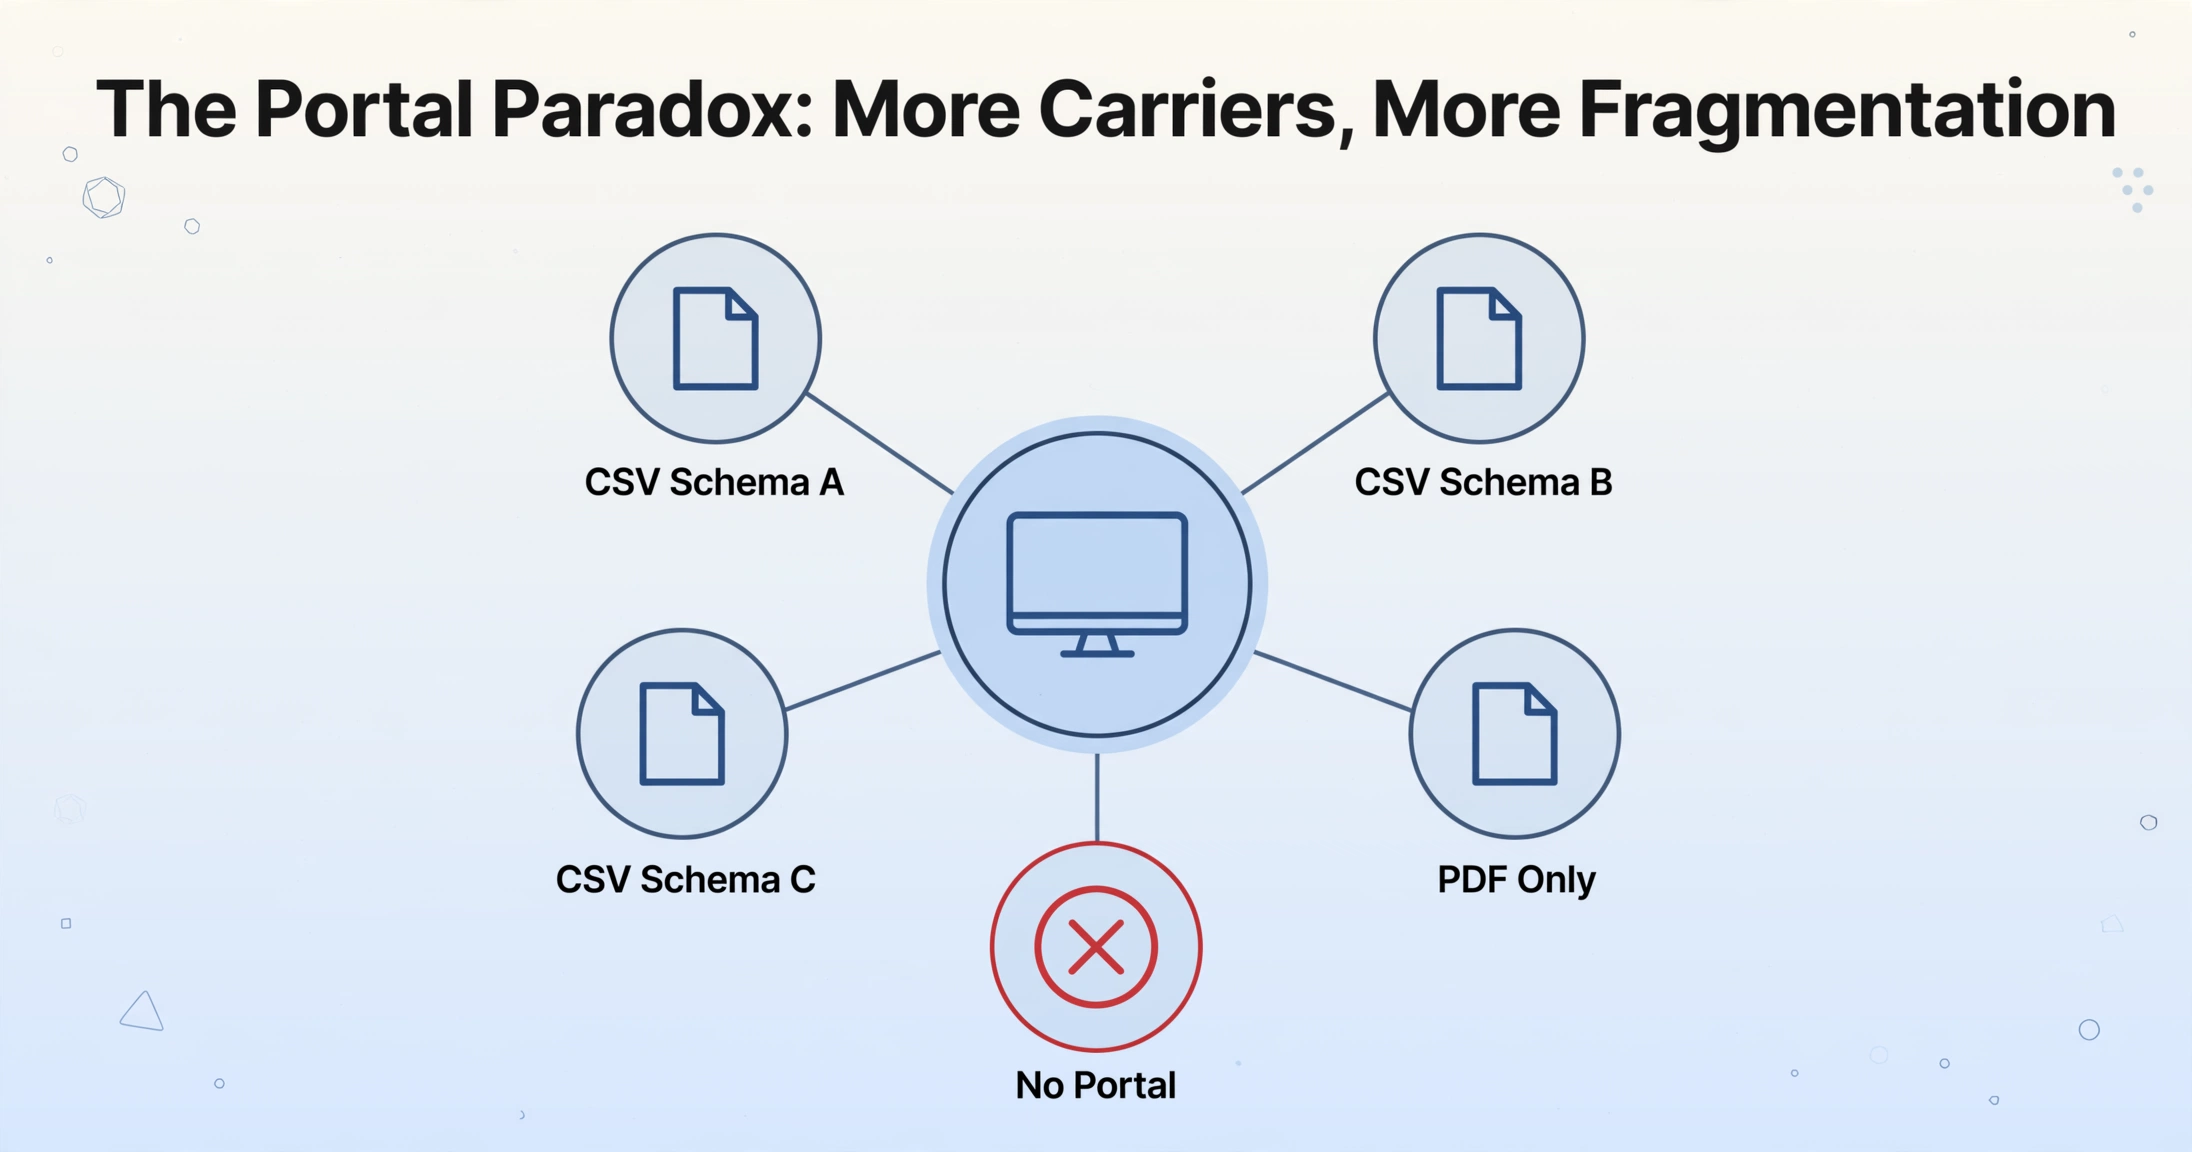
"캐리어 포털을 사용해 운송장 데이터를 다운로드하라"는 일반적인 조언은 완전한 수작업 입력과 완전한 자동화 사이의 합리적인 중간 단계처럼 들립니다. 그러나 실제로는 병목 현상 하나를 여덟 개로 바꿀 뿐입니다.
5~10개 캐리어와 거래하는 중견 규모 화주는 각각 고유한 로그인, 고유한 데이터 내보내기 형식, 고유한 "다운로드 가능한 보고서" 정의를 가진 5~10개의 서로 다른 청구 포털을 마주하게 됩니다. FedEx Freight의 청구 포털은 하나의 CSV 스키마를 내보내고, Old Dominion은 다른 스키마를 내보냅니다. SAIA의 포털은 Estes와 다른 열 계층 구조로 부가 요금을 그룹화합니다. 특정 구간을 담당하는 지역 캐리어는 포털이 전혀 없을 수도 있습니다 — PDF를 이메일로 보내는 방식이죠. AP 팀이 여섯 개 포털에 로그인하고, 여섯 개의 서로 다른 열 구조를 가진 CSV 파일 여섯 개를 다운로드하고, PDF 전용 캐리어 두 곳의 데이터를 다시 입력하는 동안, 실제 운임표와의 비교가 시작되기도 전에 조정 준비에만 30분을 소비하게 됩니다.
이러한 분산은 이론에 그치지 않습니다. 캐리어들은 동일한 서비스를 서로 다른 이름으로 표기합니다 — 한 캐리어의 "실내 배송(inside delivery)"은 다른 캐리어의 "화이트 글러브 서비스(white glove service)"이며, 세 번째 캐리어는 이를 "임계값 배송 — 비주거용(threshold delivery — non-residential)"으로 청구합니다. AP 부서의 누군가가 각 캐리어의 용어를 내부 계정과목표에 수동으로 매핑하기 전까지는, 캐리어 전반에 걸친 통합된 화물 지출 현황을 파악할 수 없습니다. 포털은 데이터를 제공할 뿐, 조정을 제공하지는 않습니다.
이것이 바로 포털 역설입니다: 거래하는 캐리어가 많을수록 "무료" 운송장 데이터 포털도 많아지지만, 실제 조정이 이루어질 수 있는 단일 스프레드시트로 해당 포털들의 데이터를 집계하는 데 드는 시간도 그만큼 늘어납니다. 병목 지점은 "데이터를 얻을 수 없다"에서 "여덟 가지 다른 형태의 데이터를 확보했지만 사용하려면 비교 가능한 형태로 만들어야 한다"로 이동합니다. 많은 물류 AP 팀에게 스프레드시트는 포털 다운로드 데이터가 실제로 사용 가능해지는 곳이며, 그 스프레드시트를 만드는 작업은 어떤 캐리어 포털도 제거하도록 설계되지 않은 수작업입니다.
5-10% 오류율: PDF 뷰어에서는 불가능한 라인 수준 감사
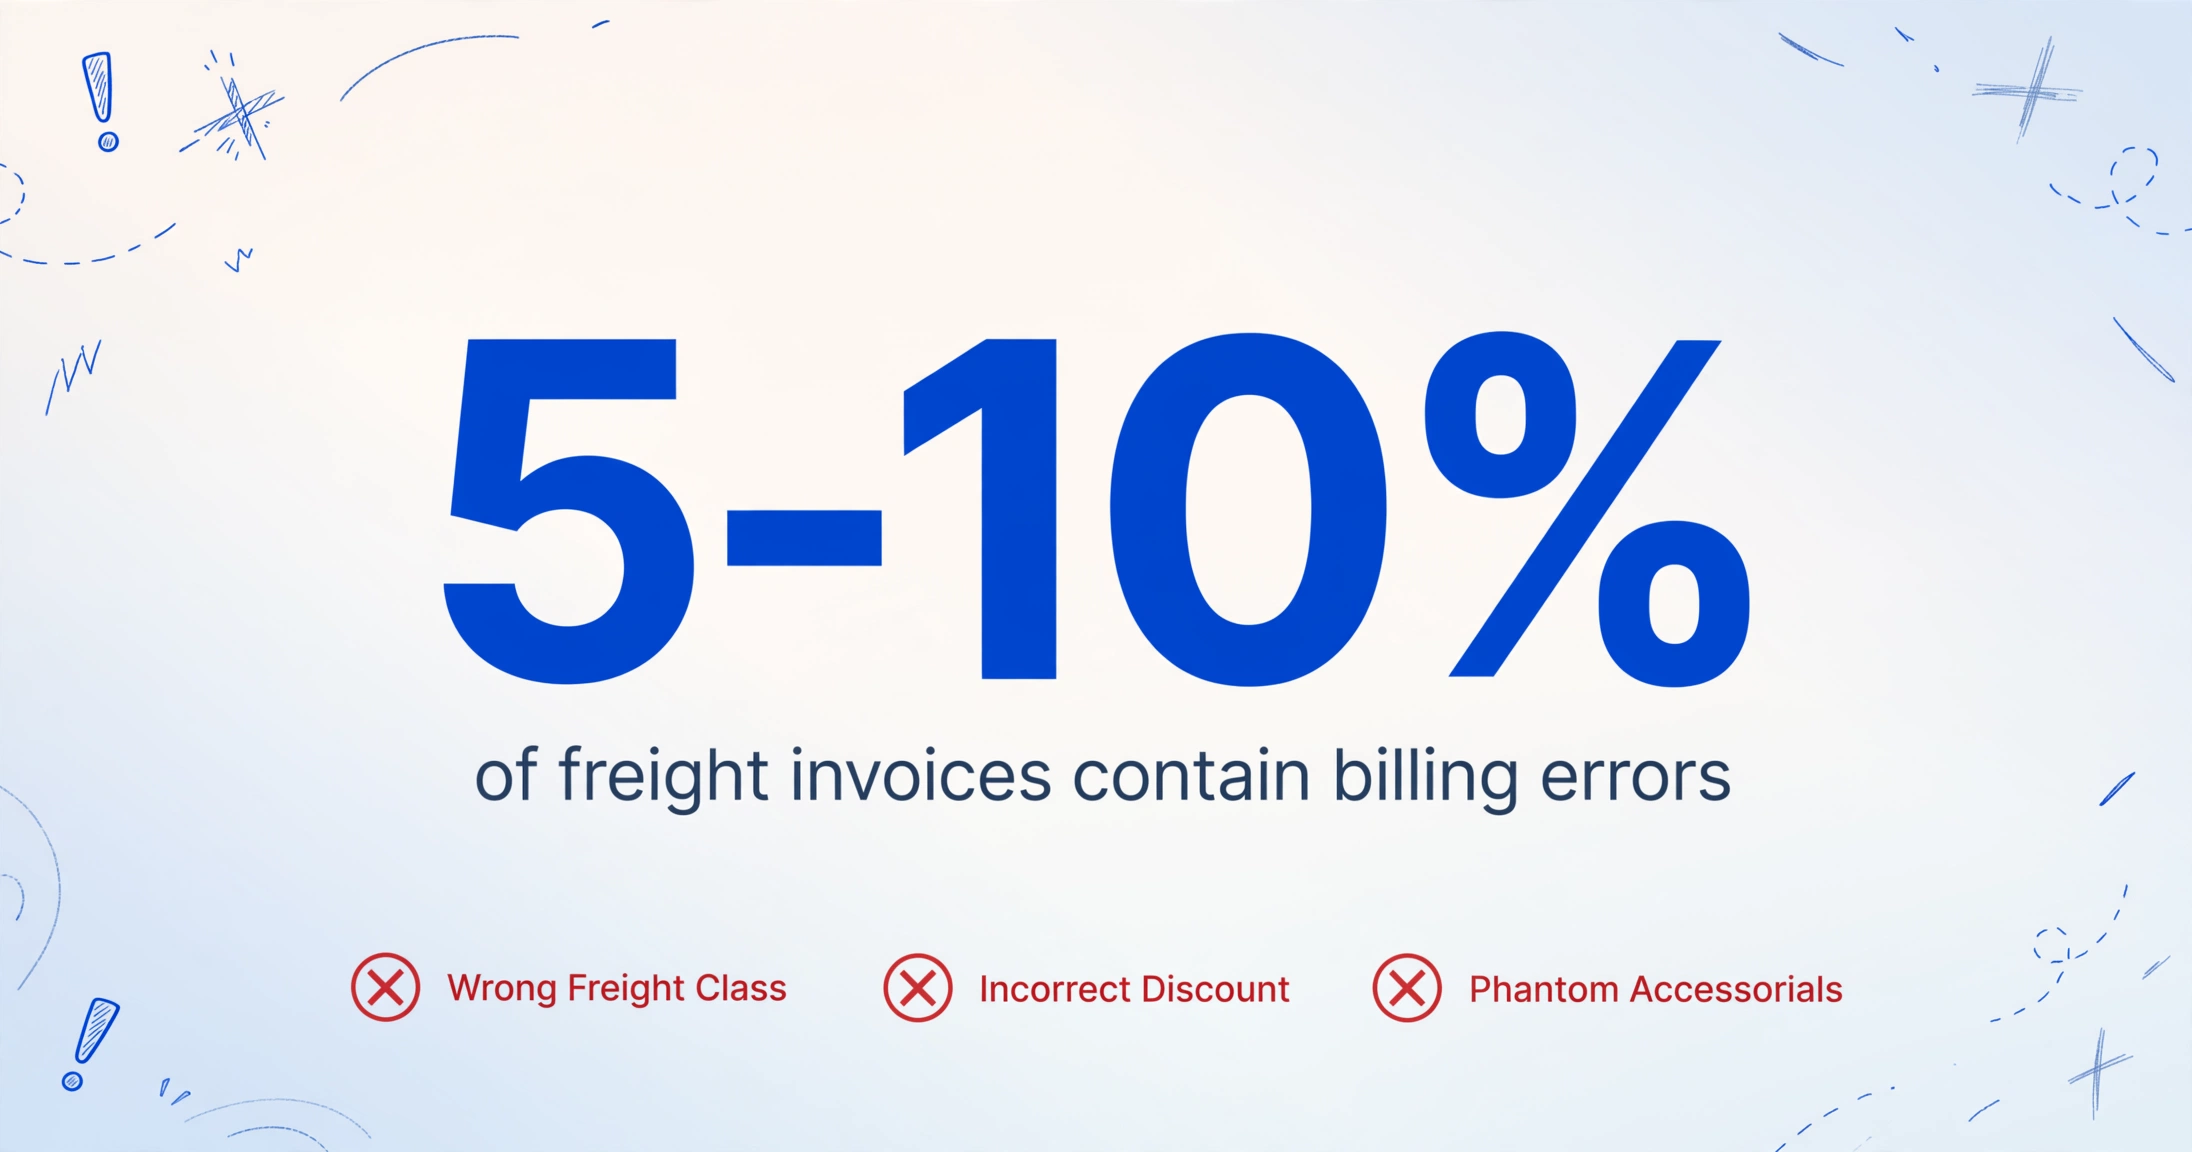
업계 추정치는 물류 재무 책임자라면 주목해야 할 범위로 수렴합니다. Warp의 화물 감사 분석에 따르면 오류율은 운송장의 5-10%입니다. Shipware의 데이터는 화물 운송장의 약 25%에 어떤 형태로든 오류가 포함되어 있음을 시사합니다. Transportation Insight는 일반적인 감사에서 조사된 운송장의 3-6%에 오류가 포함되어 있으며, 대부분의 오류가 부가 요금이나 잘못 적용된 할인에서 비롯된다는 사실을 발견했습니다. 이러한 수치의 차이는 서로 다른 방법론(표본 감사 대 체계적 검토, LTL 대 트럭 적재, 소형 화물 대 화물)을 반영하지만, 모든 출처에서 일관되게 발견되는 사실은 운송업체 청구 오류가 수동 프로세스에서 체계적으로 과소 탐지된다는 것입니다.
오류는 예측 가능한 범주로 나뉩니다. 즉, 체계적 검토가 규모에 맞게 실용적이라면 충분히 잡아낼 수 있을 만큼 예측 가능하다는 뜻이기도 합니다:
- 잘못된 화물 등급. NMFC 등급 70(밀도 15-22.5 lbs/cu ft)으로 선적된 상품이 픽업과 청구 사이에 등급 85(12-15 lbs/cu ft)로 재분류됩니다. 100파운드당 운임이 인상되며, 누군가 선하증권(BOL)과 운송장을 대조하지 않는 한 초과 청구는 그대로 남습니다. National Motor Freight Traffic Association의 18등급 체계(등급 50(밀도 높음, 운임 저렴)부터 등급 500(가벼움, 운임 비쌈)까지)는 두 등급만 이동해도 단일 선적의 운임이 15-25% 변동될 수 있음을 의미합니다.
- 잘못된 할인 적용. 계약상 500마일 미만 구간에 대해 운송업체 운임표 요율의 72% 할인이 명시되어 있지만, 운송장에 적용된 할인 등급은 68%입니다. 이는 청구 시스템이 더 낮은 등급을 기본값으로 설정했거나, AP 담당자가 운임 확인서를 확인하지 않고는 파악할 수 없는 주행 거리 기준을 선적이 초과했기 때문일 수 있습니다.
- 서비스가 제공되지 않았는데 청구된 부가 요금. 로딩 독으로 배송된 건에 리프트게이트 요금이 청구됩니다. 상업용 주소에 주거지 할증료가 적용됩니다. 운전자가 현장에 45분 있었는데 대기 시간이 2시간으로 청구됩니다. 이러한 오류는 운송장만으로는 검증이 불가능하며, 배송 영수증, 선하증권(BOL), 때로는 운송업체 자체 추적 데이터를 교차 참조해야 합니다.
- 잘못된 지수 또는 주를 기준으로 계산된 유류 할증료. 운송업체 청구 시스템이 선적일 기준 적용 요율 대신 지난주 할증료를 적용합니다. 그 차이는 일반적으로 기본 운임의 0.5-1.5%로, 총액 검사로는 발견하기 어려울 만큼 작지만 수백 건의 선적에 걸쳐 누적될 만큼 큽니다.
- 중복 운송장. 운송업체가 재제출하거나 시스템 오류로 사본이 생성됩니다. 운송장 번호를 지불 내역과 대조하지 않으면 일부 운송장이 두 번 지불됩니다. STB Freight의 감사 분석에 따르면 이는 대부분의 화주가 생각하는 것보다 더 흔합니다.
이러한 오류들은 모두 라인 항목 수준에서 발생합니다. 총액 비교 방식, 즉 "송장에 $847.32로 나와 있고 견적은 $820이었으니 대충 비슷하네"라고 판단하는 것은, 있어서는 안 될 부가 요금, 잘못 재정의된 화물 등급, 잘못된 주의 지수를 사용한 유류 할증료를 놓치게 만듭니다. 이를 잡아내는 유일한 방법은 라인 수준 검증, 즉 송장의 모든 요금을 해당 출처 문서와 대조하는 것입니다. 월 500건의 화물 운송장을 처리하고 각 운송장에 8~12개의 요금 라인이 있는 화주라면, 이는 4,000~6,000건의 개별 라인 수준 비교에 해당합니다. 수동 감사 프로세스는 이러한 작업량을 감당하지 못해 감사를 생략하지만, 자동화된 프로세스는 즉시 처리합니다.
STB Freight는 기업들이 체계적인 감사 프로세스를 도입한 후 총 화물 지출의 3~8%를 초과 지불하고 있음을 일반적으로 발견한다고 추정합니다. 연간 화물에 100만 달러를 지출하는 기업의 경우, 이는 회수 가능한 초과 청구액 $30,000~$80,000에 달합니다. 수동 조정은 이러한 초과 청구를 수개월 또는 수년 동안 감지하지 못한 채 승인해 왔던 것입니다.
하나의 요금을 검증하려면 네 가지 문서를 확인해야 합니다
운송에서 "운임"이라는 단어는 하나의 숫자가 아니라 하나의 범주입니다. 화물 운송장을 조정할 때 여러분은 하나의 운임을 하나의 계약과 대조하는 것이 아닙니다. 각각 고유한 출처가 있고 서로 독립적으로 변경될 수 있는 여러 운임 차원을 확인하는 것입니다:
차선, 중량, 등급별 계약 운임. 운송사 계약서는 출발지-목적지 쌍에 대한 100파운드(CWT)당 운임을 명시하며, 중량 구간(0-500lbs, 501-1,000lbs, 1,001-2,000lbs 등) 및 NMFC 화물 등급별로 세분화됩니다. 단일 차선에는 수십 가지의 유효한 운임 조합이 있을 수 있습니다. 송장에 올바른 조합이 적용되었는지 확인하려면 계약 운임표를 참조하고 차선, 중량, 등급의 세 가지 변수를 송장과 대조해야 합니다. 이 조회는 종이로는 30초면 끝나지만, 수백 개의 라인 항목에 걸쳐 반복되면 조정 시간의 대부분을 차지합니다.
스팟 견적 및 미니 입찰. 모든 화물이 계약 운임으로 운송되는 것은 아닙니다. 특정 차선과 특정 날짜에 제공되는 1회성 가격인 스팟 견적은 시장 수요와 공급에 따라 매일 변동됩니다. 미니 입찰과 분기별 RFP는 연간 계약의 일부를 대체하거나 중첩시키는 운임표를 생성합니다. 스팟 견적으로 운송된 화물은 마스터 계약이 아닌 운임 확인서 이메일과 대조하여 검증해야 합니다. 해당 이메일이 받은 편지함에 묻혀 있거나 공유 드라이브에 PDF로 저장된 경우, 검증 단계는 수학적 확인이 되기 전에 문서 검색 작업이 되어 버립니다.
매주 변경되는 유류 할증료 표. 미국 에너지정보청(EIA)은 매주 월요일 전국 경유 가격을 발표합니다. 운송사는 이에 따라 유류 할증료 비율을 업데이트합니다 — 일반적으로 오너-운전자 독립 운전자 협회(OOIDA)의 표준 공식에 따라 기준선 대비 경유 가격이 6센트 오를 때마다 마일당 1센트를 추가합니다. 목요일에 픽업된 화물은 다음 주 화요일에 픽업된 화물과 다른 할증료가 적용됩니다. 월말에 운송장을 대조하는 AP 담당자는 각 화물 날짜에 적용되는 주간 할증료율이 무엇인지, 그리고 운송사의 청구 시스템이 올바른 요율을 적용했는지 알아야 합니다. 규모가 커지면 이는 검증 작업이 아니라 정밀 조사 작업입니다.
최소 운임 등급 및 최저 요금. 많은 LTL 계약에는 최소 운임 조항이 포함됩니다 — 실제 화물 중량과 관계없이 청구되는 최소 중량입니다. 75파운드를 운송해도 계약에 200파운드 최소 중량이 있으면 200파운드에 대한 요금을 지불하게 됩니다. 운송장에는 이 항목이 별도 라인으로 표시되지 않으며, 계약된 CWT 요율로 예상보다 높은 요금만 표시됩니다. 해당 구간과 해당 운송사에 대한 특정 최소 중량 조항을 알지 못하면 초과 청구는 눈에 보이지 않습니다.
운송사별 코드가 있는 부가 요금표. 각 운송사는 요율 계약과 별도 문서로 존재하는 부가 요금표 — 서비스 및 수수료 목록 — 를 게시합니다. 동일한 서비스(주거지 배송)가 A 운송사에서는 $85, B 운송사에서는 $110일 수 있으며, C 운송사는 이를 "비상업 배송"이라고 부르며 $95를 청구할 수 있습니다. 단일 부가 요금을 검증하려면 요율 계약과 같은 폴더에 없을 수 있는 문서를 확인해야 합니다 — 팀이 해당 운송사의 부가 요금표를 정리된 디지털 사본으로 보유하고 있는 경우에 한해서입니다.
이는 프로세스 실패가 아닙니다. 화물 운송장 검증에 필요한 모든 정보를 담은 단일 문서가 존재하지 않는 업계의 자연스러운 결과입니다. 운임 확인서는 이메일에 있습니다. 유류 할증료 표는 EIA 웹사이트에 있습니다. 부가 요금표는 운송사 포털의 PDF에 있습니다. 실제 중량, 화물 등급, 수행된 서비스를 확인하는 선하증권(BOL)은 TMS 또는 공유 받은 편지함에 있습니다. 화물 운송장 대조는 핵심적으로 문서 집계 문제입니다. 산술은 사소합니다. 산술에 사용할 숫자를 찾는 것이 작업입니다.
왜 가장 뛰어난 감사 담당자도 30일 오후 4시 30분이 되면 업무를 멈추는가
매월 말 물류 재무 부서에서는 특정한 순서로 업무가 진행됩니다. AP 팀은 먼저 제품 인보이스를 조정합니다. 이는 비교적 간단해서 PO 시스템이 대부분의 매칭을 처리하고 예외 사항도 관리 가능합니다. 그다음 운영 비용(임대료, 공과금, 구독 서비스)이 옵니다. 이는 모두 연간 한 번 정도만 변경되는 계약서와 대조해 검증합니다. 그다음 은행 잔액 조정으로 현금 포지션을 마감합니다. 화물 운송장이 처리 순서의 맨 위에 도달할 즈음에는 마감 주기의 마지막 48~72시간이 남아 있습니다. 총계정원장을 잠가야 하고 재무 보고서 제출 기한이 다가옵니다. 유류 할증료를 검증하는 데 한 시간을 쓰는 것은 장부 마감에 한 시간을 쓰지 못하는 것을 의미합니다.
이러한 환경에서 화물 조정은 감사가 아닌 분류 작업이 됩니다. AP 담당자는 인보이스를 금액별로 분류하고 가장 큰 금액의 건을 확인합니다. 월 200만 달러의 화물 지출 규모에서 500달러, 300달러 등 심리적 기준선 아래에 있는 인보이스는 총액만 확인하고 승인합니다. 이러한 "소액" 인보이스의 초과 청구(존재해서는 안 되는 45달러의 부가 요금, 28달러의 유류 할증료 계산 오류)는 발견되지 않습니다. 개별적으로는 무시할 만한 수준이지만 500건의 인보이스 전체로 보면 그렇지 않습니다.
여기서 중요한 것은 심리적 측면입니다. 이는 역량의 문제가 아니기 때문입니다. 제품 인보이스 조정에서 0.02달러의 반올림 오류를 잡아내는 동일한 AP 담당자가 85달러의 유령 부가 요금이 포함된 화물 운송장을 승인할 수 있습니다. 덜 주의를 기울여서가 아니라 화물 운송장은 제품 인보이스와는 다른 종류의 검증 작업을 요구하고, 월말 일정에는 화물 특화 검증을 위한 추가 시간이 주어지지 않기 때문입니다. 이 작업은 대기열의 맨 마지막에 도착하고 시간 예산은 이미 소진되어 있습니다. HighRadius의 2026년 월말 마감 분석에 따르면 마감 오류의 88%는 수동 데이터 입력에서 발생합니다. 이는 인간의 무능력 때문이 아니라 가장 복잡한 수동 작업을 가장 좁은 시간 창에 집중시키는 프로세스 설계 때문입니다.
이러한 순서는 임의적이지 않습니다. 화물 조정이 마지막에 오는 이유는 이 단계가 가장 늦게 도착하는 데이터에 의존하기 때문입니다. 운송업체 인보이스는 월 전체에 걸쳐 들어오며, 운송업체가 청구를 일괄 처리하는 마지막 주에 급증합니다. 받지 않은 것은 조정할 수 없습니다. 그러나 구조적으로 볼 때 가장 세심한 라인별 검토가 필요한 인보이스가 검토 여력이 가장 부족한 시점에 도착하는 결과가 발생합니다.
월말 마지막 날 오후 4시 30분에 승인된 화물 운송장은 12개 라인 항목을 모두 검증했기 때문에 승인된 것이 아닙니다. 마감을 지연시키는 비용이 놓칠 수 있는 초과 청구보다 더 크기 때문에 승인된 것이며, 현장의 모든 사람이 이를 알고 있습니다.
데이터 추출이 병목이 아닐 때 달라지는 것
핵심 문제가 화물 운송장 데이터가 너무 많은 곳에 흩어져 있다는 것이라면 — 호환되지 않는 CSV를 제공하는 캐리어 포털, 이메일로 받은 PDF, 지역 캐리어의 종이 청구서 — 그리고 월말 일정상 이를 하나의 검증 스프레드시트로 모을 시간이 없다면, 병목은 감사 로직이 아닙니다. 감사 이전 단계, 즉 형식이나 캐리어와 관계없이 모든 화물 운송장에서 구조화되고 비교 가능한 데이터를 추출하는 단계가 병목입니다.
바로 여기서 기존 자동화 경로 — EDI 통합, 캐리어 API 연결, TMS 기반 자동 매칭 — 가 확장의 한계에 부딪힙니다. EDI 연결은 거래 파트너마다 비용이 듭니다. 10개 캐리어와 거래하는 화주는 10개의 EDI 설정이 필요하며, 그중 최소 2개 캐리어는 EDI를 전혀 지원하지 않습니다. 계약 운임과 송장 라인을 자동 매칭할 수 있는 TMS도 시작부터 깨끗하고 구조화된 송장 데이터가 필요합니다. 많은 화주에게 그 데이터는 여전히 받은 편지함의 PDF 첨부 파일에서 시작됩니다.
통합에서 추출을 분리하면 경제성이 달라집니다. 캐리어마다 캐리어-시스템 연결이 필요하고, 이는 수개월이 걸리고 수만 달러가 들 수 있는 통합 프로젝트인 반면, 추출은 문서 수준에서 이루어집니다. 화물 운송장이 PDF 또는 캐리어 포털 스크린샷으로 도착합니다. AI 추출 엔진은 인간 AP 담당자가 하는 방식대로, 각 요금 라인이 페이지에서 어디에 있는지가 아니라 무엇을 의미하는지 이해하여 읽습니다. 기본 운임, 유류 할증료, 리프트게이트, 체선료, 실내 배송 — 각각이 어떤 캐리어가 송장을 보냈는지, 해당 캐리어가 특정 부가 요금에 어떤 코드를 사용했는지와 관계없이 스프레드시트의 자체 열로 추출됩니다.
이것이 ImageToTable.ai가 맞춤 열 추출이라고 부르는 메커니즘의 배경입니다. 송장 번호, 캐리어 이름, 선적일, 기본 운임, 유류 할증료, 리프트게이트, 체선료, 주거지 배송, 기타 부가 요금, 송장 합계 등 필요한 열을 정의하면 AI가 템플릿에서의 위치가 아닌 요금의 의미론적 의미를 이해하여 각 송장에서 각 값을 찾습니다. 캐리어가 "FSC", "Fuel", "Diesel Surcharge" 또는 "Energy Recovery Fee"로 표시하든 유류 할증료는 여전히 유류 할증료입니다. 추출 엔진은 라벨이 아닌 개념을 인식하고 값을 미리 정의된 열에 배치합니다.
결과물은 모든 캐리어의 송장이 동일한 열 구조로 정리된 단일 스프레드시트입니다. 운임표, 유류 할증료 참조, 부가 요금 검증 규칙을 8가지 다른 CSV 스키마 대신 일관된 데이터 세트에 적용할 수 있습니다. 동일한 접근 방식은 단일 처리 세션에서 수백 개의 송장에 대한 배치 송장 데이터 추출로 확장됩니다. 감사가 시작되기 전에 모든 캐리어의 모든 요금이 한곳에 모입니다. 이는 감사 필요성을 없애지 않습니다. 입력의 필요성을 없앱니다. 그리고 이 차이는 AP 팀이 주당 15-20시간의 조정 시간을 데이터 입력이 아닌 실제 검증에, 숫자 옮겨 적기가 아닌 계약서와의 비교에, 형식과의 싸움이 아닌 초과 청구 발견에 사용하게 한다는 점에서 중요합니다.
화물 운송장의 5-10% 오류율은 감사가 어렵기 때문에 존재하지 않습니다. 감사가 가능한 형식으로 데이터를 만드는 데 사용 가능한 모든 시간이 소요되기 때문에 존재합니다. 추출이 소프트웨어 단계가 되면 — 송장당 5-10초, 수동 입력 10-15분 대신 — 시간 예산이 바뀝니다. 금액별로 분류하던 AP 팀은 이제 기본적으로 모든 라인을 확인할 수 있습니다. $300 송장에 있어 놓쳤던 초과 청구도 송장이 확인되었기 때문에 발견됩니다.
이는 TMS 통합이나 EDI가 viable한 경우에 반대하는 주장이 아닙니다 — 신뢰할 수 있는 API 피드를 가진 운송사는 항상 PDF보다 선호됩니다. 이는 통합된 운송사와 이메일을 사용하는 운송사 사이의 격차를 메우는 데 관한 주장입니다. 대부분의 중간 시장 화주에게 그 격차는 운송사 기반의 대부분을 차지합니다. 이를 해결하는 데 운송사의 협력이 필요하지 않습니다. 운송사가 이미 보내는 문서에서 작동하는 추출이 필요합니다 — 어떤 형식으로 보내든 상관없습니다.
자주 묻는 질문
수동 화물 운송장 검토는 인보이스당 실제로 얼마나 걸리나요?
중간 시장 AP 팀은 Nuvocargo의 2025년 물류 AP 분석에 따르면 주당 15-20시간을 화물 운송장 검토에 소비한다고 보고합니다. 일반적인 처리 속도가 시간당 4-6건일 때 — 포털 로그인, 데이터 추출, 운임 대조, 분쟁 후속 조치를 포함 — 각 인보이스는 직원 시간 10-15분을 소요합니다. 월 500건의 인보이스를 처리하는 화주에게 이는 83-125시간의 노동이 주로 검증에 가치가 있는 프로세스에 투입되는 것입니다.
TMS가 화물 운송장을 자동 매칭하지 못하는 이유는 무엇인가요?
대부분의 TMS 플랫폼 — Oracle Transportation Management, SAP TM, MercuryGate, BluJay — 은 인보이스 매칭 모듈을 포함하지만, TMS가 처리할 수 있는 구조화된 형식으로 인보이스 데이터가 도착해야 합니다. 운송사 인보이스가 PDF로 도착하면 TMS는 원래 형식으로 읽을 수 없습니다. 매칭 로직은 또한 TMS에 정확하고 완전한 선적 데이터가 있어야 합니다 — TMS 외부에서 예약된 선적(스팟 이동, 회사 간 이전, 공급업체가 관리하는 인바운드 화물)에 해당 기록이 없으면 매칭 엔진은 매칭할 대상이 없습니다. 데이터 품질 문제는 자동화 문제보다 먼저 발생합니다.
화물 운송장에서 가장 흔히 놓치는 초과 청구는 무엇인가요?
서비스가 수행되지 않았는데 청구되는 부가 요금 — 도크 배송의 리프게이트 수수료, 상업 주소의 주거 할증료, 부정확한 시간으로 청구되는 정박료. 이러한 오류는 수동 프로세스에서 감지하기 가장 어렵습니다. 운임 계약서뿐만 아니라 배송 영수증 또는 운송사 추적 데이터를 인보이스와 대조해야 하기 때문입니다. 그러한 대조가 없으면 청구는 합법적으로 보입니다. 대조가 있으면 초과 청구는 모호함이 없습니다.
화물 운송장 청구 오류는 의도적인가요?
대부분은 그렇지 않습니다. 운송사 청구 시스템에는 오래된 운임표, 잘못 적용된 할인 등급, 대규모 데이터 입력 오류가 포함되어 있습니다 — 이는 대량 청구 운영이 직면하는 일반적인 문제입니다. 비대칭성은 운송사 청구 오류가 운송사에 유리하게 작용한다는 점입니다(과다 청구가 과소 청구보다 더 흔함). 또한 화주가 오류를 발견해야 하는 부담을 지게 됩니다. 인센티브 구조는 오류가 적발될 때만 정확한 청구를 운송사에 보상합니다. 수동 프로세스가 오류의 일부만 적발할 때, 청구 정확성을 높이는 피드백 루프는 약해집니다.
AI 추출이 화물 운송장 조정에서 실제로 얼마나 절약할 수 있나요?
직접적인 절감은 두 가지 원천에서 발생합니다: 노동 시간 절감(운송장당 수동 데이터 입력 10-15분을 AI 추출 5-10초로 대체)과 과다 청구 환수(체계적 감사가 일반적으로 식별하는 화물 지출의 3-8%를 포착). 연간 화물에 100만 달러를 지출하는 기업의 경우, 과다 청구 환수만으로 연간 30,000~80,000달러에 달합니다 — 더 높은 가치의 업무에 투입할 수 있는 AP 시간을 제외한 수치입니다. 노동 절감은 물량에 따라 달라집니다: 월 500장의 운송장을 처리하는 화주는 월 약 80-120시간의 AP 시간을 절약하며, 이는 BLS 중앙값 화물 대리인 임금 $23.24/시간 기준 월 $1,860~$2,790의 직접 노동 비용 절감에 해당합니다.
ImageToTable.ai가 제 TMS 또는 ERP와 통합되나요?
ImageToTable.ai는 화물 운송장 데이터를 구조화된 스프레드시트(Excel, CSV)로 추출하며, 파일 기반 데이터 업로드를 지원하는 모든 TMS 또는 ERP로 가져올 수 있습니다. 직접적인 API 간 TMS 통합은 제공하지 않습니다 — 출력물은 시스템으로 가져오는 파일이지, 실시간 데이터 피드가 아닙니다. TMS 또는 ERP가 운송장 데이터에 대한 CSV/XLSX 가져오기를 지원하는 팀에게 이는 운송사별 EDI 구축 없이 운송사 PDF와 시스템 매칭 사이의 실용적인 다리를 제공합니다.
화물 운송장을 업로드하세요. 열을 정의하세요. 라인 항목이 자동으로 채워지는 것을 확인하세요.